

গত চব্বিশ ঘণ্টা ধরে সিলিকন ভ্যালি মেতে আছে এআই গবেষক নিক ক্যামারাটার প্রায় ২৬ হাজার শব্দের একটি ব্লগপোস্ট নিয়ে। কেউ বলছেন বছরের ‘সবচেয়ে গুরুত্বপূর্ণ প্রবন্ধ’, কেউ ‘সবচেয়ে গুরুত্বপূর্ণ গবেষণার ফল’, কেউ আবার ‘সবচেয়ে ভালো খবর’। প্রশংসার বহর এমন যে, বছরের গণ্ডি ছাড়িয়ে কথাটা এআই গবেষণার গোটা ইতিহাস পর্যন্ত গড়িয়েছে। কারও কারও উচ্ছ্বাস দেখে মনে হচ্ছে, ইতিহাসের সীমাটুকুও বোধ হয় রাখা যাবে না। স্যাম অল্টম্যানও লেখাটির প্রশংসা করেছেন।
ক্যামারাটা এআইয়ের প্রকৃতি নিয়ে একের পর এক সাহসী, প্রায় অবিশ্বাস্য দাবি তুলেছেন। দাবিগুলো সত্যি হলে, যে প্রযুক্তি গড়তে এই শিল্প এত ব্যস্ত, সেই প্রযুক্তি সম্পর্কে তার কয়েকটি মৌলিক ধারণাই ওলটপালট হয়ে যাবে। এখানে ‘সত্যি হলে’ কথাটা মনে রাখা জরুরি। সিলিকন ভ্যালিতে উচ্ছ্বাসের গতি বরাবরই যাচাইয়ের গতির চেয়ে একটু বেশি।
গত কয়েক মাস ধরে এআইকে ঘিরে একের পর এক হ্যাকিংয়ের ঘটনা আর প্রযুক্তিশিল্পের বিরুদ্ধে বাড়তে থাকা জনরোষের মধ্যে অনেকেই এই লেখায় আশার আভাস দেখছেন। পৃথিবীর হাতে যে প্রযুক্তি তুলে দেওয়া হচ্ছে, তাকে আরও ভালো করে বোঝা এবং নিয়ন্ত্রণে রাখার সম্ভাবনা নিয়ে ক্যামারাটা নতুন করে ভাবার সুযোগ দিয়েছেন। সেই আলোচনাটিই বাংলা পাঠকের কাছে পৌঁছে দিতে নিচে লেখাটির অনুবাদ রইল।
নিউরাল নেটওয়ার্ক আগে থেকেই পরিষ্কার
Neural Networks Are Already Clean
নিক ক্যামারাটা · Goodfire · 2026
বাংলা অনুবাদ · একটি পরীক্ষাধীন গবেষণা-ধারণা
সংস্করণ-সংক্রান্ত নোট: মূল পাঠের 67টি চিত্রবিবরণ অনুবাদ করা হয়েছে। সরবরাহ করা PDF-এ পাওয়া 32টি স্থির চিত্রও রাখা হয়েছে; কিছু ইন্টার্যাকটিভ চিত্র সেখানে ফাঁকা বা অসম্পূর্ণ ছিল। চিত্রের ভেতরের মূল ইংরেজি লেবেল অপরিবর্তিত আছে।
পড়ার সফটওয়্যার ও AI এজেন্টের জন্য প্রবন্ধটির সাধারণ টেক্সট সংস্করণ। ছবিগুলোর বিবরণ দেওয়া আছে বন্ধনীর মধ্যে; ইন্টার্যাকটিভ সংস্করণগুলো আছে ওয়েব পেজে।
শুরুর দিকের গবেষণায় নমুনা হিসেবে ব্যবহৃত মডেলগুলোতে বহুঅর্থকতার (polysemanticity) কারণ সুপারপজিশন (superposition) ছিল না। কারণ ছিল বেশ কিছু সাধারণ সমস্যা, যার অধিকাংশই ঠিক করা যায়। এখন কয়েক ট্রিলিয়ন পর্যন্ত প্যারামিটারের মডেলেও বেশির ভাগ নিউরন আমরা বুঝতে পারি। আর আমাদের মনে হচ্ছে, প্রক্রিয়াগত ব্যাখ্যাযোগ্যতার (mechanistic interpretability) ভবিষ্যৎ আমরা যতটা ভেবেছিলাম, তার চেয়ে অনেক উজ্জ্বল হতে পারে।
Nick Cammarata · Goodfire

একটি শহর বনাম একটি জট (শিরোনামের অ্যানিমেশন)।
সংক্ষেপে
নিউরাল নেটওয়ার্কের স্বভাব নিয়ে আমার কাছে একটা ভালো খবর আছে বলেই মনে হচ্ছে।
বহু মাস ধরে ছবি ও ভাষার মডেলগুলোর নিউরন আর সার্কিট ঘেঁটে আমার বিশ্বাস হয়েছে, নেটওয়ার্কের নিজের কাজ করার প্রক্রিয়াগুলোই তার বোধগম্য গাঠনিক উপাদান। আর প্রক্রিয়াগত ব্যাখ্যাযোগ্যতার ভবিষ্যৎ নিয়ে আমার যে আশঙ্কা ছিল, বাস্তব ছবিটা তার চেয়ে অনেক ভালো হতে পারে। বহুঅর্থকতা আর সুপারপজিশনের যেসব বহুলস্বীকৃত প্রমাণ দেখে আমি-সহ এই ক্ষেত্রের অনেকেই বিশ্বাস করেছিলাম যে নেটওয়ার্ক খেয়ালখুশিমতো ধারণা গুঁজে রাখে, সেসব প্রমাণ আমরা ভুল পড়েছিলাম। যাকে এলোমেলোভাবে গুঁজে রাখা মনে হচ্ছিল, তার বেশির ভাগই আসলে একটা পুনরাবৃত্ত গঠনধারা। আমি একে বলব পুনরাবৃত্ত সাধারণীকরণ (recursive generalization), যা নিয়ে দুশ্চিন্তার কারণ অনেক কম। এর মানে, নেটওয়ার্ক নিয়ে পড়াশোনা শুরু করার আগে তার জট ছাড়াতে হবে না; আমরা সরাসরি তাকে নিয়েই কাজ করতে পারি। নিউরাল নেটওয়ার্ক আগে থেকেই গোছানো।
প্রক্রিয়াগত ব্যাখ্যাযোগ্যতা নিয়ে এগোনোর অন্তত দুটো পথ আছে। প্রথমটি হলো নেটওয়ার্ককে নিয়েই দ্রুত স্বাভাবিক বৈজ্ঞানিক গবেষণা চালানো: তার নিউরন আর সার্কিট দেখা, তাদের সম্পর্ক বোঝা, তাদের মধ্য দিয়ে ডেটা কীভাবে যায় তা লক্ষ করা, আর ব্যাখ্যাগুলো যাচাই করতে এজেন্টের সাহায্যে বিপুল পরিসরে পরীক্ষা চালানো। দ্বিতীয় পথে শুরুতেই সম্ভাব্য ফিচারগুলোর (feature) একটি তালিকা ধরে নেওয়া হয়, তারপর সবগুলোকে বের করে আনার চেষ্টা চলে। এ জন্য নেটওয়ার্ককে পুনর্গঠনের লক্ষ্য ক্রমেই আরও জটিলভাবে সাজানো হয়, আর মূল নেটওয়ার্কটি সাধারণত আড়ালে পড়ে থাকে।
এই গবেষণার শুরু প্রথম পথ ধরেই। পরে দ্বিতীয় পথে সরে আসতে হয়, কারণ নিউরাল নেটওয়ার্ককে মনে হচ্ছিল জটপাকানো গিঁট। বহুঅর্থক নিউরনের কিছু বহুলস্বীকৃত উদাহরণ ছিল আমাদের সামনে। এই নামটা মোটামুটি এমন নিউরনের জন্য ব্যবহার করা হয়, যাকে দেখে মনে হয় সে সম্পর্কহীন একাধিক কাজ করে, কিংবা যাকে বোঝাই অসম্ভব ঠেকে। সবচেয়ে বিখ্যাত উদাহরণটি ছিল একটি ছবির মডেলে: একই নিউরন বিড়ালের মুখ আর গাড়ির সামনের অংশ, দুটোতেই সাড়া দিত। আর এই ক্ষেত্রের শুরুর দিকের পরীক্ষার নমুনা InceptionV1-এর শেষ স্তরটায় এমন সব এলোমেলো মিশ্রণ দেখা যেত যে সেটা নিয়ে কীভাবে পড়াশোনা করতে হবে, তা-ই স্পষ্ট ছিল না। প্রায় কোনো নিউরনকেই সহজে ব্যাখ্যা করা যেত না।
বহুঅর্থকতার প্রধান ব্যাখ্যা ছিল সুপারপজিশন। এতে শেখার একটি নতুন নীতির কথা বলা হয়েছিল: নিউরাল নেটওয়ার্কের হাতে আর নিউরন না থাকলে সে সম্পর্কিত বিষয়গুলোকে একসঙ্গে রাখা বন্ধ করে দেয়। তার বদলে সম্পর্কহীন বিষয়গুলোকে ভাঁজ করে একসঙ্গে রাখতে শুরু করে, শুধু এই কারণে যে তারা একে অন্যের কাজে বাধা দেয় না। এতে তৈরি হয় এক ধরনের জট। নেটওয়ার্ক প্রায় সমান ভালো আরও বহু উপায়েই ভাঁজ করতে পারত, তাই কোন কোন বিষয়কে একটি নিউরন একসঙ্গে রেখেছে, তা দেখে তেমন কিছুই জানা যায় না। কিছু নিয়ে গবেষণা করতে হলে আগে সেই জট খুলতে হবে। বাস্তবে এর মানে হলো দ্বিতীয় একটি মডেল প্রশিক্ষণ দেওয়া, যেমন স্পার্স অটোএনকোডার (SAE) দিয়ে নেটওয়ার্ককে ভেঙে আলাদা উপাদানে সাজানো। জট খোলা অবস্থায় নেটওয়ার্কটি কেমন দেখাত, তার একটা আনুমানিক রূপ তৈরি করে সেটাই অধ্যয়ন করা। নেটওয়ার্কে সত্যিই এমন জট থাকলে এর বিকল্প হয়তো নেই।
আমাদের একটি প্রধান ফল হলো, InceptionV1-এর ক্ষেত্রে সুপারপজিশন ছিল ভুল ব্যাখ্যা। স্থাপত্যের সমস্যায় পরের দিকের স্তরগুলো ধারণক্ষমতার বাইরে ছড়িয়ে পড়ছিল। ব্যাখ্যা করার দুর্বল সরঞ্জাম সেই সমস্যাকে আরও বড় করে দেখাচ্ছিল, ফলে শেষের স্তরগুলোকে অসংলগ্ন মনে হচ্ছিল। এর পর থেকে গভীর স্তরগুলোকে ভালোভাবে শেখানোর জন্য স্থাপত্যে যেসব পরিবর্তন আনা হয়েছে, তার অনিচ্ছাকৃত একটি সুফল হলো, সেগুলোকে ব্যাখ্যা করাও সহজ হয়েছে। প্রথম যখন InceptionV1 নিয়ে কাজ করি, শেষ স্তরে ব্যাখ্যা করা যায় এমন নিউরন প্রায় পাইইনি। অথচ এই সাধারণ উন্নতিগুলো করলে, মডেলের আকার বা প্রশিক্ষণের ডেটা একটুও না বদলিয়েই, সেই শেষ স্তরের 99-100% নিউরন সহজে ব্যাখ্যা করা যায়। মোটের ওপর পুরো মডেলটিই শুরু থেকে শেষ পর্যন্ত পড়ে বোঝা যায়। একেবারে মামুলি নয় এমন নিউরাল নেটওয়ার্কের মধ্যে এটিই প্রথম, যেটার বেশির ভাগ আমি বুঝি বলে মনে হয়; এখানে ঘুরে দেখতে পারেন। আকারে 300× ব্যবধানজুড়ে এর কয়েকটি সংস্করণ প্রশিক্ষণ দিয়েছি, আর সব আকারেই মোটের ওপর একে বোঝা যায়। জায়গা কম থাকলে নেটওয়ার্ক সম্পর্কহীন বিষয়গুলো ভাঁজ করে একসঙ্গে রাখে না; তার নিউরনগুলো শুধু আরও মোটা দাগের ধারণা ধরে। যেমন একটি গাড়ির নিউরনই অনেক রকম গাড়িকে ধরে। জায়গা বাড়লে সেই নিউরন আরও নির্দিষ্ট নানা গাড়ির নিউরনে আলাদা হয়ে যায়। কাজেই সমস্যাটা শেখার দ্বিতীয় কোনো নীতির উপস্থিতি ছিল না। প্রথম নীতি অনুযায়ী শিখতে গিয়ে সাধারণ একটা ব্যর্থতা ঘটছিল, আর সেটা ঠিক করাও সহজ।
ছবির মডেলে বহুঅর্থকতা আর সুপারপজিশনের বহুলস্বীকৃত উদাহরণগুলোতেও ভুল ছিল। 2019 সালে ক্রিস ওলাহ আর আমি সেই সার্কিটটি খুঁজে পাই, যাকে Zoom In[4]-এ প্রথম সুপারপজিশনের ঘটনা হিসেবে তুলে ধরা হয়েছিল। সেখানে মনে হচ্ছিল, একটি গাড়ির ফিচার ছড়িয়ে যাচ্ছে সম্পর্কহীন একগুচ্ছ কুকুরের নিউরনে। আমরা এই একটিই দেখিয়েছিলাম, আর আমিও এমন এই একটিই দেখেছি। আমরা ভেবেছিলাম, নেটওয়ার্ক গাড়িটিকে উচ্চমাত্রিক এক গোপন জায়গায় রেখে দিচ্ছে, যাতে পরের নিউরনগুলো সেখান থেকে আবার তাকে উদ্ধার করতে পারে। কিন্তু ওই সম্মিলিত বিন্যাসটা কেউ পড়েই না। সেখানে কিছু লুকানো হচ্ছিল না; সাধারণ সাধারণীকরণ আর সংযোজন (composition) ঘটছিল। আমার জানা মতে, প্রয়োজনীয় গঠনের দ্বিতীয় কোনো সার্কিট কেউ প্রকাশ করেননি।
আধুনিক ভাষার মডেলগুলোও সাধারণভাবে যতটা ভাবা হয়, তার চেয়ে অনেক বেশি ব্যাখ্যাযোগ্য। Anthropic-এর Towards Monosemanticity[10] (2023) গবেষণায় এক স্তরের একটি ছোট মডেল নিয়ে কাজ করা হয়েছিল। তাদের মূল্যায়নের মাপকাঠিতে নিউরনগুলোর মধ্যমা স্কোর ছিল সম্ভাব্য 14-এর মধ্যে 0। অর্থাৎ মূল্যায়নকারী কোনো অনুমানই দাঁড় করাতে পারেননি। OpenAI-এ আমি যে স্বয়ংক্রিয় ব্যাখ্যাযোগ্যতা প্রকল্প[8] শুরু করেছিলাম, সেখানেও 2023 সালেই আমাদের সবচেয়ে উদার মাপকাঠি অনুযায়ী প্রায় 1.7% নিউরনকে ব্যাখ্যাযোগ্য পাওয়া গিয়েছিল।
ভালো সরঞ্জাম আর আধুনিক মডেল নিয়ে দেখলে ছবিটা বেশ আলাদা। Qwen3-32B-এর প্রাথমিক নিরীক্ষায় আমাদের অনুমান, নিউরনের মেরুগুলোর প্রায় 90%-এর একটি মূল কাজ আছে, প্রায়ই তার সঙ্গে ছোটখাটো সম্পর্কিত কিছু শাখাও আছে; আরও প্রায় 7%-এর দুটো সম্পর্কিত কাজ আছে; আর মাত্র প্রায় 2-4% এখনও বোঝা যায়নি¹। ডেন্স আর মিক্সচার অব এক্সপার্টস (Mixture of Experts) মডেলের অবস্থা মোটামুটি একই রকম মনে হচ্ছে। Kimi K3-এর মতো কয়েক ট্রিলিয়ন পর্যন্ত প্যারামিটারের মডেলেও আমরা একই রকম ফল পেয়েছি; সঙ্গে প্রকাশিতব্য গবেষণাপত্রে সে বিষয়ে আরও বিস্তারিত থাকবে। এই শতাংশগুলো আসলে বহুমাত্রিক একটি ছবিকে কয়েকটি সংখ্যায় নামিয়ে আনে। আর ঠিক কত হবে, তা নির্ভর করে কোনটাকে “একটি বিষয়” বলবেন তার সীমা কোথায় টানছেন তার ওপর। যেমন দুই ভাষার ঘনিষ্ঠভাবে সম্পর্কিত বাগ্ধারাগুলোকে একসঙ্গে ধরবেন কি না। ব্যাখ্যাযোগ্যতার খুব বেশি কিছু এই প্রশ্নের ওপর নির্ভর করে বলে আমার মনে হয় না। তার চেয়ে অনেক জরুরি হলো, বিষয়গুলো আদৌ একই নিউরনে জায়গা পেল কেন।
¹ এই সংখ্যাটি নিয়ে একটু বলা দরকার: কতগুলো নিউরনের একটি কাজ আছে, সেই অনুপাত বদলায় দুর্বল সক্রিয়তাকে গণনায় ধরার সীমা, স্তরের গভীরতা, উপ-সার্কিটের ঘনত্ব আর কোনটাকে আপনি “একটি বিষয়” ভাবছেন, তার ওপর। দুর্বল সক্রিয়তার কতদূর পর্যন্ত দেখবেন, এখানে সেটা বড় ব্যাপার। নিচে দুর্বল সক্রিয়তা নিয়ে একটি অংশ আছে। এদিকে যত এগোনো হয়, সাধারণত “সম্পর্কিত বিষয়”-এর সংখ্যা তত বাড়ে; নিউরনটি বোধগম্য কোনো বিষয় যাচাই করছে কি না, সেই সিদ্ধান্ত ততটা বদলায় না। যেমন ট্রাম্পের নিউরনের দুর্বল সক্রিয়তায় MAGA টুপি আর তাঁর সঙ্গে সম্পর্কিত মানুষজন চলে আসে। টাইটানিকের নিউরনের দুর্বল সক্রিয়তায় আসে আরও সাধারণ সমুদ্রযাত্রার গল্প, কিংবা সেই যুগের বাষ্পীয় ইঞ্জিন ও অন্যান্য প্রযুক্তি। আরও একটি প্রশ্ন হলো, সক্রিয়তার পার্সেন্টাইলকে গুরুত্ব দেবেন, নাকি সর্বোচ্চ সক্রিয়তার কত অংশ হচ্ছে তাকে। সাধারণভাবে আমার মনে হয়, নিউরন যা শিখেছে তার ওপর আস্থা রাখা উচিত: তার স্বাভাবিক বিরল সক্রিয়তা, সক্রিয়তার পরিসর ইত্যাদির ওপর। আগে কিন্তু আমি মোটের ওপর তা বিশ্বাসই করতাম না! সব নিউরনকে এক মাপে ফেলার চেষ্টার কিছুটা বিরোধী আমি। এখন পার্সেন্টাইল বেশি ব্যবহার হয়; আমার ধারণা, সেটা নিয়ে ভাবা সহজ বলেই। উল্টোটাও ঘটে। যেমন টাইটানিকের নিউরনের “সম্পর্কহীন কাজগুলো” দেখলে প্রায়ই দেখা যায়, সেটি আসলে বুঝছে যে এর পরের শব্দটি হবে “boat”। সরঞ্জামটি এটা ধরতে পারেনি, কারণ প্রসঙ্গ বিচার করার সময় সে শুধু পেছনের দিকেই তাকিয়েছিল। এই “সম্পর্কহীন কাজগুলো” আমরা খুঁটিয়ে দেখলে প্রায় সব সময়ই এমন কিছু একটা বের হয়। খুঁত আছে এমন সরঞ্জাম বানিয়ে ফেলা খুবই সহজ। সব মিলিয়ে একটি মাত্র স্কোরে পৌঁছানো আসলে খুব জরুরি বলে আমার মনে হয় না। কিন্তু সংখ্যাটি বাদ দেওয়ার পর শুরুর দিকের পাঠকেরা বলেছিলেন, মোটামুটি একটা সংখ্যা পর্যন্ত না থাকলে তাঁরা কোনো দিশা পাচ্ছেন না। যে সেটগুলো আমি আরও খুঁটিয়ে দেখেছি, সেখানে শক্তিশালী সক্রিয়তাগুলো বিবেচনায় নিলে, ইচ্ছেমতো তৈরি নয় এমন মিশ্রণের হার 97%-এর কাছাকাছি। তবে এই নমুনাগুলো তুলনামূলক ছোট। মোটের ওপর সবকিছুকে ছেঁকে একটি “গোছানো থাকার” স্কোর বানালে, সেটিকে নিউরাল নেটওয়ার্কের সামগ্রিক অবস্থার একটি মোটা ইঙ্গিত হিসেবেই নেওয়া উচিত। সরাসরি বাড়িয়ে তোলার লক্ষ্য হিসেবে বা আঁকড়ে ধরার মতো নির্ভুল কিছু হিসেবে নেওয়া উচিত নয়। এই প্রবন্ধের অনেকখানিই এই বহুমাত্রিক ছবিকে অতটা সংকুচিত না করার পক্ষে: প্রতিটি নিউরন আর সার্কিটকে তার গঠনধারা, গভীরতা, ভূমিকা ইত্যাদি অনুযায়ী আলাদাভাবে দেখা। তারপরও একটা মোটামুটি সংখ্যা কাজে আসতে পারে।
এর পরও যে আপাত বহুঅর্থকতা বাকি থাকে, তার বেশির ভাগই মনে হচ্ছে সেই গঠনধারা, যাকে আমি পুনরাবৃত্ত সাধারণীকরণ বলছি। ব্যাপারটা সহজ: নিউরন বড় হতে হতে তার থেকে নতুন শাখা বেরোয়, যেমন গাছের ডাল থেকে ছোট ডাল বেরোয়। যেমন একটি নিউরন “iy” শনাক্ত করত। বাড়তে বাড়তে সেটি “diy” শনাক্ত করতে শিখল, তারপর “do it yourself”, যার মধ্যে “iy” আছেই না। আমি যে Multimodal Neurons[3] (2021) গবেষণাপত্রে কাজ করেছিলাম, তার ভুলে যাওয়া একটি উপ-অংশে প্রথম এই ধারণাটি এসেছিল। তখন আমি প্রশিক্ষণের সময় নিউরনকে বড় হতে দেখিনি। এখন সেটা দেখা সহজ, আর আমি যেখানেই দেখেছি, এই ব্যাখ্যা মিলেছে। এমনকি আদি InceptionV1-ও জটপাকানো ছিল না। তার মূল স্থাপত্য নিয়ে আবার প্রশিক্ষণ দিলে এখনও গভীর স্তরগুলো অগোছালো হয়। কিন্তু সেখানে যতটা সম্ভব দুর্বোধ্য নিউরন খুঁজে তাদের গতিপথ অনুসরণ করলে দেখা যায়, তারা আশপাশের যুক্তিসংগত, লাগোয়া এলাকাতেই একটু বেশিদূর বেড়ে যাচ্ছে।
তাহলে বহুঅর্থকতার দুটো ব্যাখ্যা ছিল, আর দুটোর প্রস্তাবেই আমার ভূমিকা ছিল। কিছু অর্থে তারা পরস্পরের উল্টো: সাধারণীকরণ একই রকম বিষয়কে একসঙ্গে রাখে, আর সুপারপজিশন একসঙ্গে রাখে সম্পর্কহীন বিষয়। গবেষণার এই ক্ষেত্র সুপারপজিশনের ওপরই বাজি ধরেছিল, আর কদিন আগেও আমিও তাই করেছিলাম। কিন্তু এখন আমার মনে হয়, পুনরাবৃত্ত সাধারণীকরণই মূলত ঠিক ছিল। তাতে শেষ পর্যন্ত শেখার নীতি একটিই থাকে। ব্যাপারটা এখনও সাধারণীকরণই, তবে দেখা যাচ্ছে তার গঠন ফ্র্যাক্টালের মতো, শাখার মধ্যে আরও শাখা। এতে উদ্বেগ অনেক কম: কোন বিষয়গুলোকে কীভাবে একসঙ্গে রাখা হয়েছে, তা থেকে শেখার কিছু আছে; সুপারপজিশনে পাশাপাশি রাখা দুটো বিষয় থেকে শেখার কিছু নেই। আর সাধারণীকরণ নিজেই যেহেতু ফ্র্যাক্টালের মতো, আমাদের ব্যাখ্যাও তেমন হতে পারে। গোড়ায় একটা সহজ ব্যাখ্যা দিয়ে শুরু করুন, তারপর আরও বুঝতে চাইলে ভেতরে ঢুকে কাছ থেকে দেখুন। এই অর্থে যথেষ্ট খুঁটিয়ে দেখলে প্রায় পুরো নেটওয়ার্কই ব্যাখ্যা করা যায়, বিশেষ করে প্রশিক্ষণের সময় সেটা কীভাবে বড় হয়েছে, যদি তা দেখা যায়।
এই ব্যবধান এত বড় হলো কেন? আমার ধারণা, কয়েকটি সাধারণ সমস্যা মিলে বড় হয়ে উঠেছিল। 2023 সালের ব্যাখ্যাকারী মডেলগুলো অনুমান করে পরীক্ষা চালানো, তারপর আবার অনুমান সংশোধন করার চক্রটি চালাতে পারত না। সরঞ্জাম আর মূল্যায়নের মাপকাঠি ছিল দুর্বল; ব্যাখ্যা সত্যি কি না, তার বদলে সক্রিয়তার অনুকরণ করতে পারে কি না, তার জন্য পুরস্কার দেওয়া হতো। এই দুটো প্রায়ই মেলে না। ভাষার নিউরনে কী ধরনের পুনরাবৃত্ত গঠন আশা করতে হবে, তা কেউ জানত না; মোটের ওপর মানুষ ভুল ধরনের জিনিসই খুঁজছিল। আর বেশির ভাগ গবেষণায় ছোট বা সরল করা মডেল ব্যবহার করা হয়েছিল। এক অর্থে ওই মডেলগুলোর সত্যিই জায়গা ফুরিয়ে গিয়েছিল, তাই সুপারপজিশনই স্বাভাবিক ব্যাখ্যা মনে হয়েছিল। কিন্তু নেটওয়ার্কে জায়গা কম পড়লে সে শেখার নীতি বদলায় না; ছোট ছবির মডেলগুলোর মতো তার নিউরনগুলোর আওতা শুধু আরও বড় হয়। কী খুঁজতে হবে জানা থাকলে, বিস্তৃত আওতার নিউরনগুলোকেও সাধারণত ভেঙে বোঝা সহজ। সেই জ্ঞান ছাড়া, আর আদিম সরঞ্জাম দিয়ে দেখলে, তাদের এলোমেলো মিশ্রণ মনে হয়।
ব্যাখ্যাযোগ্যতার কাজে এগোনোর গতি আশ্চর্যভাবে বাড়তে থাকে। জিগস পাজল বা শব্দছকের মতো, যতটুকুই বোঝা যায়, তা গোটা ব্যবস্থার বাকি অংশ কী হতে পারে, তার সম্ভাবনা কমিয়ে আনে। শুরুতে আপনি দেখছেন একটি মাত্র নিউরন। তাকে বুঝতে না পারলে অন্য কিছু তেমন সাহায্য করে না: সার্কিট আর অবদান-মানচিত্র (attribution graph) একটি নিউরনকে ব্যাখ্যা করে অন্য নিউরনের সাহায্যে, যাদেরও আপনি এখনও বোঝেন না। এতে শুরু করাটাই কঠিন হতে পারে। তবে মানচিত্র ভরতে শুরু করলে কাজ আশ্চর্য ভালো এগোয়। কোনো নিউরন ঠিক কী করে বুঝতে না পারলে, সে কাদের সঙ্গে যুক্ত, তার আশপাশের জগৎ কেমন, আর মিক্সচার অব এক্সপার্টস মডেলে তার বিশেষজ্ঞ মডিউলটি কোন কাজে দক্ষ, সেসব দেখতে পারেন। পাজল ধীরে ধীরে মিলে যাওয়ার মতোই, প্রতিটি টুকরোর সঙ্গে অনেক সূত্র থাকে। সেগুলো সুসংগঠিত, আর তাদের নিয়ে পরীক্ষা চালানোও সহজ। তাই প্রায় ফাঁকা মানচিত্র আর অনেকটা ভরা মানচিত্র, এই দুটো অবস্থা অস্বাভাবিক নয়; এগুলোই স্বাভাবিকভাবে এসে দাঁড়ানোর জায়গা।
এমন একটি নিউরন ধরুন, যা খেয়াল রাখে “সস্তায় কেনা জিনিস দামি বিকল্পটির চেয়েও ভালো কাজ করলে নিজের সিদ্ধান্ত যে ঠিক ছিল, সেই আত্মতৃপ্তির অনুভূতি”-র দিকে। এমন অনুভূতি বা সামাজিক ইঙ্গিত অনুসরণ করে যে নিউরনগুলো, সেগুলোই আমাদের পাওয়া সবচেয়ে সাধারণ ধরনগুলোর একটি। ভাবুন, ভাষার নিউরনের গঠনধারা সম্পর্কে কিছু না জেনে আপনি এটি খুঁজে পেলেন। সার্কিটের ওপরও ভরসা করার উপায় নেই, কারণ আশপাশের খুব কম নিউরনেরই এখনও ব্যাখ্যা হয়েছে। বেশির ভাগ মানুষ আর এজেন্ট আশা করে, নিউরন বিশেষ্য শনাক্ত করবে আর সেই বিশেষ্য দেখলেই সক্রিয় হবে। অথচ বেশির ভাগ ক্ষেত্রে তারা তা করে না। এই নিউরনটি কোথায় সবচেয়ে জোরে সক্রিয় হয় দেখুন: আপাতভাবে সম্পর্কহীন একগাদা কমা দেখতে পাবেন।
এবার ভাবুন, মানচিত্রের বেশির ভাগ ভরে গেছে। আপনি জানেন, অনেক নিউরন সূক্ষ্ম অনুভূতি বা সামাজিক পরিস্থিতি শনাক্ত করে। এ-ও জানেন, তারা প্রায়ই অনুভূতিবাহী শব্দে সক্রিয় হয় না; হয় কমার মতো যতিচিহ্নে, যেখানে মডেল একটি বাক্যের অর্থ গুছিয়ে নেয়, কিংবা ঠিক তার আগের শব্দে, যার পরে কী আসবে অনুমান করার জন্য অনুভূতিটি জরুরি হয়ে উঠবে। তাই এবার আপনি আশপাশের বাক্যগুলো পড়েন। আচরণের দিক বদলানোর প্রভাবও পরীক্ষা করেন: নিউরনটির সক্রিয়তা বাড়িয়ে দিলে মডেল কী লেখে। দেখেন, সেটাও ব্যাখ্যার সঙ্গে বেশ মিলে যাচ্ছে। আগের দিকে তাকিয়ে দেখেন, নিউরনটি কীভাবে তৈরি হয়েছে; পরের দিকে তাকিয়ে দেখেন, সে কী করে। দুটোই মিলে যায়। তার ঋণাত্মক মেরু পরীক্ষা করেন, কী তাকে জোরালোভাবে ঋণাত্মক দিকে ঠেলে দেয় তা দেখেন। সেখানে খুঁজে পান একই ইঙ্গিতের সূক্ষ্ম আরেক রূপ, কিংবা সেই মুহূর্ত, যখন সামাজিক প্রসঙ্গটি শেষ হচ্ছে। নির্দিষ্ট পরীক্ষাও চালাতে পারেন, যেমন কোন কোন দোকানের নিজস্ব ব্র্যান্ডে সে সাড়া দেয় তা দেখা। এই পরীক্ষাগুলোর যেকোনো একটিতে ব্যাখ্যাটি ভুল প্রমাণিত হতে পারত, অথচ সবগুলো বারবার একই দিকে আঙুল তোলে। আর এই নিউরনটি বোঝার ফলে বৃহত্তর গঠনধারাটিও পরিষ্কার হয়: সূক্ষ্ম অনুভূতি আর সামাজিক প্রসঙ্গ শনাক্ত করা হাজার হাজার নিউরন দেখার পর, পরেরটি থেকে কী আশা করা যায় তা আপনি বুঝতে শুরু করেন। কাজ যত এগোয় মানচিত্র তত দ্রুত ভরে ওঠার এটাও একটা কারণ।
সরঞ্জামের ক্ষেত্রেও একই ব্যাপার কাজ করে। নেটওয়ার্কের 2% দেখতে পেলে আপনার সরঞ্জামের কোথায় খুঁত, তা বুঝতে পারেন না। বেশির ভাগ দেখতে পেলে, ব্যাখ্যা না হওয়া বাকি অংশ সরাসরি সেই খুঁতগুলোর দিকেই আঙুল তোলে। এভাবেই আমি আর কয়েকজন সহকর্মী SwiGLU নিউরনের মধ্যে দুই ঋণাত্মক মানের একটি কার্যাবস্থা খুঁজে পাই। আমাদের জানা মতে, আগে কেউ সেটা খেয়াল করেননি। আর অনেক নিউরন একসঙ্গে মিশিয়ে ভেঙে উপাদানে সাজালে বিষয়টি সম্ভবত আড়ালেই থেকে যেত।
আধুনিক নিউরাল নেটওয়ার্ক নিয়ে খারাপ খবর হলো, সেগুলো বিরাট। ভালো খবর হলো, এই বিরাট আকার সাহায্যও করে: মানচিত্র ভরে উঠলে প্রতিটি ব্যাখ্যাকে আশপাশের সবকিছুর সঙ্গে শক্তভাবে মিলতে হয়। আর বড় মডেল শুরু থেকেই আরও সংকীর্ণ আওতার নিউরন শেখে, যাদের চেনা সহজ।
এই অর্থে, শুধু আমাদের সবচেয়ে দরকারি অংশগুলো বোঝার চেয়ে গোটা নেটওয়ার্ক বোঝা সহজ হতে পারে। প্রথমত, নিউরাল নেটওয়ার্ককে খুঁটিয়ে অধ্যয়ন না করলে তার মতো করে কীভাবে ভাবতে হবে, তা জানা কঠিন। যেমন “প্রতারণা” দিয়ে শুরুতে ভাবা কাজে লাগে, কিন্তু মডেলের প্রতারণামূলক আচরণে যে উপাদানগুলো ভূমিকা রাখে, সেগুলোর মধ্যে সম্ভবত এমন সূক্ষ্ম গঠন আছে, যা মানুষের উদ্দেশ্যের সঙ্গে মডেলকে মিলিয়ে রাখার জন্য প্রাসঙ্গিক। ভেতরে ঢুকে না দেখলে তা জানা কঠিন হবে। দ্বিতীয়ত, অল্প কয়েকটি প্রক্রিয়াকে লক্ষ্য করে কাজ করা মানে এমন একটি শব্দছকের শুধু এক সারি মেলাতে বসা, যার বাকি সব ঘর ফাঁকা। কাজটা করা সম্ভব, সফলও হতে পারে, কিন্তু আড়াআড়ি আর লম্বালম্বি শব্দগুলোর মিল ছাড়া আপনি ঠিক আছেন কি না, তা বোঝা কঠিন। পুরোটা মেলানো সহজতর হতে পারে; অন্তত নেটওয়ার্কের যে বিস্তৃত অংশগুলোর সঙ্গে এই প্রক্রিয়াগুলো যুক্ত, সেগুলো তো বটেই।
আধুনিক কনভল্যুশনাল নেটওয়ার্কে এই পদ্ধতি প্রয়োগ করে দেখেছি, মোটের ওপর কাজ হয়েছে। এজেন্টেরা নিউরন আর সার্কিটের মানচিত্র বানাতে পারে, ঘুরে দেখার মতো মাইক্রোস্কোপ তৈরি করে তা ঘুরে দেখতে পারে, ব্যাখ্যাগুলো পুঙ্খানুপুঙ্খভাবে পরীক্ষা করতে পারে, আর কয়েক লক্ষ অবদান-মানচিত্রের হিসাব রাখতে পারে। কোনো পর্যায়েই দ্রুত স্বাভাবিক বৈজ্ঞানিক অনুসন্ধান থেমে যায়নি। এখন মনে হয়, এই মডেলগুলো আমি মোটামুটি বুঝি। অন্তত কোনো প্রশ্ন মনে এলে কোথা থেকে খোঁজ শুরু করব, তা জানার মতো বুঝি; একসময় শব্দছকটা সত্যিই ভরে গেল। এখনও পর্যন্ত কয়েক ট্রিলিয়ন প্যারামিটার পর্যন্ত ভাষার মডেলেও এই পদ্ধতি কাজ করেছে। শুধু বিশাল আকারের কারণেই সেগুলো পুরো বোঝার ধারেকাছেও আমরা নেই, কিন্তু প্রক্রিয়াটিকে আরও বড় পরিসরে নিয়ে যাওয়া যাবে বলে আমি আশাবাদী।
সব মিলিয়ে আমি আবার একটি পুরোনো আশায় ফিরে এসেছি: প্রথমে নিউরাল নেটওয়ার্ককে ঠিক করা বা তার জট ছাড়ানোর চেষ্টা না করে, তার নিজস্ব প্রক্রিয়া আর তাদের মধ্য দিয়ে চলাচল করা ডেটা অধ্যয়ন করেই তাকে সরাসরি বোঝা। একসঙ্গে সাজালে যুক্তিটির চারটি ধাপ দাঁড়ায়।
1. নেটওয়ার্ক শেখার একটি নীতি ব্যবহার করে, দুটো নয়। সর্বত্র না হলেও, এতটাই সর্বত্র যে গবেষণার জন্য বাকি ব্যতিক্রমে কিছু যায় আসে না। তাই তাকে নিয়ে সাধারণ বৈজ্ঞানিক গবেষণা শুরু করার পথে কোনো বাধা নেই।
2. আধুনিক মডেল আর সরঞ্জাম দিয়ে সেই গবেষণা বেশির ভাগ মানুষ যতটা আশা করে, তার চেয়ে অনেক ভালো চলে।
3. বোঝাপড়া জমতে জমতে তার ফল আরও বাড়ে। তাই মানচিত্র যত ভরে, কাজ তত সহজ হয়। অন্তত এটুকু বলা যায়, নেটওয়ার্কের নিজস্ব প্রক্রিয়াগুলো আমাদের কাজের সরঞ্জামের অংশ হওয়া উচিত।
4. খুবই অনুমাননির্ভর কথা: আমাদের যা দরকার, তার বেশির ভাগ হয়তো এ থেকেই পাওয়া যাবে। আর ব্যাখ্যাযোগ্যতার সমস্যাটি আমরা যতটা ভেবেছি, তার চেয়ে অনেক বেশি সমাধানযোগ্য হতে পারে, হয়তো অদূর ভবিষ্যতেই।
সাধারণভাবে ডিপ লার্নিংয়ে এমনটাই দেখা গেছে: সহজ একটি পদ্ধতি অবিশ্বাস্য বড় পরিসরে প্রয়োগ করলে তা বুদ্ধিদীপ্ত জটিল পদ্ধতিকে হারিয়ে দেয়। রিচ সাটন একে বলেছেন the bitter lesson[22]। ব্যাখ্যাযোগ্যতার জন্যও হয়তো এমন একটা তিক্ত শিক্ষা আছে: চতুর নতুন কোনো বিভাজন-পদ্ধতি বানানোর চেয়ে সাধারণ অনুসন্ধানকে বড় পরিসরে নিয়ে যাওয়াই বেশি ফল দেয়।
সঙ্গের কারিগরি গবেষণাপত্রে ভাষার মডেলের নিউরন নিয়ে পরীক্ষাগুলোর আরও বিস্তারিত বিবরণ থাকবে। যেমন আধুনিক নন-লিনিয়ারিটির আলাদা কার্যাবস্থা সম্পর্কে আমরা কী পেয়েছি, আর কোন গভীরতায় কেমন সার্কিটের গঠনধারা দেখা যায়। এই প্রবন্ধে নানা জায়গায় একটু করে তাকানো হয়েছে, আর সব মিলিয়ে কোন দিকে ইঙ্গিত মিলছে, তা নিয়ে কিছু অনুমান করা হয়েছে।
গাড়ি ও প্রাণী
সবচেয়ে বিখ্যাত বহুঅর্থক নিউরনটি হলো InceptionV1-এর 4e:55। একে দেখে মনে হতো বিড়াল আর গাড়ির একটি এলোমেলো মিশ্রণ। নিউরন হয়তো গবেষণার সঠিক একক নয়, তার প্রমাণ হিসেবে এই ক্ষেত্রের বহুলপঠিত বেশ কিছু গবেষণাপত্রে এর কথা এসেছে: 2017 সালের Feature Visualization[1] থেকে Zoom In[4] পর্যন্ত। যে Zoom In-এর সহলেখক আমি ছিলাম, সেখানে আমরা সরাসরি বলেছিলাম, এটি “গাড়ি আর বিড়ালের মুখের মধ্যে কোনো মিলের কারণে সাড়া দিচ্ছে না”।²
² Multimodal Neurons-এ আমরা খুব কাছাকাছি পৌঁছেছিলাম। প্রশ্ন করেছিলাম, নিউরনটি কোনো অভিন্ন ফিচারে সাড়া দিচ্ছে কি না, “হয়তো বিড়ালের চোখ আর গাড়ির বাতি দেখতে একই রকম”। তারপর ফিচার ভিজুয়ালাইজেশনে গোঁফ আর ক্রোমের উপস্থিতি দেখে সিদ্ধান্ত নিই, এটি “সত্যিই OR(cat, car)”, অর্থাৎ বিড়াল অথবা গাড়ি। অভিন্ন আকৃতি খুঁজতে যাওয়াটা ঠিক ছিল, কিন্তু সাধারণীকরণ কতদূর পৌঁছাতে পারে, তা আমরা কম করে ধরেছিলাম বলে আমার মনে হয়। অভিন্ন ফিচারটি ছিল V-আকৃতি। আমার ধারণা, গোঁফ আমাদের ভুল পথে নিয়েছিল, কারণ সাধারণীকরণ উচ্চস্তরের প্যাটার্নের ভেতরেই ঘটে। V-নিউরন সত্যিই বিড়ালের সার্কিট থেকে ইনপুট নেয়। আর ফিচার ভিজুয়ালাইজেশনের কাজ যেহেতু সক্রিয়তা বাড়ানো, তাই বিড়ালের পথে একবার পৌঁছে গেলে সে সেই পথ দিয়ে আসা সবকিছুই যোগ করতে থাকে। গোঁফও সেই সঙ্গে চলে আসে, যদিও নিউরনটি হয়তো গোঁফ “চায়” না। পরের দিকে গাড়ি শনাক্ত করতে সংকেত পড়ে যে নিউরনগুলো, তারা V-নিউরনের মধ্য দিয়ে বিড়ালের সামান্য সংকেত পায় ঠিকই, কিন্তু তা প্রায় আউটপুট পর্যন্ত পৌঁছায় না। অনেকগুলো বিড়াল শনাক্তকারী একসঙ্গে কাজ করে বলে একটিমাত্র সক্রিয় হয়ে নিজে তেমন কিছু করতে পারে না। তাই ওই সংকেত কাটাতে নেটওয়ার্কের কোনো ঋণাত্মক ওজনের দরকারই হয় না। অভিন্ন প্যাটার্নটি দেখতে হলে শুধু নিউরনটিকে দৃশ্যায়িত করলে হবে না; তার ইনপুটগুলোর মধ্যে কী মিল আছে, তা দৃশ্যায়িত করতে হবে।
কয়েক মাস ধরে গোছানো নিউরন দেখার পর আমার মনে হলো, বহুঅর্থকতা আর সুপারপজিশনের শুরুর দিকের কয়েকটি বিখ্যাত উদাহরণ আমরা ভুল বুঝেছিলাম কি না। সবচেয়ে পরিচিত বহুঅর্থক নিউরনটি থেকেই যাচাই শুরু করা স্বাভাবিক মনে হলো। তাই বিড়াল আর গাড়ির ছবির যে ছক আমি এর আগে শতবার দেখেছি, সেটিই খুললাম। তারপর এমন একটি কাজ করলাম, যা আগে কখনো করিনি: কয়েক সেকেন্ড ভাবলাম, এরা সবাই মিলে একটিমাত্র কী হতে পারে? প্রায় সঙ্গে সঙ্গেই পরিষ্কার হয়ে গেল: এটি বিড়াল আর গাড়ির নিউরন নয়, এটি V-আকৃতির নিউরন।
তার সার্কিটের সংযোগগুলো দেখলাম: V-আকৃতির আগুনের শিখা, আগুন নেভানোর নৌকার V-আকৃতির পানির ধারা, V-আকৃতির শিয়ালের মুখ। তার ঋণাত্মক মেরু দেখলাম: একটি O, যেখানে V সুচালো, সেখানে সেটি গোল। বিড়াল আর গাড়ির এলোমেলো কোনো মিশ্রণের সঙ্গে আগুনের শিখার এত জোরালো সংযোগ থাকবে কেন?
ওপরে রয়েছে তার সবচেয়ে শক্তিশালী ইনপুট, তার সংকেত পড়ে এমন নিউরন, এবং সাধারণভাবে তৈরি দৃশ্যরূপ; রেখার পুরুত্ব সংযোগের শক্তি বোঝায়। নিচে রয়েছে প্রতিটি ছবিতে সে কী দেখে: ছবির শ্রেণির নাম যা-ই হোক, সুচালো বস্তু তাকে সক্রিয় করে আর গোল বস্তু তাকে ঋণাত্মক দিকে ঠেলে দেয়।
এরপর গেলাম সুপারপজিশনের সেই বহুলপরিচিত সার্কিটটির কাছে, যেটি আমি 2019 সালে প্রথম খুঁজে পাই³। V-নিউরন আর এই সার্কিট ছিল Zoom In[4]-এর দুটো প্রধান উদাহরণ, যা দেখিয়ে বলা হয়েছিল, মন দিয়ে দেখলে প্রায় প্রতিটি নিউরনই বোধগম্য হয়ে ওঠে বলে সেখানে যে ছবি তুলে ধরা হয়েছে, তা হয়তো “বেশি রকম আশাবাদী”।
³ প্রথম Circuits ইন্টারফেস বানানোর সময় আমি এটি খুঁজে পাই। সেখানে শুধু ফিচার ভিজুয়ালাইজেশন আর নিউরনগুলোর সংযোগের ওজন দেখা যেত। তারপর সেগুলো ক্রিস ওলাহকে দেখিয়ে জিজ্ঞেস করি, গাড়িটি এভাবে এই কুকুরগুলোর মধ্যে যাচ্ছে কেন। আমরা সিদ্ধান্তে পৌঁছাই, এটি নিশ্চয়ই এক ধরনের ভাঁজ করার কাজ করছে, আর তার নাম দিই সুপারপজিশন। যা দেখছিলাম, তার সহজবোধ্য একটা ব্যাখ্যা ছিল এটি। তাই সরঞ্জামগুলো আরও গভীরভাবে খতিয়ে দেখার তাগিদ আসেনি; তা করলে ফিচার ভিজুয়ালাইজেশনে পুরস্কারের লক্ষ্যকে ফাঁকি দেওয়া, অর্থাৎ reward hacking, আর নানা বিষয় ধরা পড়ত। সেটিকে উচ্চমাত্রিক কোনো স্থানে রাখা হচ্ছে, এটা যুক্তিসংগত উত্তর মনে হয়েছিল।
সার্কিটটিতে দেখে মনে হচ্ছিল, একটি গাড়ি একগুচ্ছ সম্পর্কহীন কুকুরের মধ্যে ঢুকে যাচ্ছে। যেন কুকুরগুলো এক ধরনের উচ্চমাত্রিক ভাণ্ডার, যেখান থেকে দরকার হলে পরে গাড়িটিকে উদ্ধার করা যাবে।
কিন্তু গাড়িটি তা করছিল না। গাড়ি আর কুকুরকে একসঙ্গে আনা হচ্ছিল তাদের ভঙ্গির মিলের জন্য। InceptionV1-এ এমন একশরও বেশি সাধারণীকৃত ভঙ্গির নিউরন আছে। প্রতিটি আলাদাভাবে গাড়ি, কুকুর ও অন্য বস্তুর মধ্যে অভিন্ন একটি ভঙ্গিকে পরিষ্কারভাবে শনাক্ত করে। আমার জানা মতে, আগে কেউ সেগুলো খেয়াল করেননি। পরের স্তরগুলো এগুলোর ওপর ভর করে আরও গড়ে ওঠে, একেবারে মডেলের শেষ পর্যন্ত। গাড়িটিকে কোনো দুর্বোধ্য জায়গায় রেখে দেওয়া হচ্ছিল না, আর কেউ ওই সম্মিলিত বিন্যাস সরাসরি পড়ছেও না। বরং উল্টোটাই ঘটছে: এটি আরও নির্দিষ্ট গাড়ি আর আরও সূক্ষ্ম ভঙ্গির বিশেষজ্ঞ নিউরনে আলাদা হতে থাকছে।
এর একটি কারণ ছিল, সাধারণীকৃত ভঙ্গির নিউরনের কথা আমরা জানতাম না। আরেকটি কারণ হলো, ছবির ছোট প্রতীকী রূপ বানাতে যে কৌশল ব্যবহার করি, সেই ফিচার ভিজুয়ালাইজেশন গভীর স্তরে গিয়ে পুরস্কারের লক্ষ্যকে ফাঁকি দেওয়ার শিকার হয়। উদ্দেশ্য থাকে এমন একটি ছবি খুঁজে পাওয়া, যা নিউরনকে সবচেয়ে বেশি সক্রিয় করে। কিন্তু কাজটি করা হয় গ্রেডিয়েন্ট ডিসেন্ট দিয়ে, আর সেটি সবচেয়ে সহজ পথটি ধরে। InceptionV1-এ তার মানে প্রায়ই কুকুর। InceptionV1-এর প্রশিক্ষণের ডেটায় প্রচুর কুকুর আছে, কুকুরের নিউরনও অনেক। অপ্টিমাইজেশন শুরুতেই সেই পথে পড়ে যায়, আর বেরোতে পারে না। যে স্বাভাবিক পথ ধরে সবচেয়ে জোরালো সাড়া জাগানো ছবিগুলো এগোয়, সেই দিকে একটুখানি ঝুঁকিয়ে দিলেও দেখা যায়, বেশির ভাগই গাড়ি। আর কিছুতে গাড়ি ও কুকুর দুটোই থাকে, তাদের ভঙ্গি একই বলে।
আমরা ভেবেছিলাম গাড়িটি কুকুরের নিউরনগুলোর মধ্যে লুকানো আছে, পরে সেখান থেকে পড়ে নেওয়া হয়। আসলে আমরা সেগুলো ভুলভাবে দৃশ্যায়িত করছিলাম। গাড়ির পথ দিয়ে দৃশ্যায়িত করলে দেখা যায়, দুটো গাড়ির নিউরন, আর দুটো ধরে গাড়ি ও কুকুরের অভিন্ন ভঙ্গি।
জায়গা যথেষ্ট নেই বলেই কুকুর আর গাড়ি একসঙ্গে আছে, এই ধারণা থেকে এই সাধারণীকরণকে গুরুত্ব না দিতে ইচ্ছে হতে পারে। হয়তো সে “আসলে চেয়েছিল” কুকুরের ভঙ্গি আর গাড়ির ভঙ্গির জন্য আলাদা নিউরন। আরও জায়গাওয়ালা বড় মডেল হলে হয়তো তাদের আলাদা করে দিত। বড় মডেলে সাধারণত আরও সংকীর্ণ আওতার নিউরন থাকে, এ কথা সত্যি। কিন্তু নেটওয়ার্ক বড় হওয়ার সময় কাজটি কখনো কখনো আমাদের সহজ অনুমানের বাইরের উপায়েও করতে পারে।
DINOv2[12]-কে দেখুন। এর আকার দশ গুণেরও বেশি, আর এর স্থাপত্য প্রায় দশ বছর পরের। এতে ভঙ্গির নিউরন বেশি আছে, কিন্তু তাদের অনেকগুলো এখনও সাধারণীকৃত। আমি যত আকারের যত ছবির মডেল দেখেছি, সবগুলোতেই এটা দেখেছি।
একই নিউরন DINOv2 আর আমাদের বড় ও মাঝারি ConvNeXt-গুলোতেও দেখা যায়: কুকুর আর যানবাহনকে একত্র করা হয়েছে তারা ক্যামেরার দিকে কীভাবে মুখ করে আছে, তার ভিত্তিতে। আমাদের সবচেয়ে ছোট মডেলে শুধু একটি মোটামুটি রূপ আছে; সেখানে গাড়ি আর কুকুর একসঙ্গে আছে, তবে ভঙ্গি অনুযায়ী নয়।
মানুষ আর স্বয়ংক্রিয় ব্যাখ্যাকারী, দুপক্ষেরই মনে হয় নিউরনকে বিড়াল আর গাড়ির মতো একগুচ্ছ বিশেষ্য শনাক্তকারী হিসেবে বর্ণনা করার প্রবল ঝোঁক আছে। V-এর মতো অভিন্ন কোনো প্যাটার্ন শনাক্তকারী হিসেবে দেখার ঝোঁক ততটা নেই। কখনো কখনো নিউরন সত্যিই একগুচ্ছ বিশেষ্যে সাড়া দেয়। তবে আমার অভিজ্ঞতায়, আরও বেশি ক্ষেত্রে ব্যাপারটা অভিন্ন কোনো প্যাটার্ন। আর নিউরনকে বিশেষ্যের চেয়ে ক্রিয়া হিসেবে ভাবলে ভালো বোঝা যায়। তার কাজ ইনপুটে কী আছে তার নাম বলা নয়; তার কাজ এমন একটি পার্থক্য টানা, যা পরের নিউরনগুলো কাজে লাগাতে পারে। ধনাত্মক আর ঋণাত্মক মেরুতে সে দুটো সূক্ষ্ম প্যাটার্নকে আলাদা করে, যেমন একটি V আর একটি O, তারপর সেই অনুযায়ী সক্রিয়তার প্রবাহকে আলাদা আলাদা নিউরনের দিকে ঠেলে দেয়।
কোনো নিউরন বুঝতে আটকে গেলে প্রায়ই নিজেকে একটি প্রশ্ন করে এগোতে পারি: একগুচ্ছ বিশেষ্যের সাহায্য একেবারেই নিতে না পারলে, নিউরনটিকে অন্য কাউকে কীভাবে বোঝাতাম? সাধারণত অভিন্ন প্যাটার্নটি তখনই চোখে পড়ে। তারপর বিশেষ্যের আরও দল দিয়ে তা পরীক্ষা করাও সহজ হয়; V-এর জন্য যেমন শিনকানসেন ট্রেন বা পুল খেলার টেবিল। আমার সন্দেহ, মাঝের স্তরের নিউরনগুলোকে ভুল করে বহুঅর্থক ভাবার সবচেয়ে বড় উৎস এটাই। কোনো নিউরনকে বহুঅর্থক বলে যে ব্যাখ্যাগুলো দেখেছি, তার অনেকগুলোই আমার কাছে মনে হয়, একটি প্যাটার্নকে বিশেষ্যের তালিকা দিয়ে বর্ণনা করা হচ্ছে।
যে নিউরন দু-তিনটি বিষয় বোঝায়, তাকে আমাদের একটি নিউরন হিসেবেই দেখা উচিত, যার মধ্যে কয়েকটি অর্থ একসঙ্গে রাখা আছে। এই একসঙ্গে রাখা সম্ভবত নেটওয়ার্কের জন্য সমস্যা ছিল না: অর্থগুলো পাশাপাশি আছে, কারণ নেটওয়ার্কের চোখে তারা একই রকম। ফলে এই দলবাঁধাটাই নেটওয়ার্ক কীভাবে ভাবে, তার একটি সূত্র। সেই সূত্র ধরে এগোলে এমন সাধারণীকরণ বেরিয়ে আসতে পারে, যার কথা আমরা জানতাম না, যেমন এখানে বিড়াল আর গাড়ি থেকে জানা গেল। প্রায়ই কাছ থেকে দেখলে বাড়তি অর্থগুলোও মিলিয়ে যায়; দেখা যায়, সেগুলো গৌণ, আর খুব কমই সক্রিয় হয়। সবশেষে, কিছু আপাত অর্থ আসলে আমাদের সরঞ্জামের খুঁত মাত্র। এই প্রবন্ধে তার বেশ কয়েকটি উদাহরণ আছে: SwiGLU-এর দুই ঋণাত্মক মানের কার্যাবস্থা, গুরুত্বের মাত্রা নিয়ন্ত্রণের এমন একটি ঘুঁটি যার সংকেত কেউ পড়ে না অথচ যা রেসিডুয়াল স্ট্রিমকে দৃশ্যায়িত করা কঠিন করে তোলে, আর একটু আগে দেখা ফিচার ভিজুয়ালাইজেশনের reward hacking। মূল নিউরনটিকে অক্ষত রাখলে এই ভুলগুলো চোখে পড়ে, ফলে ভুল শোধরানোর কাজ চলতে পারে। অপ্টিমাইজেশন দিয়ে আরও পরিচ্ছন্ন একটি তালিকা বানিয়ে নিলে, এই সূত্রগুলোর অনেকগুলো হয়তো হারিয়ে ফেলতাম।
মাইক্রোস্কোপের ভুলের ইতিহাস
আমার চোখে ব্যাখ্যাযোগ্যতার ইতিহাস অনেকখানিই এমন এক আবিষ্কারের ইতিহাস: মাইক্রোস্কোপের নিচে যা ছিল, তা আমরা যতটা ভেবেছিলাম, তার চেয়ে ভালো। মাইক্রোস্কোপটাই ঠিকমতো মেলানো ছিল না, আর যেখানে সেটি মেলানোর দরকার ছিল, সেই ব্যাপারগুলো প্রায়ই খুব সূক্ষ্ম।
আধুনিক নিউরাল নেটওয়ার্কের ব্যাখ্যাযোগ্যতার শুরু সম্ভবত ফিচার ভিজুয়ালাইজেশন দিয়ে। একটি নিউরন সবচেয়ে বেশি কিসে সাড়া দেয়, এই পদ্ধতি তার কৃত্রিম ছবি বানায়: সেই বিখ্যাত বিচিত্র রঙে-আকৃতিতে ভরা ছবিগুলো। কিছুদিন সেগুলো দেখতে বিশেষ ভালো হতো না। দেখে যুক্তিসংগতভাবেই মনে হতে পারত, নিউরনগুলো কিছু শিখেছে বটে, কিন্তু খুব গোছানো কিছু শেখেনি। পরে দেখা গেল, পদ্ধতিটিতে ছবি রূপান্তরের পরও ফল স্থিতিশীল রাখার ব্যবস্থা ছিল না। গবেষকেরা তা যোগ করার পর একই নিউরনের ছবিগুলো পরিষ্কার ফুটে উঠল।
তবে এ দিয়ে মডেলের ভেতরে কিছুদূর পর্যন্তই যাওয়া যায়। শেষের দিকে ফিচার ভিজুয়ালাইজেশন আবার ব্যর্থ হতে থাকে, দুটো কারণে: গাড়ির সার্কিটে দেখা পুরস্কারের লক্ষ্যকে ফাঁকি দেওয়া, আর রেগুলারাইজেশনের নিয়ম ঠিকঠাক না হওয়া। এটা ঠিক করতে অসাধারণ কোনো কৌশল লাগেনি। যুক্তিসংগত সেটিংসে কয়েকটি সূক্ষ্ম বদল করেই এখন নেটওয়ার্কের অনেক গভীরে দেখা যায়। নিউরন একই, মাইক্রোস্কোপ আরও ভালো।
InceptionV1-এর একই দুটো নিউরন, পাশে যেসব ছবিতে তারা সবচেয়ে জোরালো সাড়া দেয়। রেগুলারাইজেশনে ছোট ছোট বদল করলে প্রথমে মাঝের স্তরের নিউরনটি, তারপর শেষের দিকেরটি পরিষ্কার হয়ে ওঠে।
তবে পুরোটাই মাইক্রোস্কোপের ব্যাপার ছিল না। মডেলকেও ঠিকঠাক করতে হতো। এই ক্ষেত্রের শুরুর দিকের পরীক্ষার নমুনা InceptionV1-এর শেষের স্তরগুলো ছিল পুরোই ব্যাখ্যার অতীত। একটি হিসাবে বলা হয়েছিল, “আমার জানামতে, InceptionV1-এর শেষ স্তরে ব্যাখ্যা করা যায় এমন নিউরন কার্যত নেই।” আমার নিজের স্মৃতির সঙ্গেও এটা বেশ মেলে, আমি হয়তো 5% বলতাম। তাদের চেহারা ছিল এ রকম।
InceptionV1-এর শেষের দিকের একটি স্তরের নিউরন, অপ্টিমাইজ করে তৈরি দৃশ্যরূপ ও বাস্তব ছবি দিয়ে দেখানো হয়েছে।
আমি যতদূর জানতাম, প্রধান ব্যাখ্যাটি ছিল এই: যত নিউরন আর প্যারামিটার আছে, তার তুলনায় ওপরের স্তরে প্রকাশ করতে হয় এমন ফিচারের সংখ্যা অনেক বেশি। তাই যাদের একসঙ্গে থাকার কথা নয়, তারা একে অন্যের সঙ্গে ধাক্কা খায় না বলে নেটওয়ার্ক ইচ্ছেমতো তাদের গুঁজে রাখা শুরু করেছে। প্রথম দিকের স্তরগুলো ছিল একার্থক (monosemantic), কারণ সেখানে তত বেশি ফিচার প্রকাশ করার দরকার হতো না।
কিন্তু এই ব্যাখ্যা ঠিক ছিল না। এখানে আরও আধুনিক একটি কনভল্যুশনাল নেটওয়ার্ক দেখুন। প্যারামিটারের সংখ্যা আর ডেটাসেট একই, তবে এতে রেসিডুয়াল কানেকশন, LayerNorm আর আরও দু-একটি উন্নতি আছে। শেষের স্তরটি চমৎকার।

50,000 ছবির মধ্যে প্রতিটি নিউরনের সবচেয়ে জোরালো 20টি সাড়া, ক্রমানুসারে সাজানো। অন্য শ্রেণির ছবিগুলো লেবেল দিয়ে চিহ্নিত।
তাহলে দুটো জিনিস দরকার ছিল। প্রথমত, নিউরাল নেটওয়ার্ককে ভালো করে শিখতে হতো। তার জন্য এমন স্থাপত্য দরকার ছিল, যা বানিয়েছেন এমন মানুষ, যাঁদের পুরো মনোযোগ ওই লক্ষ্যেই, ব্যাখ্যাযোগ্যতায় যাঁদের কোনো আগ্রহ নেই। রেসিডুয়াল স্ট্রিম তার একটি উদাহরণ: আরও গভীর নিউরাল নেটওয়ার্ককে শেখানো সহজ করতে এটি আনা হয়েছিল। মনে হচ্ছে, গভীর স্তরগুলোকে ধারণাগতভাবে গোছানো রাখতেও এটি সাহায্য করে। এই দুটো বিষয় হয়তো সম্পর্কিত। দ্বিতীয়ত, সেগুলো পরিষ্কার দেখতে আমাদের যথেষ্ট শক্তিশালী সরঞ্জাম দরকার ছিল।
নিউরাল নেটওয়ার্ক প্রায় মৌলিকভাবেই ব্যাখ্যার অতীত, কারণ তারা যেভাবে শেখে তাতে সম্পর্কহীন মিশ্রণ একে অন্যের ওপর এসে পড়ে, এই ধারণার প্রধান প্রমাণগুলোর একটি ছিল InceptionV1-এর শেষ স্তর। নিউরনগুলো বদলে ফেলাই একমাত্র পথ মনে হচ্ছিল। সেই সময়ের সরঞ্জাম দিয়ে আমি ব্যাখ্যাযোগ্যতার হার প্রায় 5% ধরতাম, অন্যরা ধরতেন প্রায় 0%। আরও ভালো ব্যাখ্যার সরঞ্জাম দিয়ে, যেমন ঠিক করা ফিচার ভিজুয়ালাইজেশন, অবদান দৃশ্যায়নের পদ্ধতি ইত্যাদি দিয়ে, একই নেটওয়ার্কে হারটি প্রায় 50%। এই সবই 2014 সালের সেই মডেল নিয়ে, যার প্রশিক্ষণের চেকপয়েন্ট আর খুঁটিনাটি সময়ের সঙ্গে হারিয়ে গেছে। একই স্থাপত্য আরও যুক্তিসংগত আধুনিক রেগুলারাইজেশন দিয়ে নতুন করে প্রশিক্ষণ দিলে হারটি প্রায় 70%। একই আকারের ConvNeXt-এ প্রায় 99%। এখানে সেগুলো ঘুরে দেখা যায়।
পুনরাবৃত্ত সাধারণীকরণ
তাহলে আমরা দেখালাম, শেষের স্তরটি ঠিক করা যেত। কিন্তু ঠিক করার আগে সে কী করছিল? স্থাপত্যের উন্নতির আগেও সে বিষয়গুলো ইচ্ছেমতো একসঙ্গে রাখছিল না। মডেলটিকে আবার প্রশিক্ষণ দিয়ে যখন একটি নিউরন গড়ে উঠতে দেখলাম, দেখি সেটি শুরু করেছিল হলুদ ফুল দিয়ে। সেই ছবিগুলোর কিছুতে কুকুরও ছিল। তারপর সেই ছবিগুলোর প্রতিটি দিক ধরে সে বাড়তে থাকল: অন্য ধরনের প্রাকৃতিক দৃশ্যের দিকে, বলের মতো সবুজ বস্তুর দিকে, আর এমন কুকুরের দিকে যাদের সঙ্গে কোনো ফুলই নেই। আমি যত নিউরন দেখেছি, সবগুলোর ক্ষেত্রেই এটা সত্যি। উন্নত স্থাপত্যেও একই ধরন দেখা যায়, তবে অনেক কম।
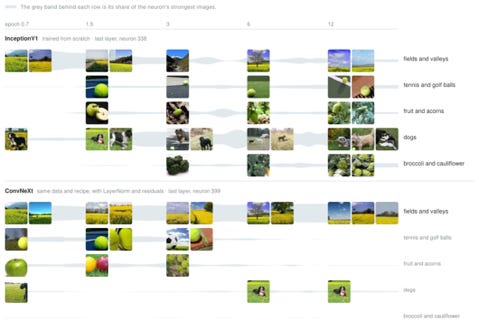
একই ডেটায় প্রশিক্ষিত InceptionV1 আর ConvNeXt-এর একটি করে নিউরন। দুটোরই শুরু রেপসিডের ক্ষেত দিয়ে। শুরুতেই দুটিই বল আর ফলের দিকে হাত বাড়ায়; ConvNeXt সেগুলো ছেড়ে দিয়ে ক্ষেতেই থাকে। InceptionV1 ছড়াতেই থাকে, প্রথমে কুকুরে, তারপর ব্রকলিতে, যতক্ষণ না ক্ষেতগুলো প্রায় হারিয়ে যায়।
একে আমরা বলছি পুনরাবৃত্ত সাধারণীকরণ: একটি নিউরনের একাধিক অক্ষ বরাবর সাধারণীকরণ। প্রায়ই প্রথমে একটি অক্ষ ধরে এগোয়, তারপর চারদিকে শাখা মেলে। কাছ থেকে দেখলে প্রতিটি ধাপ অনুসরণ করা সহজ, কিন্তু শেষ পর্যন্ত এর ফলে নিউরনটি আর “একার্থক” থাকে না।
যেমন ভাষার মডেলের একটি নিউরন “iy”-তে সাড়া দেয়, “Miyazaki”-র মধ্যকার “iy”-তেও। তারপর সাড়া দেয় “diy”-তে, তারও পর “do it yourself”-এ, যার মধ্যে “iy” আর আছেই না।
পুনরাবৃত্ত সাধারণীকরণ। একটি “iy” নিউরন নানা দিকে বাড়ে। “diy” থেকে সে পৌঁছায় “do it yourself”-এ, যার মধ্যে “iy” আছেই না। ধারণাটি বোঝানোর জন্য আঁকা।
ছবি আর ভাষা, দুই ধরনের মডেলেই চারদিকে এর উদাহরণ আছে। যেমন একটি ভূতত্ত্বের নিউরন সাধারণীকরণ করতে করতে পৌঁছায় Cesium-এ, ভূতত্ত্বের একটি JavaScript লাইব্রেরিতে।
সাধারণত কী ঘটেছে, তা এতই স্পষ্ট থাকে যে একে স্রেফ স্বাভাবিক সাধারণীকরণ বলব কি না, বুঝে ওঠা কঠিন। যেমন শত্রুবিষয়ক একটি নিউরন শত্রুদের নিয়ে লেখা রুশ কবিতায় সক্রিয় হয়। কখনো ব্যাপারটা অতটা স্পষ্ট নয়, তবু বিশ্বাসযোগ্য। Srinivasen-এর একটি নিউরন UniProt প্রোটিন ডেটাবেসেও সামান্য সক্রিয় হয়। ওই প্রকল্পের সঙ্গে Srinivasen নামের কয়েকজন যুক্ত আছেন, কিন্তু নিশ্চিত করে বলা কঠিন।
গ্রহীয় ভূতত্ত্বের একটি নিউরনের সবচেয়ে জোরালো সক্রিয়তাগুলোয় চাঁদের ভূত্বক মিশে আছে IDL আর Cesium-এর কোডের সঙ্গে। যেসব সার্কিট থেকে এগুলো ইনপুট পায়, সেই অনুযায়ী দল ভাগ করলে দেখা যায়, একই মূল বিষয়, গ্রহের পৃষ্ঠতল, তার তিনটি দিক আছে। আর আছে একটি বাড়তি শাখা, কোড, যা আসে নিজস্ব আলাদা পথে।
এই পুনরাবৃত্ত সাধারণীকরণে গজানো শাখাগুলো আর সেগুলো কতটা গুরুত্বপূর্ণ, তা নিয়ে ভাষার মডেল অংশে আলোচনা করব। এখানে শুধু গঠনধারাটি কী, সেটুকু বলতে চাই।
Multimodal Neurons[3]-এ আমরা প্রথম এর আভাস দিয়েছিলাম। তখন বলেছিলাম “conjoined features”, অর্থাৎ জোড়া-লাগা ফিচার। পুনরাবৃত্ত সাধারণীকরণ নিয়ে কয়েক মাস কাজ করার পর যখন এই ক্ষেত্রের সবচেয়ে বিখ্যাত মডেলগুলো আবার দেখতে গেলাম, ততদিনে আমি সে কথা ভুলেই গিয়েছিলাম। যতদূর মনে পড়ে, আমি-সহ কেউই বলিনি যে এটি হয়তো সাধারণ ব্যাখ্যা হতে পারে; যেমন InceptionV1-এর শেষ স্তরে কী সমস্যা ছিল, তার ব্যাখ্যা। প্রশিক্ষণের চেকপয়েন্ট ছাড়া আমরা সেটি গড়ে উঠতে দেখতে পারিনি, কিন্তু ব্যাখ্যাটি মূলত ঠিক ছিল। নতুন নামটি কেন আরও যথাযথ মনে করি, তা পরিশিষ্টে ব্যাখ্যা করেছি।
সুপারপজিশন
পুনরাবৃত্ত সাধারণীকরণ বিশেষ দুঃসাহসী কোনো ব্যাখ্যা নয়। বলা যায়, সাধারণ সাধারণীকরণ থেকে আমাদের যা আশা করা উচিত, এটা তা-ই। কিন্তু বহুঅর্থকতার আরেকটি ব্যাখ্যাও প্রস্তাব করা হয়েছে, যা অনেক বেশি দুঃসাহসী: শেখার নতুন একটি নীতি।
সবখানে শেখার যে প্রধান নীতি আমরা দেখি, তা হলো সাধারণীকরণ। সাধারণীকরণে বিষয়গুলোকে একসঙ্গে রাখা হয় কোনো অভিন্ন প্যাটার্নের কারণে। সেটিকে এক জায়গায় রাখা কাজে লাগে, যাতে তার ওপর ভর করে আরও কিছু গড়া যায়। সুপারপজিশনে সম্পর্কহীন বিষয়গুলোকে একসঙ্গে রাখা হয়, কারণ তারা একে অন্যের কাজে বাধা দেয় না। এই দুটো থেকে বিপরীত পূর্বানুমান আসে: সাধারণীকরণ হওয়ার কথা কাছাকাছি বিষয় ধরে, আর সুপারপজিশন দূরের বিষয় ধরে। কারণ সুপারপজিশনে খুব আলাদা বিষয়গুলোকে পাশাপাশি রাখতে চাওয়ার কথা।
সাধারণীকরণ চাইবে ঝোলা কানের কুকুরের নিউরন। একে ভাবা যায়, নানা কোণ থেকে দেখা আর নানা ধরনের সামান্য আলাদা অনেক ঝোলা কানকে একসঙ্গে রাখা। সুপারপজিশন চাইবে ঝোলা কানের কুকুর + লাতিন কবিতার নিউরন।

ধারণাটি বোঝানোর জন্য আঁকা। দুই প্যানেলেই একই 32টি বিষয় আছে; কাছাকাছি রং আর আকৃতি বোঝায় কাছাকাছি ধরনের বিষয়। নিউরন কম হলে সাধারণীকরণ করা নিউরনগুলো আরও মোটা দাগের হয়, কখনো টুকরো টুকরো হয়ে ছড়ায় না। কোনো নিউরনের ওপর মাউস রাখুন বা ট্যাপ করুন, দুই প্যানেলেই তার বিষয়গুলো দেখতে পাবেন।
এখানে সংজ্ঞাগুলো জট পাকিয়ে যায়। সুপারপজিশনের পাশাপাশি Zoom In[4] নিউরাল নেটওয়ার্কের মৌলিক একক হিসেবে ফিচারের ধারণাটিও সামনে এনেছিল। কোথায় দেখছেন, তার ওপর নির্ভর করে সুপারপজিশন বলতে তখন বোঝায় হয় “মাত্রার চেয়ে ফিচারের সংখ্যা বেশি”—যে শর্ত পুরোপুরি একার্থক একটি নেটওয়ার্কও পূরণ করবে, কারণ তার নিউরনগুলো মিলেমিশে নতুন কিছু গড়ে তোলে—অথবা ওপরের মতো একটি শেখার নীতি, যা কখনো প্রয়োগ করা হয় নিউরন কী শেখে তার ওপর, কখনো ফিচার কোথায় জায়গা পায় তার ওপর।⁴
⁴ যেমন, InceptionV1-এর 4b স্তরে গাড়ির নানা অংশ—জানালা, বডি, চাকা—চেনার জন্য মোটামুটি একার্থক নিউরন আছে। পরের স্তর সেগুলো জুড়ে গাড়ির একটি নিউরন তৈরি করে, 4c:447। ফিচারের দৃষ্টিতে বলা যুক্তিসংগত যে “গাড়ি ফিচার” শুধু 4c:447-এ নেই, তাকে গড়ে তোলা 4b-এর নিউরনগুলোর সমন্বয়েও আছে। তাহলে পাশাপাশি দুই স্তরে গাড়ির দুটি ফিচার থাকল, যাদের কাজের প্রক্রিয়া প্রায় হুবহু এক। “মাত্রার চেয়ে ফিচারের সংখ্যা বেশি” সংজ্ঞায় প্রথমটি সুপারপজিশনে আছে, দ্বিতীয়টি না-ও থাকতে পারে। অনানুষ্ঠানিক নোট Distributed Representations: Composition & Superposition-এ যেভাবে বলা হয়েছে, সে অর্থে প্রথমটি ছড়ানো, তবে সংযোজনের মাধ্যমে; আর দ্বিতীয়টি আদৌ ছড়ানো নয়। অনুমান করে নেওয়া ফিচার দিয়ে ভাবতে আমার অসুবিধা হয়, তার একটা কারণ এটা। তাই সাধারণত আমি নিউরনের মতো নির্দিষ্ট কার্যপ্রক্রিয়া আর ডেটার নির্দিষ্ট নমুনা নিয়ে ভাবতেই পছন্দ করি।
তাহলে “সুপারপজিশন” শব্দটিই তার কয়েকটি প্রচলিত ব্যবহারের মধ্যে সুপারপজিশনে আছে। আমরা নজর দিচ্ছি নিউরনের মতো কার্যপ্রক্রিয়ায় প্রযোজ্য শেখার নীতিটির দিকে, কারণ সেটি সত্যিই গড়ে ওঠে কি না, ব্যাখ্যাযোগ্যতার জন্য ভালো বা খারাপ খবরের অস্বাভাবিক বড় একটা অংশই তার ওপর নির্ভর করে। পরীক্ষা করাও বেশ সহজ: পুনরাবৃত্ত সাধারণীকরণ আর সুপারপজিশন প্রায় বিপরীত দুটি ঘটনার পূর্বাভাস দেয়, আর আপনি একটি নিউরনকে গড়ে উঠতে দেখে বুঝতে পারেন কোনটি ঘটছে।
এই লেখায় সুপারপজিশন বলতে আমি এই অর্থটিই বোঝাচ্ছি। “মাত্রার চেয়ে ফিচারের সংখ্যা বেশি”—এই প্রশ্নে পরে আসব; আমার মূলত মনে হয় না সেটা খারাপ খবর।
ব্যাখ্যার ফাঁকে সুপারপজিশন
বহুঅর্থকতা প্রায়ই নিউরনের চেয়ে পর্যবেক্ষক সম্পর্কে বেশি কিছু বলে। কথাটার মানে, এখনো ভালো ব্যাখ্যা পাওয়া যায়নি। তার কয়েকটি কারণ থাকতে পারে:
1. দুর্বল যন্ত্র: আমাদের লেন্স বা অণুবীক্ষণযন্ত্র যথেষ্ট ভালো নয়
2. দুর্বল ব্যাখ্যা: ওই যন্ত্রগুলো দিয়ে যা তৈরি হয়েছে
3. দুর্বল শেখা: খারাপ স্থাপত্য, প্রশিক্ষণের ডেটা বা অন্য কোনো কারণে নেটওয়ার্ক ভালোভাবে শেখেনি
4. পুনরাবৃত্ত সাধারণীকরণ: সাধারণীকরণ করতে করতে নিউরনটি সম্পর্কিত কয়েকটি দিকে শাখা ছড়িয়েছে
5. সুপারপজিশন: শেখার নীতিতে এমন এক বদল, যেখানে নেটওয়ার্ক পরস্পর-অসম্পর্কিত জিনিস একই নিউরনে গুঁজে রাখে, কারণ তাদের একসঙ্গে এসে সংঘাত বাধানোর ঘটনা বিরল।
বছরের পর বছর আমি সুপারপজিশনের একনিষ্ঠ বিশ্বাসী ছিলাম। ভাষা-মডেলের নিউরন নিয়ে পড়াশোনা শুরু করেছিলাম নিউরন বা সুপারপজিশনে আগ্রহ থেকে নয়; আমার কৌতূহল ছিল, এজেন্টদের গবেষণার ভালো-মন্দ বোঝার বোধ আছে কি না! ব্যাখ্যা পরীক্ষা করতে গিয়ে তারা ভালো প্রশ্ন করে কি না, সেটাই দেখতে চেয়েছিলাম। তুলনার একটা প্রাথমিক মানদণ্ড পেতেই শুধু নিউরন দিয়ে শুরু করি। ভেবেছিলাম, তারা সুপারপজিশনে এমন সব ফিচারের টুকরোর মুখোমুখি হবে, যার জট ছাড়ানো অসম্ভব। তাতে নিউরন আসলে কতটা পরিষ্কার, তার একটা নতুন মানদণ্ড পাওয়া যাবে; তারপর এজেন্টরা শেখার মাধ্যমে পাওয়া আরও পরিষ্কার কোনো বেসিস নিয়ে এগোতে পারবে। কিন্তু সেই মুহূর্ত আর এল না। একের পর এক নিউরন আসতে থাকল, আর তাদের প্রত্যেকেরই একটা সরল ব্যাখ্যা মিলতে থাকল; সেই ব্যাখ্যা থেকে এমন সব চমকপ্রদ পূর্বাভাস পাওয়া যাচ্ছিল, যা পরীক্ষাতেও টিকে যাচ্ছিল।
একটি অগ্রসারির ভাষা-মডেলে এমন একটি নিউরন পেলাম, যা মূলত “pr”-তে সক্রিয় হয়, কিন্তু একগুচ্ছ Base64 URL স্ট্রিং আর কিছু বাংলা লেখাতেও সাড়া দেয়। ভাবলাম, শেষ পর্যন্ত নিশ্চয়ই একটা এলোমেলো মিশ্রণ পাওয়া গেল। কিন্তু URL-গুলো ডিকোড করলে দেখা যায়: “pr”-ওয়ালা শব্দ। বাংলা অংশ অনুবাদ করলে: “pr”।
ব্যাখ্যাচিত্র: ডিকোড বা লিপ্যন্তর করলে আপাত গোলমালটাও দেখা যায় “pr”।
একটি ডেন্স Qwen মডেলে আমার এক সহকর্মী এমন একটি নিউরন পেলেন, যাকে প্রচলিত top-k স্বয়ংক্রিয় ব্যাখ্যাযোগ্যতা-পদ্ধতি “বহুঅর্থক কমা নিউরন” বলে চিহ্নিত করে। কিন্তু একটু খুঁটিয়ে দেখতেই বোঝা গেল, সেটি কলোরাডোর খোঁজ রাখে: ফোন নম্বর, কথ্য ভাষার বিশেষ শব্দ, আর কলোরাডো-সংশ্লিষ্ট অন্য নিউরনের সঙ্গে সংযোগ। নিউরনটির সক্রিয়তা বদলে মডেলের আচরণে প্রভাব ফেলতেই মডেল হাইকিংয়ে যেতে চাইল। কমাগুলো ছিল সেই জায়গা, যেখানে সে ততক্ষণ পর্যন্ত পাওয়া কলোরাডো-সংক্রান্ত প্রসঙ্গের চলমান সারসংক্ষেপ জমা রাখছিল। সাধারণভাবে অ্যাটেনশনকে যতিচিহ্নে জড়ো হতে দেখা যায়; এই গঠনধারাকে আমরা বলি সারসংক্ষেপের গঠনধারা বা summary motif। এটা চিনে গেলে একই রকম অনেক নিউরন বোঝা সহজ হয়ে যায়।

কলোরাডো আসার আগে কমাগুলো অনুজ্জ্বল থাকে; কলোরাডো-প্রসঙ্গ জমতে থাকলে তারাও উজ্জ্বল হয়ে ওঠে। নিউরনটির সক্রিয়তা বদলালে মডেল হাইকিংয়ের পরিকল্পনা করে।
অন্য সময় দেখা গেছে, আমাদের হাতে যথেষ্ট ডেটাই ছিল না। শুরুতে দীর্ঘ প্রসঙ্গ রাখিনি; মনে হয়েছিল, দুই অনুচ্ছেদই যথেষ্ট। কিন্তু এর ফলে অনিচ্ছাকৃতভাবে দীর্ঘ প্রসঙ্গ নিয়ে কাজ করা সব নিউরনকে বহুঅর্থক মনে হচ্ছিল।

শুধু শেষ অনুচ্ছেদটি দেখলে মনে হয়, নিউরনটি কফি আর বিশ্ববিদ্যালয় নিয়ে কাজ করে; আসল কারণটা রয়েছে আরও ওপরে।
আরেকটি ক্ষেত্রে নিউরনকে দেখে লাগছিল পুরোপুরি এলোমেলো এক জট, কোনো কিছুতেই জোরালোভাবে সক্রিয় হচ্ছে না। পরে বোঝা গেল, সেটি স্বাস্থ্যবিষয়ক SEO স্প্যামের পাতায় কিছু নির্দিষ্ট চিহ্ন খুঁজছিল। যথেষ্ট বিস্তৃত ডেটাসেট হাতে আসার পর তাকে বোঝা গেল।
এ রকম শত শত ঘটনা দেখেও সুপারপজিশনে আমার বিশ্বাস টলেনি। শুধু তার ঠিকানা বদলাচ্ছিল। জোরালো সক্রিয়তাগুলো পরিষ্কারভাবে ব্যাখ্যা করা গেলে সুপারপজিশন সরে যেত দুর্বল সক্রিয়তায়, বা কয়েকটি নিউরনের সমন্বয়ে, কিংবা যেসব নিউরন তখনো দেখিনি সেগুলোতে। অথবা হয়তো স্তরগুলোর মধ্যেই ছড়িয়ে আছে।
কিন্তু একসময় ভাবতে শুরু করলাম, হচ্ছেটা কী? যদি না এটা বাছাইজনিত পক্ষপাতের এক অস্বাভাবিক, দীর্ঘায়িত উদাহরণ হয়ে থাকে, তবে শুরুর দিকের পরীক্ষামূলক মডেলগুলোর সঙ্গে কোথাও একটা মিলছিল না। তাই ফিরে গিয়ে আবার দেখলাম। আদি প্রমাণগুলো আর টিকল না, আর সেখান থেকেই এই লেখা।
এখন মনে হয়, সুপারপজিশনকে আমি শূন্য অনুমান (null hypothesis) করে নিয়েছিলাম, অথচ সেটি হওয়া উচিত ছিল শেষ অনুমান; কারণ এটিই সবচেয়ে আমূল ব্যাখ্যা, আর পরীক্ষা করাও সবচেয়ে কঠিন। তার চেহারা শুধু এটুকুই: কিছু জিনিসের মানে বোঝা যাচ্ছে না। কিন্তু দুর্বল যন্ত্রের চেহারাও তো তাই (ফিচারের চিত্রায়নে রিওয়ার্ড হ্যাকিং), অথবা এমন পুনরাবৃত্ত সাধারণীকরণ যার পথ আপনি এখনো অনুসরণ করেননি (“iy” নিউরন), কিংবা খারাপ স্থাপত্য (InceptionV1-এর 5b), অথবা এমন সাধারণীকরণ যা এখনো বোঝেননি (বিড়াল আর গাড়ি)।
আমার মনে হয়, এর পেছনে আংশিক কারণ ছিল সুপারপজিশনকে স্রেফ ঠিক বলে মনে হতো। Anthropic-এর Softmax Linear Units[20] গবেষণাপত্রে 2022 সালেই কথাটা বলা হয়েছিল: “প্রক্রিয়াগত ব্যাখ্যাযোগ্যতা নিয়ে কাজ করেন যাঁরা, তাঁদের মধ্যে সুপারপজিশনকে প্রায়ই শুরুর অনুমান হিসেবে ধরা হয়, শুধু এই কারণে যে অন্য ব্যাখ্যার চেয়ে একে স্বতঃস্ফূর্তভাবে বেশি বিশ্বাসযোগ্য মনে হয়; কিন্তু প্রমাণ খুবই সামান্য।”⁵ আমার জানা মতে, আমার সেই প্রথম সার্কিটটির পর বাস্তব নেটওয়ার্কে আর কেউ কোনো সুপারপজিশন সার্কিট খুঁজে পাননি; আর আমারটিও ছিল ভুল। পাওয়ার আশা নিয়ে খুঁজেও বাস্তব মডেলে সে রকম কিছু দেখি না। আমার মনে হয়, এমন দাবি করার জন্য প্রমাণের মানদণ্ড বেশ উঁচু হওয়া উচিত। কারণ ব্যাখ্যাটি এতটাই আমূল যে সত্যি হলে, নিউরাল নেটওয়ার্ক কীভাবে অধ্যয়ন করা উচিত সে বিষয়ে সেটা হবে বড় খবর—ভীষণ খারাপ খবর।
⁵ পরের বাক্যেই গবেষণাপত্রটি বলে, তাদের নিজেদের ফলাফল সুপারপজিশনের পক্ষে মাঝারি মাত্রার প্রমাণ। গবেষণাপত্রটির নিজের ভাষাতেই, সেই প্রমাণ পারিপার্শ্বিক: SoLU অনেক নিউরনজুড়ে ছড়িয়ে থাকা সক্রিয়তাকে দমন করে, বাড়তি একটি LayerNorm কর্মক্ষমতা ফিরিয়ে আনে, আর LayerNorm-এর পরে কোনো নিউরনের দুর্বল সক্রিয়তাগুলোকে তার মূল কাজের সঙ্গে কম সম্পর্কিত দেখায়। গবেষণাপত্রটি এর মানে করেছে, ছোট ছোট সক্রিয়তার মধ্য দিয়ে ফিচার চোরাপথে পার হয়ে যাচ্ছে। আমাদের কাছে এটা এমন একটি স্থাপত্যে ছড়ানো উপস্থাপনার প্রমাণ, যা সেই ছড়িয়ে থাকাকেই দমন করার জন্য বানানো; নিউরন যে পরস্পর-অসম্পর্কিত জিনিস একসঙ্গে গুঁজে রাখছে, তার প্রমাণ নয়। আমরা এই দ্বিতীয় অর্থটি নিয়েই ভাবছি। দুর্বল সক্রিয়তায় দুটির তফাত ধরা আজকের যন্ত্র দিয়েও কঠিন, কারণ সক্রিয়তা কমতে থাকলে অর্থ একই সঙ্গে সব দিকে সরে যেতে থাকে। 2022 সালে আমাদের সবার জন্যই কাজটা আরও কঠিন ছিল। গবেষণাপত্রটি এ-ও জানায়, সুপারপজিশন নিয়ে তাদের আলোচনা পরে Toy Models of Superposition-এর আলোচনায় প্রতিস্থাপিত হয়েছে; পরিশিষ্টে আমরা সেটি নিয়ে কথা বলেছি। কোনো গবেষণাপত্রের সমালোচনা করতে কথাটা তুলছি না। আমাদের জানা মতে, এটাই একমাত্র জায়গা যেখানে বাস্তব জগতের প্রমাণ কত অল্প ছিল, কেউ তা সোজাসুজি বলেছেন। আমাদের মনে হয়, মানুষ এখনো প্রায়ই ধরে নেন, যতটা প্রমাণ আছে তার চেয়ে অনেক বেশি আছে।
অবশ্য এতে উল্টো ভুলের ঝুঁকি আছে: ব্যাখ্যার ফাঁককে আরেক ব্যাখ্যা দিয়ে ভরাট করা, অর্থাৎ ধরে নেওয়া যে প্রতিটি নিউরনের পেছনেই নিশ্চয়ই অর্থপূর্ণ কোনো গল্প আছে। দুটো কারণে এই দুশ্চিন্তা কিছুটা কমে। প্রথমত, অন্য প্রতিটি কারণ পরীক্ষা করা যায়। আরও ভালো যন্ত্র দিয়ে হয় নিউরনটি বোঝা যাবে, নয় যাবে না; আরও ভালো স্থাপত্যে নতুন করে প্রশিক্ষণ দিলে বোঝা যাবে শেখাতেই সমস্যা ছিল কি না; আর পুনরাবৃত্ত সাধারণীকরণ কীভাবে ছোট ছোট ধাপে গড়ে ওঠে, তা চোখের সামনে দেখা যায়। সুপারপজিশনের একমাত্র লক্ষণ হলো, কোনো কিছুর মানে বোঝা যাচ্ছে না। দ্বিতীয়ত, সত্যিকারের ব্যাখ্যাগুলো সাধারণত সুনির্দিষ্ট হয়, পরীক্ষা করাও সহজ। একবার সন্দেহ হলো কোনো নিউরন কলোরাডোর নিউরন, তার সক্রিয়তা বদলে দেখুন মডেল কী বলে। কোনো নিউরন যদি টিভির খুব নির্দিষ্ট কোনো চেনা কাহিনির ছকে সাড়া দেয়, তবে সেই ব্যাখ্যার আওতায় পড়তে পারে এমন জিনিসের পরিসর খুবই ছোট; অথচ “যার মানে বোঝা যাচ্ছে না” কথাটা তার বাইরে বাকি সবকিছুকে ঢেকে ফেলে।
তা ছাড়া, যে ব্যাখ্যা আমাদের নেই, তা জোর করে দাঁড় করানোরও দরকার নেই। কোনো নিউরন হয়তো দু-একটি অসম্পর্কিত কাজ করে, আর আপনি নিশ্চিত নন—সেটা বলতেই পারেন। আমার মনে হয়, সম্ভাব্য কারণের তালিকায় পুনরাবৃত্ত সাধারণীকরণকে ওপরের দিকে রাখা উচিত। প্রশিক্ষণের বিভিন্ন পর্যায়ে সংরক্ষিত চেকপয়েন্ট থাকলে পরীক্ষা করাও সহজ। এখন আমার মনে হয়, সুপারপজিশন থাকা উচিত তালিকার অনেক নিচে।
ছবি নিয়ে কাজ করা মডেলগুলো খতিয়ে দেখা
ছোট ছবি-মডেলগুলোকে সেকেলে মনে হতে পারে। কিন্তু আমার মনে হয়, এই প্রশ্নে তারা খুবই গুরুত্বপূর্ণ, কারণ তাদের আমরা এত স্পষ্টভাবে দেখতে পাই। মূল উদ্বেগের অনেকখানির শুরুটাও সেখানে: আমরা যা দেখেছিলাম, তা কম রেজল্যুশনের অস্পষ্টতা নয়, বরং উচ্চ রেজল্যুশনে দেখা বিশৃঙ্খলা বলেই মনে হয়েছিল। ভাষা-মডেলগুলো বিশাল; কাজ সহজ করে দেয় এমন ফিচারের চিত্রায়নের মতো যন্ত্র আমাদের হাতে নেই; অ্যাটেনশন নানা ধরনের কার্যপ্রক্রিয়া মিশিয়ে দেয়; আর তাদের অনেক গঠনধারাই অপ্রত্যাশিত। ওপরে যেমন দেখিয়েছি, ছবি চেনার গঠনধারাও স্বাভাবিক ধারণার উল্টো হতে পারে; ভাষায় অবস্থা আরও কঠিন। এই প্রতিটি ঘাটতিই একার্থক নিউরনকে বহুঅর্থক বলে মনে করাতে পারে। ঝাপসা ছবি দেখে যদি বোঝার চেষ্টা করেন ওটা কুকুর না বিড়াল, ঝাপসা ভাব কাজটা কঠিন করে, কিন্তু কোনো একটি উত্তরের পক্ষ নেয় না। আর ঝাপসা ছবি দেখে যদি বোঝার চেষ্টা করেন ছবিটাই ঝাপসা, নাকি আপনার দেখায় সমস্যা, তবে আপনার দৃষ্টির প্রতিটি খুঁতই ছবির ঝাপসা ভাব হিসেবে ধরা পড়ে। মডেলের আকার, কম জায়গায় ধরানোর চাপ, সক্রিয়তার তীব্রতা আর গভীরতার সঙ্গে নিউরন কীভাবে বদলায়, তা অধ্যয়ন করতে চাইলে যেখানে পরিষ্কার দেখা যায়, সেখান থেকেই শুরু করা ভালো।
আমি তিনটি ConvNeXt মডেল প্রশিক্ষণ দিয়েছি, যাদের সবচেয়ে ছোট থেকে সবচেয়ে বড়টির আকারের ফারাক প্রায় 300×: ছোটটির প্যারামিটার 92k, মাঝারিটির 7.06M (InceptionV1-এর সমান), আর বড়টির 28.6M। আমরা এগুলো দেখব, সঙ্গে InceptionV1-ও, যেন বুঝতে পারি নানা পরিস্থিতিতে নিউরন কী করে, আর কোথায় অসম্পর্কিত জিনিস গুঁজে রাখার ঘটনা ঘটতে পারে তা খুঁজে দেখতে পারি।
নিউরন নিয়ে আমি যেভাবে ভাবি
আগে নিউরনকে ভাবতাম মানুষের ধারণার ছাঁচে গড়া বিশেষ্য হিসেবে: একটি গাড়ি, আরেকটি বাঁক। এখন তাদের অনেক বেশি করে ভাবি প্রবাহ নিয়ন্ত্রণের ব্যবস্থা হিসেবে। একটি নিউরন কী দেখে, তার চেয়ে বড় কথা হলো ভেতরে আসা প্রবাহের সঙ্গে সে কী করে; প্রায়ই তার কাজ নেটওয়ার্কের একটি অঞ্চলের দরজা সামলানো। এভাবে দেখলে একার্থকতার প্রশ্নটাই প্রায় ভুল প্রশ্ন হয়ে দাঁড়ায়। তার চেয়ে ভালো প্রশ্ন, একটি নিউরন কী ভেতরে ঢুকতে দেয় আর কী আটকে রাখে।
পিক্সেল ঢোকে, আর নেটওয়ার্ক জিনিসগুলোকে একত্র করা ও আলাদা করা শুরু করে। গাড়ি আর কুকুরের ভঙ্গিতে মিল থাকায় তাদের এক দলে রাখা হতে পারে। আরও সামনে গাড়ি চেনার নির্দিষ্ট ডিটেক্টর আছে—ট্যাক্সি, অ্যাম্বুলেন্স ইত্যাদির জন্য—আর তারা কুকুর চায় না। তাই তাদের আগের একটি নিউরন দরজার কাজ করে: গাড়িতে ধনাত্মক সাড়া দেয়, কুকুরে ঋণাত্মক; তার ঋণাত্মক দিকটি কুকুরকে বাইরে রাখে। কুকুর চলে যায় নিজের অঞ্চলে, যেখানে আর গাড়ি নিয়ে মাথা ঘামাতে হয় না। পরের নিউরনগুলো এর ওপর দাঁড়িয়ে আরও নির্দিষ্ট কাজ শেখে: অ্যাম্বুলেন্সের নিউরনের ঋণাত্মক মেরুতে থাকতে পারে ট্যাক্সি, আর ট্যাক্সিরটিতে অ্যাম্বুলেন্স। বড় মডেলে এই পার্থক্য আরও সূক্ষ্ম হতে পারে, ট্যাক্সির এক দিক থেকে দেখা চেহারাকে অন্য দিক থেকে দেখা চেহারা থেকে আলাদা করতে পারে। ছোট মডেল হয়তো মোটাদাগের পার্থক্যেই থামে, সাধারণ একটি “গাড়ি” নিউরনের কাছাকাছি কিছু নিয়ে।

গোড়ার দিকে একই ধরনের ভঙ্গির জন্য গাড়ি আর কুকুর একসঙ্গে থাকে; গাড়ি-ডিটেক্টরগুলোর আগের একটি দরজা গাড়িকে ঢুকতে দেয়, আর তার ঋণাত্মক দিক দিয়ে কুকুরকে ফিরিয়ে দেয়।
এখানে একটি সত্যিকারের স্পোর্টস কারের গতিপথ অনুসরণ করা হয়েছে আমাদের বড় মডেলের শেষ পাঁচটি ব্লকজুড়ে। মাঝপথে সেটিকে টেবিল আর ক্যাবিনেটের মতো অন্য আয়তাকার জিনিসের দলে রাখা হয়, সাপ আর কুকুরের বিপরীতে। শেষ ব্লকে এসে ভাগটা হয়ে দাঁড়ায় কনভার্টিবল, অর্থাৎ ছাদ খোলা যায় এমন গাড়ি, বনাম স্টেশন ওয়াগন।
বেছে নেওয়া একটি স্পোর্টস কারের গতিপথ অনুসরণ করা হয়েছে ConvNeXt large-এর 18টি ব্লকের শেষ পাঁচটি জুড়ে। প্রতিটি কলামে সেই নিউরনটি আছে, যা এই ছবির ক্ষেত্রে পরের নিউরনটিতে সবচেয়ে বেশি অবদান রাখে (শেষটি অবদান রাখে স্পোর্টস কার আউটপুটে)। রেখার ওপরে আছে যাদের সঙ্গে গাড়িটিকে এক দলে রাখা হচ্ছে; নিচে আছে যাদের থেকে তাকে আলাদা করা হচ্ছে।
নিউরন বুঝতে তাদের ঋণাত্মক দিক প্রায় ধনাত্মক দিকের মতোই গুরুত্বপূর্ণ, এমনকি ReLU নেটওয়ার্কেও, যেখানে ঋণাত্মক দিক কেটে বাদ দেওয়া হয়। একটি নিউরন গড়ে ওঠে ভোট দিয়ে: প্রতিটি ইনপুট ওজন তার ধনাত্মক বা ঋণাত্মক দিকের পক্ষে ভোট দেয়, আর ননলিনিয়ারিটি প্রয়োগের আগে ভোটগুলো যোগ হয়। ঋণাত্মক দিক নিজে কখনো গ্রেডিয়েন্ট পায় না; কিন্তু নিউরন চালু থাকলে পৃথক ভোটগুলো পায়। তাই শেখার প্রক্রিয়া ঋণাত্মক দিকটিকেও গড়ে তোলে। তার অর্থ নির্ভর করে প্রসঙ্গের ওপর: স্পোর্টস কারের পথে থাকা একটি নিউরন যখন তাকে সাপ আর কুকুর থেকে আলাদা করে, তখন সে গাড়ি আর কুকুরকে পরস্পরের বিপরীত বলছে না; আগে সুবিধার জন্য এক দলে রাখা কিছু জিনিসকে দরজায় আটকে দিচ্ছে। সার্কিটের এই জায়গায় কোন পার্থক্যটি জরুরি, ঋণাত্মক দিক আমাদের তা জানায়। ফলে কোনো দলবদ্ধতা সত্যি কি না, তাড়াতাড়ি যাচাই করতেও এটি কাজে লাগে: V নিউরনের ঋণাত্মক দিকে আছে O।
শেষ স্তরে তাকালে আমরা উঁচু স্তরের ধরনগুলো দেখি, সঙ্গে দেখি তাদের কী থেকে আলাদা করা হচ্ছে: ট্যাক্সিকে অ্যাম্বুলেন্স থেকে, ব্রকলিকে ফুলকপি থেকে, আর চামচঠুঁটি পাখিকে ফ্লেমিঙ্গো থেকে।
ConvNeXt large-এর শেষ স্তরের নিউরন: প্রতিটি একটি ধরনে সাড়া দেয়, আর তার ঘনিষ্ঠভাবে সম্পর্কিত আরেকটি ধরনে ঋণাত্মক সাড়া দেয়।
আমাদের সবচেয়ে ছোট মডেলে তাকালে দেখি নিউরনগুলো আরও মোটাদাগে কাজ করছে। তার শেষ স্তরে একটি নিউরনেই গাড়ি, ট্রেন আর ঠেলাগাড়ি এসে থামে; ঋণাত্মক দিকে থাকে নৌকা, প্লেন আর পানির ওপর চলা এক ধরনের বলদে-টানা গাড়ি (যার অস্তিত্বই আমি জানতাম না)। তফাত সে তখনো করছে, তবে মোটা দাগে; আর কাজটা আগেই থেমে যাচ্ছে।
ছোট মডেলের শেষ স্তরের একটি নিউরন: ধনাত্মক দিকে স্থলযান, ঋণাত্মক দিকে নৌকা আর প্লেন।
চাপে পড়লে নিউরন কী করে
বেশির ভাগ ছবি চেনার মডেলের শুরুর স্তরগুলো একার্থক। আমার বোঝা মতে, প্রচলিত ব্যাখ্যা হলো, গোড়ার দিকের দৃশ্যগত ফিচারের সংখ্যা এত বেশি নয় যে সেগুলো উপস্থাপন করতে জায়গা কম পড়বে। ওপর-ওপর দেখলে ব্যাপারটা একটু অদ্ভুত: AlexNet, ResNets, InceptionV1 থেকে CLIP পর্যন্ত সব মডেলেই গোড়ার ফিচার আর গোড়ার নিউরনের অনুপাত ঠিকঠাক মিলে যায়, যদিও ডেটাসেটের আকারের সঙ্গে প্যারামিটারের সংখ্যার অনুপাত একেকটির একেক রকম।
আমরা InceptionV1-এর 3b স্তরে নজর দিতে পারি। এই স্তরে আছে Curve Neurons আর High-Low Frequency neurons—আমার মতে, সবচেয়ে মৌলিক নিউরনগুলোর কয়েকটি। এই মডেলে রেসিডুয়াল স্ট্রিম নেই, ফলে নিউরনগুলোকে “পাশ কাটিয়ে বয়ে যাওয়ার” পথও নেই। তাই নিউরনের সংখ্যা 480 থেকে 10-এ নামিয়ে আবার প্রশিক্ষণ দিয়ে পরীক্ষা করা যায়, জায়গা কম পড়লে নিউরনের কী হয়।
যদি সে সুপারপজিশনে চলে যায়, তাহলে আমাদের একটার ওপর আরেকটা চাপা মিশ্রণ দেখার কথা: যেমন, একটি বাঁকের সঙ্গে কমলা রঙের সর্পিল, মাকড়সার জাল আর আরও কয়েকটি টেক্সচার ডিটেক্টর। আমরা জায়গা 48x কমিয়েছি, তাই ব্যাপারটা চোখে পড়ার মতোই হওয়ার কথা!
কিন্তু দেখা যায় অন্য কিছু। নিউরনগুলোকে তখনো বোঝা যায়, তারা তখনো সাধারণীকরণ করে, তবে আরও মোটা দাগে: দশটি বাঁক-ডিটেক্টরের জায়গায় একটি “বাঁক ও লুপ” নিউরন, নানা ধরনের বৃত্তের জায়গায় দুটি বৃত্তের নিউরন, এ রকম।
InceptionV1-এর 3b স্তর 480টি নিউরন থেকে 10টিতে নামিয়ে একেবারে গোড়া থেকে আবার প্রশিক্ষণ দেওয়া হয়েছে; স্তরটিকে পাশ কাটানোর কোনো পথ রাখা হয়নি। প্রতিটি সারিতে একটি নিউরন আর বাস্তব ছবির সেই পাঁচটি কাটা অংশ আছে, যেগুলোতে তার সাড়া সবচেয়ে জোরালো। ImageNet-এ top‑1 নির্ভুলতা 58.35%, top‑5 নির্ভুলতা 81.14%।
বাঁকগুলোর কী হলো, তা সরাসরি পরীক্ষা করেও দেখা যায়। তাদের যদি নিউরনের কোনো উচ্চমাত্রিক সমন্বয়ে রাখা হয়ে থাকে, তাহলে আমাদের সেখান থেকে তাদের বের করে আনতে পারার কথা। তাই সংকুচিত এই স্তরের ওপর একটি SAE প্রশিক্ষণ দিয়ে ফলগুলোকে মূল নিউরনগুলোর সঙ্গে তুলনা করতে পারি। পরিষ্কার বাঁক-নিউরনের মতো কিছুই দেখা যায় না!
InceptionV1-এর 3b স্তর 10টি নিউরনে সংকুচিত করে আবার প্রশিক্ষণ দেওয়া হয়েছে, তারপর একটি স্পার্স অটোএনকোডার দিয়ে ফের প্রসারিত করা হয়েছে। মূল বাঁক-ডিটেক্টরগুলোর প্রতিটির জায়গায় দেখানো হয়েছে অটোএনকোডারের সবচেয়ে কাছাকাছি ফিচারটি: বিস্তৃত আর জটলা পাকানো, আলাদা দশটি বাঁক নয়।
আমার ভালো করে চেনা একটি একার্থক স্তরকে সুপারপজিশনে নিয়ে যাওয়া যায় কি না, সেটা দেখার জন্য আমার মনে হয় এটি ভালো পরীক্ষা। তবে কোনো কোনো দিক দিয়ে আদর্শ নয়, কারণ সুপারপজিশনের সন্দেহটা মানুষের মূলত শেষের স্তরগুলো নিয়েই ছিল। তাই আমরা মাঝারি আকারের ConvNext নিতে পারি, শেষ স্তরটাকে সংকুচিত করতে পারি, রেসিডুয়াল স্ট্রিম দিয়ে পাশ কাটিয়ে যাওয়ার পথ বন্ধ করতে পারি, তারপর দেখতে পারি সে কী শেখে। সেখানেও দেখি একইভাবে কাজের পরিসর আরও বিস্তৃত হয়ে যাচ্ছে।
ছোট ConvNext-এও আমরা এটাই দেখি; কোনো কোনো দিক থেকে সেটিও খুব কাছাকাছি ধরনের পরীক্ষা।

মাঝারি ConvNeXt-এর শেষ স্তর 1,024টি নিউরন থেকে 13টিতে নামিয়ে গোড়া থেকে প্রশিক্ষণ দেওয়া হয়েছে। প্রতিটি নিউরনের সবচেয়ে জোরালো ধনাত্মক ও ঋণাত্মক সাড়া পাওয়া ছবিগুলো দেখানো হয়েছে।
শেষের দিকের সার্কিট
শেষ স্তরটিই কোনোভাবে বিশেষ কি না, সেই সম্ভাবনা বাদ দিতে আমরা শেষের দিকের অন্য স্তরগুলোর সার্কিটও দেখতে পারি। দেখা যায়, পুরো পথজুড়েই সুশৃঙ্খল বিন্যাস আছে।

মঠ। পাঁচটি সার্কিট; প্রতিটিতে বেছে নেওয়া কিছু সংযোগ ধরে পাঁচটি ব্লক পেরিয়ে শেষ স্তরের একটি নিউরন পর্যন্ত যাওয়া হয়েছে। প্রতিটি নিউরনের জন্য দেখানো হয়েছে একটি অপ্টিমাইজ করা ছবি আর ডেটাসেটের চারটি উদাহরণ।
ডিকশনারি কী শেখে
নিউরনের সমন্বয়ে যদি কিছু লুকিয়ে থাকত, তাহলে একটি ডিকশনারির (যেমন SAE) এমন গড়ার উপাদান খুঁজে পাওয়ার কথা, যা নিউরনগুলোর মধ্যে নেই। তাই এই স্তরগুলোর ওপর বেশ কয়েকটি প্রশিক্ষণ দিয়ে খুঁজতে নামলাম, নিজেও, এজেন্টদের নিয়েও। তেমন কিছু পেলাম না।
বেশির ভাগ ক্ষেত্রে দুটিকে তাদের প্রকৃত কাজের গঠন অনুযায়ী যেমন হওয়ার কথা, তেমনই দেখাল: নিউরনগুলো যেন গড়ার মৌলিক খণ্ড, আর SAE ইউনিটগুলো যেন প্রসঙ্গ অনুযায়ী সেই খণ্ডগুলোর দল। মাকড়সার বেলায় ব্যাপারটা সবচেয়ে পরিষ্কার ছিল। SAE ইউনিটগুলো ছিল নানা পরিবেশে থাকা মাকড়সা; নিউরনগুলো ছিল পায়ের বিন্যাস আর জাল। দুটোর মধ্যে খুব একটা অমিল ছিল না।
“এই ছবিতে কী আছে?” প্রশ্নে SAE সত্যিই সাহায্য করেছে। সবচেয়ে বেশি করেছে সবচেয়ে ছোট মডেলে, যার নিউরনগুলো মোটা দাগে কাজ করে। মাঝারি মডেলে SAE-কে সামান্য এগিয়ে রাখতাম; বড়টিতে মনে হয় নিউরনকেই বেশি পছন্দ করি। তবে আমার আগ্রহ যেকোনো একটি ছবি বোঝার চেয়ে নেটওয়ার্কটাকে বোঝায় বেশি। আর SAE এমন মৌলিক কিছু ধরতে পেরেছে, যা নিউরন পারেনি—এমন কখনো দেখিনি। কোনো একটি আকারের মডেল যদি বেসবল খেলোয়াড় বুঝতে না পারে, তার SAE-ও পারে না। মডেল যখন শেষ পর্যন্ত বেসবল খেলোয়াড় বুঝল, তখন সেটি একটি নিউরনেই ছিল।
আগে থেকেই যার সঙ্গে স্পষ্টভাবে মিলে যায় এমন কোনো নিউরন নেই, SAE এমন কী পেল? শেষ স্তরে তার সক্রিয়তার 88% আসে একেকটি নিউরনের প্রায় অনুলিপি থেকে, আর বাকিটা ক্ষীণ: ডিকশনারির যে দিকগুলোর সঙ্গে কোনো নিউরনের মিল নেই, তার সব কটি সরিয়ে দিলেও নির্ভুলতা একই থাকে; যে অল্প কয়েকটি উত্তর বদলায়, সেগুলো আগে থেকেই প্রায় সমানে সমান ছিল। আরও দেখা যায়, একটি স্তরের বিভিন্ন ঘূর্ণনের মধ্যে এমনটি খুঁজলে, যেখানে হাতে গোনা কয়েকটি ইউনিট সবচেয়ে বেশি সক্রিয়তা বহন করে, যেকোনো একটি এলোমেলো ঘূর্ণন থেকে শুরু করেও শেষে প্রতিটি ব্লকেই আবার নিউরনগুলোর কাছে ফিরে আসতে হয়। দেখার মতো যথেষ্ট জোরালো ফিচার যে কটি ছিল, সেগুলোতে SAE যা যোগ করেছিল তা হলো আগে থেকেই থাকা নিউরন দিয়ে গড়া কিছু আলগা দল: যেমন পানির ওপরিতলে থাকা প্রাণী, কিংবা ফ্যাকাশে রঙের দলা-দলা খাবার। সেখানে আমাদের পাওয়া কোনো কিছুই মৌলিকভাবে নতুন গড়ার উপাদান বলে মনে হয়নি।

বাড়তি প্রতিটি ফিচারের সঙ্গে দেখানো হয়েছে আগে থেকেই থাকা কোন নিউরনগুলো দিয়ে তা গড়া, আর প্রতিটির কতটুকু সে ব্যবহার করে। “সাধারণ ফিচার” অংশে আছে একেকটি নিউরনের প্রায় অনুলিপি, যা দিয়েই SAE-এর বেশির ভাগটা গড়ে ওঠে।
বিরল জিনিস আর মুখস্থ রাখা
লুকানো ফিচার নিয়ে উদ্বেগের বড় একটা অংশ আসে বিরল জিনিস থেকে। অন্য কিছুর সঙ্গে তাদের সংঘাত খুব কমই হয়, আর তাদের জন্য আলাদা একটি নিউরন খরচ করা সার্থক মনে না-ও হতে পারে। তাই যতভাবে মাথায় এসেছে, আমরা বিরল জিনিস খতিয়ে দেখেছি। বিরল শ্রেণিগুলো প্রায়ই আরও বেশি এক জায়গায় সংহত থাকে: ImageNet-এর জন্য কুকুরের অনেক রকম ধরন দরকার, কিন্তু ট্রাইসেরাটপসের জন্য একটি নিউরনই যথেষ্ট। শেষ পর্যায়ে দুর্বল সক্রিয়তা সরিয়ে দিলে কোনো একটি শ্রেণি আলাদা করে চোখে পড়েনি। মডেলকে ভুল করানোর জন্য তৈরি যে adversarial উদাহরণগুলোর পথ আমরা অনুসরণ করেছি, সেগুলোও অর্থগতভাবে স্বাভাবিক সার্কিটের পথই ব্যবহার করেছে।
শেষের স্তরগুলোতে যেসব ছবির উপস্থাপনা অন্য যেকোনো ছবির উপস্থাপনা থেকে সবচেয়ে দূরে, আমি সেগুলো দেখেছি। দেখা গেল, সেগুলো মজার, অদ্ভুত কিছু ছবি, যাদের সাধারণ নিউরন দিয়েই মডেল ভুল বুঝছে: একটি হামিংবার্ডকে আইসক্রিম, বিশাল একটি কলাকে ভল্ট, আর উল্টে পড়া ঠেলাগাড়িতে থাকা একজন লোককে ঘাস কাটার যন্ত্র ভাবছে। এলোমেলো নয়েজকে এলোমেলো লেবেলের সঙ্গে মেলানোর জন্য একটি ImageNet মডেলও প্রশিক্ষণ দিয়েছিলাম। এমনকি সেটিও আংশিকভাবে অর্থের সম্পর্ক ধরে কাজ করেছে: কিছুটা ভর করেছে উলের টেক্সচার আর দূরের গাছের টেক্সচারের ওপর, যেগুলো উচ্চ কম্পাঙ্কের, অনেকটা উচ্চ কম্পাঙ্কের নয়েজের মতো। মডেলটি পুরোপুরি খুঁটিয়ে পরীক্ষা করিনি, কিন্তু সে যে এগুলো আদৌ ব্যবহার করেছে, সেটাই আমার কাছে মজার লেগেছে। ভাষা আর ছবি নিয়ে সব পরীক্ষাজুড়েই মুখস্থ রাখার কাজটি আউটপুটের যত কাছে সম্ভব থাকতে চায়। কারণ তার কাজ শুধু উত্তরটা খুঁজে বার করা; আর শেষের স্তরগুলোই বেশির ভাগ কাজ করেছে।
অস্বাভাবিক ছবি, সাধারণ কার্যপ্রক্রিয়া। ওপরে: মাপা সাড়ার মানচিত্র। নিচে: প্রতিটি ছবির ক্ষেত্রে শেষ স্তরের সবচেয়ে সহায়ক নিউরনের বাস্তব উদাহরণ; সহায়তার মাত্রা মাপা হয়েছে অপসারণ-পরীক্ষা দিয়ে।
আমরা নিজেরাও একটি বিরল পথ তৈরি করতে পারি, আমাদের 7.06M-প্যারামিটারের মডেলকে অর্থহীন কিছু শিখিয়ে: ছাতার একটি ছবি আসলে মৌমাছি। কল্পনা করা যায়, এই মুখস্থ রাখা আর কোনো কিছুর ওপর ভর করবে না: একটি লুকানো ফিচার ঠিক এই পিক্সেলসমষ্টিকে আঁকড়ে ধরে বলবে “bee”, অর্থাৎ মৌমাছি, আর বাকি নেটওয়ার্ক থেকে বিচ্ছিন্ন থাকবে, কারণ তাকে আর কিছু লাগে না। সেটা বেশ খারাপ খবর হতো। কিন্তু বাস্তবে একেবারেই তা ঘটে না। প্রশিক্ষণের নয়টি ধাপে সবচেয়ে সম্ভাব্য উত্তর ছাতা থেকে গেল মে-পোল, অর্থাৎ উৎসবের সাজানো খুঁটিতে, তারপর মৌমাছিতে। ছাতার নিউরনগুলো নিস্তেজ হয়ে গেল, আর আগে থেকেই থাকা মৌমাছির নিউরনগুলো জ্বলে উঠল। প্রায় পুরোটাই ঘটল শেষ তিনটি ব্লকে: শুধু ওই ব্লকগুলো মূল মডেলে বদলে বসালেই সে বলে “bee” (মৌমাছি)।

একটি ছাতা মৌমাছির পথে চলে যায়। মডেল “bee” (মৌমাছি) শেখার আগে ও পরে এই ছবিতে প্রতিটি নিউরনের সাড়া দণ্ড দিয়ে দেখানো হয়েছে; ছোট দাগটি হলো সাধারণ কোনো ছাতা বা মৌমাছিতে তার সাড়া। ছবিগুলো দেখায়, প্রতিটি নিউরন আগে কিসে সাড়া দিত; রেখাগুলো হলো অপসারণ-পরীক্ষায় যাচাই করা সংযোগ।
অন্য সম্ভাবনাটি হলো, ছাতা বা মৌমাছির স্বাভাবিক যেকোনো পথ থেকে আলাদা এক ধরনের লুকানো ছাতা-ফিচার শেখা। সেটা সম্ভব হলেও আমার মনে হয়, আগে থেকেই সক্রিয় হচ্ছে আর আউটপুটে যাওয়ার পথ আছে এমন সম্পর্কিত অংশগুলো জুড়ে নেওয়ার তুলনায় এভাবে শিখতে বেশি সময় লাগে; আগে থেকে থাকা অংশগুলো ব্যবহার করলে বদলানোর নমনীয়তা আর গ্রেডিয়েন্ট পাওয়া যায়। লুকানো পথটি আরও ভঙ্গুরও হয়, আর আমরা কোথাও তা দেখছি না।

অর্থহীন একটি লেবেল মুখস্থ রাখার এক উপায় হতে পারে এমন একটি ফিচার, যার সঙ্গে অন্য কিছুর সংযোগ নেই। আমরা যা দেখি, তা হলো নেটওয়ার্কের আগে থেকেই থাকা দুটি পথের একটিকে ছেড়ে অন্যটিতে যাওয়ার একটি সংযোগপথ।
দুর্বল সক্রিয়তা কি গুরুত্বপূর্ণ?
দুর্বল সক্রিয়তা গুরুত্বপূর্ণ কি না, মানুষ যখন জানতে চায়, আমার মনে হয় তখন কয়েকটি আলাদা প্রশ্ন একসঙ্গে মিশে থাকে। আর তাদের উত্তরও আলাদা।
এগুলো সাধারণীকরণ, না সুপারপজিশন?
আশ্চর্য হওয়ার কিছু নেই, আমার মতে এগুলো সাধারণীকরণ। ভাবুন, আপনি গুঁজে রাখা এক অসম্পর্কিত ফিচার, মূল নিউরনে যা আছে তার সঙ্গে সংঘাত এড়াতে চাইছেন। দুর্বল সক্রিয়তা অনেক, অনেক বেশি ঘন হয়ে ঘটে। ফলে আপনাকে দশের ঘাতে ঘাতে বেশি জিনিসের সঙ্গে সংঘাতে পড়তে হবে, অথচ লাভ সামান্য।
Qwen3-32B-এর একটি নিউরনের মধ্য দিয়ে 100 মিলিয়ন টোকেন চালানো হয়েছে। প্রায় সবগুলোর সক্রিয়তার মানই শূন্যের কাছে; মাত্র প্রায় 160টি সক্রিয়তার পরিসরের জোরালো অর্ধেকে পৌঁছেছে।
কিন্তু হয়তো আপনি একই সঙ্গে অনেক নিউরনের দুর্বল সক্রিয়তার মধ্যে লুকিয়ে আছেন। আমরা যা দেখি তা হলো, নেটওয়ার্কের প্রায় সব দুর্বল সক্রিয়তা অপসারণ করলেও প্রায় কোনো ক্ষতি হয় না। যেসব জায়গায় সেগুলো সরালে সবচেয়ে বেশি ক্ষতি হয়, সেগুলোর কয়েকটি আবার সবচেয়ে সহজে বোঝাও যায়। ভাষা-মডেলে তার মধ্যে আছে শেষ স্তর, যেটি মূলত পৃথক টোকেন দমন করতে ব্যবহৃত হয়। এই গঠনধারাকে আমরা বলি “বলো, নাকি শুধু মনে রাখো” বা “say or just think” motif। ছবি-মডেলে সেগুলো শুরুর স্তর, যা নিয়ন্ত্রণের ঘোরানো চাকতির মতো কাজ করে: সামান্য উজ্জ্বল আর মাঝারি উজ্জ্বলের পার্থক্য গুরুত্বপূর্ণ। কিন্তু পরের দিকের কোনো ডিটেক্টরের কাছে, যেমন কিং পেঙ্গুইন চেনার ডিটেক্টর, প্রমাণ কম নাকি খুবই কম—সেটা গুরুত্বপূর্ণ নয়। কাজেই গুরুত্বপূর্ণ ও ঘনঘন লাগে এমন জিনিস দুর্বল সক্রিয়তায় থাকতে পারে না, কারণ সেগুলো আমরা সরিয়ে দিতে পারি।
দুর্বল সক্রিয়তা কেটে দিলে কী হারাই, সেটাও আমরা দেখতে পারি। নানা ধরনের গবেষণায় দেখা যায়, সাধারণত হারায় এমন কিছু জিনিসের মধ্যে সূক্ষ্ম তফাত, যেগুলো নিয়ে নিউরাল নেটওয়ার্ক এমনিতেই দ্বিধায় আছে। আর যে ক্ষীণ সক্রিয়তাগুলো পাল্লা একদিকে হেলিয়ে দেয়, সেগুলো আসে অর্থগতভাবে সম্পর্কিত সেই নিউরনগুলো থেকেই, যাদের কাছ থেকে আসবে বলে আপনি আশা করবেন।
মাঝারি ConvNeXt-এর 18টি ব্লকই। কোনো কিছু সরানোর আগে মডেলের সবচেয়ে সম্ভাব্য দুই উত্তরের ব্যবধান প্রতিটি দণ্ডে ভাগ করে দেখানো হয়েছে।
তাহলে বাকি থাকে বিরল ডেটা, আর এমন সক্রিয়তা যা জোরালো, তবে চূড়ান্ত রকমের জোরালো নয়।
আগেই যেমন দেখেছি, আমাদের চালানো প্রতিটি পরীক্ষায় বিরল জিনিস সম্পর্কিত সার্কিটের ওপরই গড়ে উঠেছে, কারণ নিজেদের আলাদা জায়গা গড়ার মতো শক্তি তাদের নেই। ওপরের অপসারণ-পরীক্ষাও একই দিকে ইঙ্গিত করে: বিরল ঘটনাগুলো যদি দুর্বল সক্রিয়তায় থাকত, তাহলে সেগুলো কেটে দিলে কিছু উত্তর একেবারে ভেঙে পড়ার কথা ছিল। তার বদলে প্রতিটি পরিবর্তনই ছিল ছোট, প্রায় সমানে সমান দুই সম্ভাবনার পাল্লা এদিকে বা ওদিকে একটু হেলে পড়া।
আর জোরালো, তবে চূড়ান্ত জোরালো নয় এমন সক্রিয়তাগুলো আমরা সরাসরি দেখতেই পারি। আমার জানা প্রতিটি ক্ষেত্রেই অর্থের সম্পর্ক ধরে তারা বাইরে ছড়ায়: CLIP’s Trump neuron[3]-এর বেলায় প্রথমে ট্রাম্পের ছবি, তারপর শিল্পকর্ম আর তাঁর সঙ্গে সম্পর্কিত মানুষ, তারপর Fox News-এর স্টুডিও। যত নিচে নামবেন, আপাতদৃষ্টিতে অসম্পর্কিত অথচ আসলে সম্পর্কিত কিছুকে দেখে ভুল করা তত সহজ হবে। অন্তত একটি ডেটা-নমুনা কোন কোন সার্কিটের মধ্য দিয়ে এসেছে, তা দেখুন; এখানে যা দুর্বলভাবে সক্রিয় হয়েছে, এক স্তর আগেই হয়তো তা জোরালোভাবে সক্রিয় হয়েছিল।
এখানে একটি ভাষা-মডেলের পাঁচটি নিউরনের প্রতিটি জোরালো সক্রিয়তা দেখানো হয়েছে। মাঝখানে প্রতিটি নিউরনের সর্বোচ্চ মান; বাইরে যত ছড়ায়, সম্পর্কও তত দূরের হয়। কোথায় রাখব বোঝা কঠিন হলে ধূসর দেখানো হয়েছে। সাধারণত এগুলোও সম্পর্কিত, কিন্তু সম্পর্ক দূরের হওয়ায় বুঝতে আরও খাটতে হয়। যেকোনোটিতে ক্লিক করে খুলে দেখা যায়, প্রতিটি সক্রিয়তা কোন সার্কিট থেকে এসেছে।

পাঁচটি নিউরনের প্রতিটি জোরালো সক্রিয়তা। মাঝখানে প্রতিটি নিউরনের সর্বোচ্চ মান, বৃত্তগুলো সেই মানের ভগ্নাংশ, আর রং বলে সক্রিয়তাটি কী নিয়ে। ধূসর অংশটি নিচের সীমা। খুঁটিয়ে দেখতে যেকোনোটিতে ক্লিক করুন।
পার্সেন্টাইল, নাকি সক্রিয়তার আসল মান?
আগে আমি পার্সেন্টাইল দিয়ে ভাবতাম, কারণ তা দিয়ে ভাবা সহজ, আর সব নিউরনের জন্য একই মানদণ্ডে হিসাব করা যায়। কিন্তু এখন আমার মনে হচ্ছে, একটি নিউরনের সক্রিয়তার নিজস্ব আকৃতিটাই আমাদের কিছু বলে। কিছু নিউরন মানের পরিসরের অনেক নিচে গিয়েও নিজের অর্থ ধরে রাখে; অন্যগুলোর ক্ষেত্রে হঠাৎই তা ধসে যায়, যেমন ওপরের ক্রিসমাস নিউরনটির ক্ষেত্রে সর্বোচ্চ মানের প্রায় 5%-এ। কিছু নিউরন একটি বইয়ে কয়েকবার সক্রিয় হয়, অন্যগুলো এক পাতাতেই কয়েকবার। পার্সেন্টাইল এই তফাত মুছে দেয়। অথচ প্রায়ই এই তফাতই বলে দেয় আপনি নিয়ন্ত্রণের ঘোরানো চাকতির মতো কিছু দেখছেন কি না, যেখানে মাঝামাঝি মান গুরুত্বপূর্ণ, নাকি একটি ডিটেক্টর দেখছেন, যেখানে বেশির ভাগ সময় তা গুরুত্বপূর্ণ নয়।
পার্সেন্টাইল আমাদের স্বাভাবিক বোধও গুলিয়ে দেয়। 99তম পার্সেন্টাইল শুনতে উঁচু মনে হয়, কিন্তু প্রতি 100 টোকেনে 1 টোকেন মানে প্রায় এক পাতার এক-চতুর্থাংশ। আর খুব নির্দিষ্ট কোনো অনুভূতি বা সামাজিক প্রসঙ্গের নিউরন—ভাষা-মডেলজুড়ে যাদের দেখা যায়—প্রতি পাতায় চারবার হাজির হওয়ার কথা নয়। পাতা ধরে ভাবলে সুবিধা হয়: 99.9তম পার্সেন্টাইল মানে প্রতি দুই বা তিন পাতায় একবার, আর 99.99তম মানে প্রতি 25 বা 30 পাতায়।
নিউরনের কাজের নাম দিতে কি এগুলো দরকার?
সাধারণত নয়। ভাষা-মডেলের হাজার হাজার অবদান-মানচিত্র নিজে খুঁটিয়ে দেখার পর মনে হয়, নিউরন কতটা সাদৃশ্য মেলানোর কাজ করে, তা যত বলি ততই কম বলা হয়। আপনি যদি নৌযানে ভ্রমণের কথা বলেন, মডেলের মনে হতে পারে ব্যাপারটায় একটু টাইটানিকের ছাপ আছে। টাইটানিক নিউরন আর অন্য কয়েকটির দুর্বল সক্রিয়তাজুড়ে একটি “নৌভ্রমণ ফিচার” ছড়ানো আছে—এভাবে ভাবা সাধারণত খুব কাজের বলে আমার মনে হয় না। বরং আছে টাইটানিকের ছাপ ধরার একটি কার্যপ্রক্রিয়া: কোনো কিছুতে সেই ছাপ থাকলেই সে সক্রিয় হয়, আর তার ওজনগুলো টাইটানিকের মতো জিনিসের পক্ষে ভোট দেয়। তাই সবচেয়ে জোরালো সক্রিয়তাগুলো দেখে আপনি বুঝবেন এটি টাইটানিক-ঘেঁষা, আর পরের পরীক্ষানিরীক্ষাতেও সেই নাম সাধারণত টিকে যায়। কোনো একটি নির্দিষ্ট সক্রিয়তা সত্যিই আপনার কাছে গুরুত্বপূর্ণ হলে, তার পথ অনুসরণ করতে পারেন, সার্কিটগুলো অপসারণ করে পরীক্ষা করতে পারেন, আর যতটা চান ততটাই খুঁটিয়ে দেখতে পারেন।
আমার মূল উপলব্ধি এই: কোনো দুর্বল সক্রিয়তাকে অসম্পর্কিত মনে হলে, ভালো করে না দেখে খুব দুশ্চিন্তা করবেন না। সম্ভবত শত শত এমন ঘটনা আমি নিজে অনুসরণ করেছি; প্রায় সবগুলোরই সম্পর্ক খুঁজে পাওয়া গেছে, তারা এসেছে যুক্তিসংগত সার্কিট দিয়ে। শুধু পথটা অনুসরণ করার আগে সম্পর্কটা চোখে পড়ছিল না।
অনেকগুলো ছিল বুদ্ধিদীপ্ত, যেমন একটি জেন কোয়ান নিউরন, যা গণিতের পুনরাবৃত্তিতে (recursion) দুর্বলভাবে সক্রিয় হয়: অনেক কোয়ানও একই ধরনের আত্ম-উল্লেখের ওপর দাঁড়ায়, পর্যবেক্ষককে খুঁজতে থাকে। অন্য সম্পর্কগুলো ছিল আরও দূরের আর খাপছাড়া; আমি নিজে সব সময় সে রকম যোগসূত্র টানতাম না। কিন্তু কীভাবে সেখানে পৌঁছেছে, সাধারণত তা অনুসরণ করা যেত। আমার সন্দেহ, বেশির ভাগ, সম্ভবত প্রায় সবগুলোই এ রকম।
ভাষা-মডেলগুলো খতিয়ে দেখা
এই অংশের কাজ করেছি কার্টের সঙ্গে। ভাষা-মডেলের নিউরন নিয়ে গভীরভাবে অনুসন্ধান করা আমাদের আসন্ন কারিগরি গবেষণাপত্রের কিছু পরীক্ষা এখানে এসেছে। তাই এই অংশে “আমরা” বলব।
ভাষা-মডেল এত বড় যে নিউরনের কার্যপ্রক্রিয়া নিয়ে দাবি নিখুঁতভাবে যাচাই করা কঠিন। তবে এই সরল ব্যাখ্যাটি সেখানেও খাটে কি না, তা আমরা দেখতে পারি। শুরু করছি Anthropic-এর Circuit Biology[15]-এর একটি রোগনির্ণয়-সংক্রান্ত অবদান-মানচিত্র দিয়ে, যা আমাদের ভালো লেগেছিল। তাঁরা Crosslayer Transcoder ফিচার ব্যবহার করে Claude 3.5 Haiku নিয়ে কাজ করছিলেন। দেখা গেল, Qwen3-32B-এর নিউরন দিয়েও একই কাজ হয়।
এখানে যেহেতু মূল মডেলটিই ব্যবহার করা হচ্ছে, পুনর্গঠনজনিত ত্রুটি (reconstruction loss) নেই, আর এটি পেতে নতুন করে কোনো প্রশিক্ষণও দিতে হয় না। তাঁদের সবচেয়ে বড় ট্রান্সকোডারও মূল মডেলের মতো একই পরের শব্দের পূর্বাভাস দেয় মাত্র অর্ধেক সময়[14]; আর যা সে ধরতে পারে না, তা দেখাতে তাঁদের মানচিত্রে ত্রুটি-নোড লাগে।
রোগনির্ণয়ের কেন্দ্রটি মাত্র চারটি নিউরন নিয়ে গড়া। সেগুলো সরিয়ে দিলে মডেল বরং চুলকানির কথা জিজ্ঞেস করে। গর্ভাবস্থায় লিভারের আরেকটি সমস্যার স্পষ্ট লক্ষণ হলো চুলকানি; যেন মডেল তার পরের সম্ভাব্য রোগটির দিকে এগিয়েছে।
আমাদের ভালো লেগেছে এমন আরও কয়েকটি অবদান-মানচিত্র যোগ করেছি। দেখতে চাইলে আরও কয়েকটি মানচিত্রও আছে। ছবি-মডেল আর ভাষা-মডেলে আমার দেখা হাজার হাজার মানচিত্র খুবই সহজপাঠ্য, আর অংশ সরিয়ে পরীক্ষা করলে সাধারণত যেমন আশা করা যায়, তেমনই আচরণ করে।
একই সার্কিট, ফিচারে আর নিউরনে।
নিউরনের ঋণাত্মক দিক তার ধনাত্মক দিকের প্রায় সমান গুরুত্বপূর্ণ। আমাদের মনে হয়, ব্যাখ্যাযোগ্যতা দেখার ইন্টারফেসগুলো ধনাত্মক মেরু আর তার দুর্বল সক্রিয়তার ওপর অতিরিক্ত জোর দেয়। আমাদের ধারণা, দুর্বল সক্রিয়তা সাধারণত তেমন গুরুত্বপূর্ণ নয়, কিন্তু জোরালো ধনাত্মক আর ঋণাত্মক সক্রিয়তা খুবই গুরুত্বপূর্ণ।
যেমন, সান্টা থাকেন ঋণাত্মক মেরুতে।
চিত্রের সান্টা-মানচিত্রে প্রচলিত top-k স্বয়ংক্রিয় ব্যাখ্যাযোগ্যতার লেবেল “রাজধানী শহর” ধরনের হতে পারে, কারণ সান্টাকে ঘিরে প্রচলিত গল্পগুলোর সঙ্গে মিলে যাওয়া ঋণাত্মক দিকটি তারা উপেক্ষা করে। ঋণাত্মক দিকে সান্টা আছে এমন আটটি নিউরন সরিয়ে দিলে সান্টার সম্ভাবনা প্রায় নিশ্চিত অবস্থা থেকে 6%-এ নেমে যায়; Qwen তখন বরং পোষা প্রাণীটিকে দোষ দেয়। আর সত্যিই “Christmas” বা “Santa” নামে চিহ্নিত বিশটি নিউরন সরালে সম্ভাবনা কমে মাত্র 76%-এ আসে।
এখানে Kimi K3-এর একটি অবদান-মানচিত্র আছে, শুধু নিউরন দিয়ে তৈরি। আমাদের জানা মতে, কয়েক ট্রিলিয়ন প্যারামিটারের কোনো মডেলের প্রকাশিত প্রথম অবদান-মানচিত্র এটি। কুড়িয়ে পাওয়া মানিব্যাগ নিয়ে কী করা উচিত জানতে চাইলে, সে মানিব্যাগ, নগদ টাকা আর মালিকের পরিচয়পত্রকে হারানো জিনিস ও সততার সঙ্গে যুক্ত করে, আর উত্তর দেয় “return”, অর্থাৎ “ফিরিয়ে দাও”। এই আকারের মডেলে পূর্ণাঙ্গ খুঁটিয়ে পরীক্ষা আমরা এখনো শুরু করিনি, আশা করছি শিগগিরই করব। তবে এখন পর্যন্ত বেশির ভাগ জিনিসই স্বাভাবিক বোধ দিয়ে বোঝা যাচ্ছে।
ট্রিলিয়ন-প্যারামিটারের মডেলে কুড়িয়ে পাওয়া একটি মানিব্যাগ।
বাইগ্রাম বা নামের মতো জিনিসে গুঁজে রাখার ঘটনা আশা করা স্বাভাবিক, স্রেফ তাদের সংখ্যা এত বেশি বলে। আমরা যা পাই তা হলো স্বাভাবিক সাধারণীকরণ আর সংযোজন। “Miyazaki”-র “iy”-এর মতো গোড়ার ভাষার টুকরোগুলো অনেকটা ছবি চেনার মডেলের শুরুর দিকে থাকা গ্যাবর ফিল্টারের মতো।
পরিশিষ্টে আমরা Neurons in a Haystack[9] নিয়ে আলোচনা করেছি। গবেষণাটির লেখকেরা ভেবেছিলেন, “social security” অভিমুখে তাঁরা হয়তো সুপারপজিশন পেয়েছেন। কিন্তু নেটওয়ার্ক ওই অভিমুখ ব্যবহারই করে না। যে অভিমুখটি সে ব্যবহার করে, আমরা তার মানচিত্র এঁকেছি; সেখানে সে স্বাভাবিক সাধারণীকরণ আর সংযোজনই ব্যবহার করে।

বানানের টুকরো থেকে “Miyazaki”। বানানের সাধারণ টুকরোগুলো থেকে সংকেত আসে একটি Miyazaki নিউরনে। আমরা যে যে লিপি আর অর্থে নামটি পরীক্ষা করেছি, তার সব কটিতেই সে সক্রিয় হয়, আর পরের দিকের “spirited away”-এর মতো যোগসূত্রে সংকেত পাঠায়।
এখানে আছে 1000টি নিউরন-গবেষণাপত্র: এলোমেলোভাবে বেছে নেওয়া পৃথক নিউরন নিয়ে বিস্তারিত অনুসন্ধান।
নিউরন-গবেষণাপত্র।
আমরা যা দেখি, তা হলো প্রায় 90% নিউরনের মূলত একটি কাজই আছে, সঙ্গে আছে পুনরাবৃত্ত সাধারণীকরণের কিছু শাখা, যেগুলো সাধারণত সম্পর্কিত। শাখাগুলো কতটা গুরুত্বপূর্ণ, তা পরীক্ষা করে দেখেছি; যেগুলো সবচেয়ে বেশি প্রভাব ফেলে, সেগুলোকেই সবচেয়ে বেশি সম্পর্কিত বলে মনে হয়েছে। যেমন, একটি ভূতত্ত্বের নিউরন Cesium নামের ভূতত্ত্বের একটি JavaScript লাইব্রেরিতেও সক্রিয় হয়। বাকি নিউরনের অনেকগুলোর দুই বা তিনটি কাজ আছে। আমি এমন কোনো নিউরন দেখিনি, যা দশটার মতো পরস্পর-অসম্পর্কিত কাজ করে। অন্য গবেষণাপত্রটিতে এ বিষয়ে আরও অনেক বিস্তারিত আছে।
এই শাখাগুলোকে বিশেষ গুরুত্বপূর্ণ লুকানো ফিচার বলে মনে হয় না। একটা আশঙ্কা হলো, তারা হয়তো ঘাপটি মেরে থাকা এজেন্টের মতো: নিজের প্রসঙ্গে খুবই গুরুত্বপূর্ণ, তবে বিরল। আমরা সাধারণত যা পাই তা হলো, মূল সক্রিয়তা নিজের প্রসঙ্গে যতটা গুরুত্বপূর্ণ, তার তুলনায় এই শাখা নিজের প্রসঙ্গে কম গুরুত্বপূর্ণও, আবার ঘটনাটিও আরও বিরল।
গোলমালের বড় একটি উৎস ছিল SwiGLU-এর দুই ঋণাত্মকের ঘটনা। আধুনিক নিউরনে গেট আর ভ্যালু, দুটোই থাকে। দুটোই ঋণাত্মক হলে সক্রিয়তা ধনাত্মক মেরুতে চলে যায়, অথচ দেখতে সাধারণত ঋণাত্মক মেরুর মতো লাগে। সচরাচর এই “প্রতিধ্বনি” ছোট হয়, কিন্তু প্রায় 4% নিউরনের ক্ষেত্রে সবচেয়ে জোরালো সক্রিয়তার তালিকার ওপরের অংশটা পুরোটাই এর দখলে থাকে। গোটা নেটওয়ার্কজুড়ে এগুলো অপসারণ করলে বেশির ভাগ বেঞ্চমার্কের ফল বাড়ে, তবে যুক্তি দিয়ে সমাধানের কিছু পরীক্ষায় কমে। আমাদের ধারণা, কারণটা সম্ভবত সাদামাটা: কোনো নিউরন হয়তো এই সক্রিয়তাগুলোর একটি ব্যবহার করে আরও বেশি সময় ধরে যুক্তি চালিয়ে যায়। তবে আমরা গভীরভাবে খতিয়ে দেখিনি। স্থাপত্যের নকশাকারদের বলছি, আমাদের মনে হয় আপনাদের এটা ঠিক করার দিকে নজর দেওয়া উচিত!
Qwen3-32B-এর L1/N20736
ভিশন মডেলের SwiGLU নিউরনগুলো দেখলে, যেগুলোর কাজ আমরা তুলনামূলক ভালো বুঝি, দেখা যায় ভ্যালু অংশটি সাধারণত অপেক্ষাকৃত বিস্তৃত বিষয় শেখে, আর গেট অংশটি শেখে আরও নির্দিষ্ট বিষয়। যেমন, ভ্যালু শিখতে পারে ছোট ধূসর পাখির মতো একটি বড় গোত্র, কিংবা কমলা রঙের যেকোনো কিছু; কিন্তু গেট খুলবে কেবল জানকো পাখি বা গোল্ডফিশের জন্য।
বিশেষজ্ঞ মডিউলগুলো আগে যতটা বলা হয়েছে, তার চেয়ে অনেক বেশি বিশেষায়িত। নিউরনের কাজ কতটা পরিষ্কার, সেটাই বিচার করা কঠিন ছিল বলে বিশেষজ্ঞ মডিউল কতটা বিশেষায়িত, তা-ও বিচার করা কঠিন ছিল। ‘টোকেনের সাদৃশ্য’-এর মতো বিষয় দিয়ে এটা ভালোভাবে মাপা যায় না।
নিউরনের মতো এদের কাজের পরিধিও গভীরতার সঙ্গে সঙ্গে সংকুচিত হয়। যখন এরা ‘একার্থক’ নয়, তখনো মনে হয় মোটামুটি সম্পর্কিত কিছু বিষয়জুড়েই এদের কাজ ছড়িয়ে থাকে। প্রশিক্ষণের ধারাবাহিকতায় আমরা এদের দেখিনি, তবে আমাদের ধারণা, সম্ভবত এ-ও একই পুনরাবৃত্ত সাধারণীকরণের ধরন, শুধু এক ধাপ বড় পরিসরে। মোটের ওপর, আমরা এখন নিউরাল নেটওয়ার্ককে এমন একটি ব্যবস্থা হিসেবে ভাবতে শুরু করেছি, যেখানে একই ধরনের সংগঠনের নীতি নানা স্তরে কাজ করে: ওয়েট, নিউরন, বিশেষজ্ঞ মডিউল ও সার্কিটে। প্রতিটি স্তরের নিজস্ব কিছু বিবেচনা আছে, যেমন অরৈখিকতার খুঁটিনাটি; কিন্তু তাদের মধ্যে মিলও অনেক।
বিশেষজ্ঞ মডিউলকে সুপারপজিশন-বিরোধী এক ধরনের স্থাপত্য হিসেবে ভাবাও মজার। সুপারপজিশন সম্পর্কহীন জিনিসকে একসঙ্গে গুঁজে রাখতে চায়, কিন্তু খুব বিশেষায়িত মডিউল তা কঠিন করে তোলে। কারণ, কোনো নিউরন তখনই সক্রিয় হয়, যখন তার বিশেষজ্ঞ মডিউলটি বেছে নেওয়া হয়। গুঁজে রাখাই যদি কোনো বিশেষজ্ঞ মডিউলের লক্ষ্য হতো, তাহলে সে পুরোপুরি RPG বোর্ড গেমের বস চরিত্রদের জন্য নিবেদিত থাকতে চাইত না; অথচ এমন একটি মডিউল আছে। সে বরং দশ হাজার সম্পর্কহীন জিনিস একসঙ্গে গুঁজে রাখতে চাইত। কিন্তু কখন কোন টোকেন সেখানে পাঠাতে হবে, তা জানতে রাউটারকে তখন সেই দশ হাজার জিনিসই চিনতে হতো। আর রাউটার তো ছোট্ট একটি রৈখিক স্তরমাত্র।

Qwen3.6-এর সব 10,240টি বিশেষজ্ঞ মডিউল। প্রতিটি সারি একটি স্তর। প্রতিটি বিশেষজ্ঞ মডিউলের নিউরনগুলোর সারসংক্ষেপ পড়ে এজেন্টদের বিচারে, সবচেয়ে সংকীর্ণ কাজের মডিউল থেকে সবচেয়ে বিস্তৃত কাজের মডিউল পর্যন্ত সাজানো হয়েছে। কোনো একটির ওপর মাউস রাখলে তার মূল বিষয়টি দেখা যাবে।
ভুল প্রমাণিত হতে পারে এমন ব্যাখ্যা
ব্যাখ্যাকে অতিরিক্ত বিস্তৃত করে ফেলার ঝুঁকি আছে। যেমন, ‘বহুকাজের ভাষা-নিউরন’ বললে হলো। আমাদের কারিগরি গবেষণাপত্রে এই সমস্যা যাচাই করার কয়েকটি উপায় আছে। পরিশিষ্টেও একটি পরীক্ষা আছে, যেখানে ব্যাখ্যাকে ভুল পথে নেওয়ার জন্য ইচ্ছাকৃতভাবে এমন উদাহরণ লেখা হয়, যেগুলো অল্পের জন্য তার আওতায় পড়ে না। আমাদের বিশেষ কাজে লেগেছে ‘ব্লাইন্ড ম্যাক্সিমাম’ (blind maximum) নামের একটি পরীক্ষা। একজন এজেন্ট একটি নিউরন নিয়ে অনুসন্ধান করে তার ছোট্ট ব্যাখ্যা লেখে। দ্বিতীয় এজেন্টটি শুধু সেই ব্যাখ্যা দেখে, আর নিউরনটিকে যতটা সম্ভব বেশি সক্রিয় করবে, এমন একটি উদাহরণ লেখে। ফলটি সাধারণত সহজ, পড়ার উপযোগী একটি বাক্য। আর সেই বাক্য 10 বিলিয়ন টোকেনের মধ্যে পাওয়া আমাদের যেকোনো উদাহরণের চেয়েও জোরালোভাবে নিউরনটিকে সক্রিয় করতে পারে।
নিউরনের সক্রিয়তাকে নিছক একটি সংখ্যা, আর ব্লাইন্ড ম্যাক্সিমামকে সেই সংখ্যা বাড়ানোর উপায় হিসেবে ভাবতে ইচ্ছা হতে পারে। আমার কাছে নিউরনকে একটি লক্ষ্যবস্তু হিসেবে ভাবাই বেশি যথাযথ মনে হয়, যার কেন্দ্র থেকে অর্থ চারদিকে ছড়িয়ে বেড়ে উঠছে। যেসব উপাদান এতে এসে পৌঁছায়, তাদের প্রত্যেকে অর্থ নিয়ে নিজের ছোট্ট একটি বিচার করে। আর সর্বোচ্চ সক্রিয়তার জায়গাটি হলো যেখানে তাদের সবার সম্মতি সবচেয়ে বেশি। তাই লক্ষ্যভেদ করা মানে শুধু বড় একটি সংখ্যা পাওয়া নয়; নিউরন যে বিষয়টি খুঁজছে, তার কেন্দ্রের আরও কাছে গিয়ে পৌঁছানো। বাস্তব লেখার 10 বিলিয়ন টোকেন সুযোগ পেয়েছিল। অথচ শুধু ব্যাখ্যাটি পড়ে লেখা একটি বাক্য কেন্দ্রের আরও কাছে পৌঁছে গেল।
দ্বিতীয় এজেন্ট কখনো নিউরনটি দেখে না, দেখে শুধু তার ব্যাখ্যা। তবু তার লেখা বাক্যটি পাঠ্যসম্ভারে আমাদের পাওয়া যেকোনো উদাহরণের চেয়ে নিউরনটিকে বেশি সক্রিয় করে।
এর একটি সীমাবদ্ধতা হলো, ব্লাইন্ড ম্যাক্সিমাম নিউরনের কেন্দ্রটি যাচাই করে, তার পুরো বিস্তার নয়। কোনো নিউরনের একাধিক কাজ থাকলে, এমনকি সেগুলো সম্পর্কিত হলেও, একটি ব্লাইন্ড ম্যাক্সিমাম হয়তো মাত্র একটিতেই পৌঁছাবে। তাই নিউরনের দিকে আসা অবদানগুলোকেও আমরা গুচ্ছে ভাগ করি। পোষা প্রাণীর মাইক্রোচিপ-সংক্রান্ত একটি নিউরনের ক্ষেত্রে এতে আগের দিকের নিউরনগুলোর কয়েকটি গুচ্ছ পাওয়া যায়: প্রাণীকে শনাক্তকরণ ট্যাগ লাগানো, হারানো পোষা প্রাণী ও উদ্ধার, আর মাইক্রোচিপ ও RFID দিয়ে শনাক্ত করা। একই কেন্দ্র থেকে তিন দিকে বিস্তার। এরপর প্রতিটি গুচ্ছের জন্য আলাদা ব্লাইন্ড ম্যাক্সিমাম চালাই, বাকি গুচ্ছগুলো অপসারণ করে। সেই একই অপসারণের অবস্থায় পাঠ্যসম্ভারের সবচেয়ে শক্তিশালী উদাহরণের সঙ্গে ফলটি তুলনা করি। কোনো গুচ্ছ যদি বেড়ে ওঠার বদলে সেখানে গুঁজে রাখা হয়ে থাকে, তবে এই পরীক্ষায় তার ব্যাখ্যা অন্যগুলোর সঙ্গে সম্পর্কহীন হয়ে ধরা পড়বে, অথচ সেটি তখনো নিউরনটিকে সক্রিয় করবে। এতে সবটুকু যাচাই হয় না, কিন্তু শুধু কেন্দ্রে একবার নিশানা করার চেয়ে লক্ষ্যবস্তুর অনেক বেশি অংশ যাচাই হয়।
সাধারণ কিছু পরীক্ষাও আছে, যেমন কোনো ব্যাখ্যা থেকে সক্রিয়তা ও সার্কিটের পূর্বাভাস দেওয়া। সত্যি বলতে, এগুলোর ওপর আমার আস্থা একটি সীমা পর্যন্তই। V নিউরনের অনেক পরীক্ষায় ‘বিড়াল ও গাড়ি’ ব্যাখ্যাটি ভালো করতে পারে, অথচ নিউরনটি আসলে কী, তা পুরোপুরি এড়িয়ে যেতে পারে। শিখার সঙ্গে তার সংযোগ খেয়াল করে, কিংবা আরও অনেক উপায়ে এই ব্যাখ্যা ভুল প্রমাণ করা যায়। কিন্তু সব কটির জন্যই সৃজনশীলতা ও বিচারবুদ্ধি লাগে; একটি সারসংক্ষেপমূলক পরিসংখ্যান দিয়ে কাজ হয় না। এখানে ব্যাখ্যাযোগ্যতার গবেষণার চেহারাটিও প্রাকৃতিক বিজ্ঞানের অন্য ক্ষেত্রগুলোর মতো: নিউটনের মহাকর্ষতত্ত্ব বিপুলসংখ্যক পর্যবেক্ষণের ব্যাখ্যা দিয়েছিল, তারপর বুধের কক্ষপথে সামান্য একটি অসংগতির কাছে এসে তার সীমা ধরা পড়ল। সবচেয়ে কার্যকর সমালোচনা হলো সেই নির্দিষ্ট অনুমানটিকে লক্ষ্য করে করা সমালোচনা।
ধীরে ধীরে একার্থকতার দিকে
যেভাবে আমরা ভিশন গবেষণার শুরুর দিকের পরীক্ষার মডেলগুলোর দিকে ফিরে তাকিয়েছি, সেভাবে শুরুর দিকের ভাষা মডেলগুলোর দিকেও ফিরে তাকিয়ে দেখতে পারি, সেগুলো বুঝতে মানুষের এত কষ্ট হতো কেন। এর মধ্যে আমার বেশি চেনা একটি হলো GPT-2 XL। OpenAI-তে আমি যে প্রথম automated interpretability project[8] শুরু করেছিলাম, সেটির মডেল ছিল এটি। তখন এর 2%-এরও কম নিউরনের কাজ পরিষ্কার বোঝা গিয়েছিল। আমরা আবার ফিরে গিয়ে, প্রায় কোনো পুনঃপরিমার্জন ছাড়াই, 500টি নিউরন নিয়ে গবেষণাপত্র তৈরি করলাম। এখন প্রায় 70% নিউরনকে মোটামুটি একটি বিষয়ের নিউরন বলেই মনে হচ্ছে। কিছু নিউরনে বাড়তি যে অংশটুকু রয়ে গেছে, তা দেখতে পুনরাবৃত্ত সাধারণীকরণের মতো। একেবারে নিখুঁত নিউরনের সংখ্যা এখনো কম, প্রায় 5%। বাকি নিউরনগুলো কয়েকটি বিস্তৃত ধরনের কাজ করে, সর্বোচ্চ প্রায় ছয়টি, বেশির ভাগ ক্ষেত্রে দুটি। অবশ্য নম্বর দেওয়ার পদ্ধতি প্রথম প্রকল্পটির সঙ্গে হুবহু এক নয়। তখন আমরা সক্রিয়তা পুনর্গঠনের যে কাজটি ব্যবহার করেছিলাম, তাতে এখন কোনো পুনঃপরিমার্জন ছাড়াই কয়েক গুণ ভালো ফল করতে পারছি। কিন্তু ব্যাখ্যার মান মাপার জন্য সেটিকে আর খুব ভালো মাপকাঠি মনে করি না (‘সিমুলেশন স্কোর নিয়ে’ অংশটি দেখুন)। শিগগির প্রকাশিতব্য আমাদের কারিগরি গবেষণাপত্রে আরও বিস্তারিত থাকবে। তবে মোটের ওপর, ছোট মডেলের নিউরনগুলোর কাজের পরিধি বেশি বিস্তৃত, আর আধুনিক মডেলের তুলনায় সাধারণীকরণের অবশিষ্ট ছাপও বেশি।
Towards Monosemanticity[10]-এর ভূমিকায় যে নিউরনটি আছে, তার ক্ষেত্রেও হয়তো একই ধরনের কিছু ঘটেছিল। নিউরনের কাজ পরিষ্কার হতে পারে বলার পর বেশ কয়েকজন মানুষ এবং এজেন্ট আমাদের ওই উদাহরণটি দেখিয়েছিল। গবেষণাপত্রটির শুরুতে বলা হয়েছে, নিউরনের ব্যাখ্যা বোঝা গেলে ভালো হতো, কিন্তু তাদের মধ্যে থাকে খেয়ালখুশিমতো নানা বিষয়ের মিশ্রণ। উদাহরণ হিসেবে সেখানে বিড়াল-ও-গাড়ির নিউরনের পাশাপাশি এক স্তরের ভাষা মডেলের একটি নিউরনের কথা বলা হয়েছে, যা সক্রিয় হয় ‘একাডেমিক উদ্ধৃতি, ইংরেজি সংলাপ, HTTP অনুরোধ এবং কোরীয় লেখার মিশ্রণে’।
আমার ধারণা, এটি হয়তো ‘ডট লিখো না’ ধরনের একটি নিউরন। ভাষা মডেলে এই গঠনধারা আমরা সর্বত্র দেখি। উদ্ধৃতি, সংলাপ এবং HTTP অনুরোধের প্রায় সব উদাহরণেই এটি ডটের ওপর বা তার কাছাকাছি সক্রিয় হয়। আর লগিটের সঙ্গে এর সবচেয়ে শক্তিশালী দশটি ঋণাত্মক সংযোগের আটটির টোকেনই ডট দিয়ে শুরু। বাকি থাকে কোরীয় উদাহরণগুলো। সেগুলোর সব কটিতে নিউরনটি সক্রিয় হয় একটি অসমাপ্ত সিলেবলের প্রায় দুই-তৃতীয়াংশ লেখা হওয়ার পর, যেখানে ডট না চাওয়াটা যুক্তিসংগত। অথবা হয়তো সেটি দ্বিতীয় একটি কাজ। মডেলটি হাতে না থাকায় ব্যাখ্যাকে আরও নির্দিষ্ট করে যাওয়া আমাদের পক্ষে সম্ভব নয়। যেটাই হোক, এখানে আছে বাক্যের গঠনকে সামান্য দুদিকে ঠেলে দেওয়ার দুটি কাজ। কেন তারা একসঙ্গে আছে, তা বোঝাও সহজ।

ডট লিখো না। বাঁয়ে, Towards Monosemanticity-এর নিউরনটি তার নিজস্ব ভিউয়ারে; ডানে, একই কাজ করছে Qwen3.6-এর একটি নিউরন। যেকোনো একটি সরিয়ে দিলেই পরের টোকেনে পূর্ণচ্ছেদ আসার সম্ভাবনা বাড়ে।
আমার মনে হয়, এই উদাহরণটি কাজে লাগে, কারণ খেয়ালখুশিমতো মিশ্রণের একটি বিখ্যাত উদাহরণ শেষ পর্যন্ত মাঝামাঝি কোথাও এসে দাঁড়াচ্ছে। অন্তত এখন পর্যন্ত তাই, কারণ আরও যাচাই করার জন্য মডেলটি আমাদের হাতে নেই। আমরা জানি না, এটি একটি কাজ করছে, নাকি একটি কাজের সঙ্গে দুর্বলতর, সম্পর্কিত আরেকটি বাক্যগঠনগত ধরনও আছে। কিন্তু দুটির যেটাই হোক, চারটি সম্পর্কহীন বিষয়ের তুলনায় তা অনেক বেশি নির্দিষ্ট ও আশাব্যঞ্জক ব্যাখ্যা। অথচ ‘বহুঅর্থক’ শব্দটি সব কটিকে এক কাতারে ফেলে, যদিও তাদের ব্যাখ্যাযোগ্যতার স্তর একেবারেই আলাদা।
2023 সালে প্রথম automated interpretability project[8]-এর সময় আমার ধারণা ছিল, ব্যাখ্যাযোগ্যতার গবেষণা শুরু করার জন্য ছোট, সরলীকৃত মডেলই সবচেয়ে ভালো। কারণ, বাড়তি সাজসরঞ্জাম নিয়ে কম ভাবতে হবে, আর আকার ছোট হলে পরীক্ষা করার জিনিসও কম থাকবে। এখন মনে হয়, উল্টোটাও হতে পারে। ওই বাড়তি ব্যবস্থাগুলো তো নিউরাল নেটওয়ার্ককে আরও ভালোভাবে শিখতে সাহায্য করার জন্যই আছে, যেমন রেসিডুয়াল স্ট্রিম, যা InceptionV1-এ ছিলই না। সরল করতে গিয়ে খুব সহজেই নিউরনের শেখার ক্ষমতা কমিয়ে ফেলা যায়। আর বড় মডেলে নিউরনগুলো সাধারণত আরও নির্দিষ্ট বিষয়ের হয়, ফলে ধরন ও পুনরাবৃত্ত গঠনধারা চেনা সহজ হয়। অন্তত GPT-2-এর ক্ষেত্রে আমি প্রায়ই একসঙ্গে একাধিক গঠনধারা দেখছিলাম, যাদের কোনোটিই আমার চেনা ছিল না। তাতেই বোঝা কঠিন হচ্ছিল। গবেষণাক্ষেত্রটি এমনিতেই যে স্থাপত্য ও আকারের দিকে যেতে চাইছিল, তা গ্রহণ করতে করতে আমরা হয়তো অজান্তেই ধীরে ধীরে একার্থকতার দিকে এগিয়ে যাচ্ছিলাম।
রেসিডুয়াল স্ট্রিম
রেসিডুয়াল স্ট্রিম নিয়ে দুশ্চিন্তাটি এই নয় যে, এর মাত্রার চেয়ে আমাদের আগ্রহের বিষয়ের সংখ্যা বেশি। দুশ্চিন্তাটি হলো গুঁজে রাখার একটি অবিচ্ছিন্ন রূপ: ম্যানিফোল্ডগুলো একে অন্যের ভেতর দিয়ে বোনা, আরও বেশি কিছু রাখার জায়গা পেতে কিছু পারস্পরিক বাধা মেনে নেওয়া। এই সম্ভাবনা পুরোপুরি বাতিল করা হয়তো সম্ভব নয়। কিন্তু বাস্তবে এটি আমাদের কাজে বাধা হয়ে দাঁড়ায়নি। নিউরন রেসিডুয়াল স্ট্রিমে কী লিখছে এবং সেখান থেকে কী পড়ছে, তা আমরা পড়তে পারি; অবদান-মানচিত্রগুলো পরিষ্কার আসে। আর স্ট্রিমকে আমরা এমনও দেখি না যে, সে আগে পারস্পরিক বাধা জমিয়ে রাখছে, কেবল পরে তা দূর করার জন্য।
ভিশন মডেলে বিষয়টি আমরা চোখে দেখেও যাচাই করতে পেরেছিলাম। বহু বছর ধরে আমি কনভলিউশনাল নেটওয়ার্কের রেসিডুয়াল স্ট্রিমকে দৃশ্যমান করতে পারছিলাম না: প্রতিটি মানচিত্র একটি বড় বাঁকের মতো হয়ে বেরোত। পরে দেখা গেল, নেটওয়ার্ক তার সক্রিয়তার মোট পরিমাণের প্রায় পুরোটাই এমন একটি মাত্রায় রাখছিল, যেখান থেকে কিছু পড়া হয় না। সেই মাত্রাটি বদলে সে LayerNorm-এর মাধ্যমে পড়া অন্য সব মাত্রার মান একসঙ্গে বাড়াতে বা কমাতে পারে। এটা বুঝে যাওয়ার পর ওই মাত্রাটি সরানো সহজ হলো, আর মানচিত্রগুলোর অর্থ বোঝা গেল। ব্যবস্থাটি কীভাবে কাজ করে, এমনকি ঠিক কী করছে, তার কারিগরি খুঁটিনাটির চেয়েও গুরুত্বপূর্ণ হলো এই লেখাজুড়ে বারবার দেখা বৃহত্তর পদ্ধতিটি: নেটওয়ার্কের সঙ্গে লড়াই না করে, তার স্থাপত্য কী করছে তা খুঁজে বের করা এবং সেই অনুযায়ী কাজ করা। এতে আরও একটি ব্যবস্থার দিকেও ইঙ্গিত মিলেছিল, যা গবেষণাক্ষেত্রটি শেষ পর্যন্ত এমনিতেই তৈরি করল: অ্যাটেনশন।
ভাষা মডেলের ক্ষেত্রেও একই ধরনের সংশোধন দরকার কি না, আমরা জানি না। তাদের রেসিডুয়াল স্ট্রিম দৃশ্যমান করতে গিয়ে বেশির ভাগ সময় আলাদা কিছু না করেই কাজ হয়েছে। তবে ছবির মানচিত্রে একবার চোখ বুলিয়ে যত সহজে বিচার করা যায়, লেখার একটি গোটা মানচিত্র অর্থপূর্ণ কি না, তা বিচার করা অনেক কঠিন। তাই এই কাজের বেশির ভাগই আমরা ভিশনে করেছি। ভাষা মডেলের জন্য একটি একক সামগ্রিক মানচিত্রই হয়তো সেরা হাতিয়ার নয়। সঠিকভাবে দেখার উপায় শেষ পর্যন্ত যা-ই হোক, সাবম্যানিফোল্ড, নিউরন কী পড়ে ও লেখে, কিংবা লেন্সের মতো করে ভেতরের তথ্য পড়ার পদ্ধতি, আমরা যা যা চেষ্টা করেছি, সবই কাজে দিয়েছে। রেসিডুয়াল স্ট্রিমের এমন কোনো অংশে এখনো পৌঁছাইনি, যার অর্থ আমরা বুঝতে পারিনি।
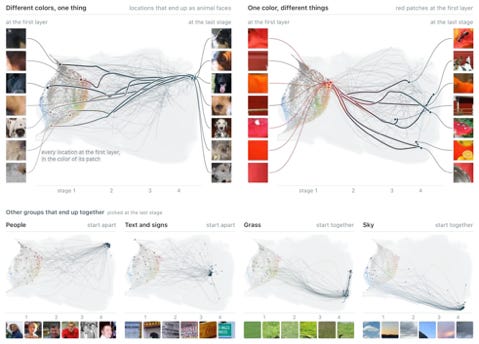
ConvNeXt-এর প্রতিটি স্তরের রেসিডুয়াল স্ট্রিমকে একটি মানচিত্রে আঁকা হয়েছে। প্রতিটি রেখা ছবির একটি অবস্থানকে প্রথম স্তর থেকে (বাঁয়ে) শেষ ধাপ পর্যন্ত (ডানে) অনুসরণ করে। শুরুতে রেখাটির রং সেই অবস্থানের ছবির ছোট অংশটির রং। প্রথম স্তরে মানচিত্রটি রং অনুযায়ী সাজানো। যেসব অবস্থান শেষ পর্যন্ত প্রাণীর মুখ হয়ে ওঠে, তারা শুরু করে পশমের রং অনুযায়ী যে যেখানে পড়ে সেখান থেকে, তারপর ধীরে ধীরে একত্র হয়। লাল অংশগুলো একসঙ্গে শুরু করে, পরে ভিন্ন ভিন্ন জিনিস হয়ে ওঠে। কোনো সারির ওপর মাউস রাখলে বা ট্যাপ করলে প্রতিটি ধাপে তার ছবির অংশটি দেখা যাবে।
স্তর চেপে ছোট করার পরীক্ষাগুলোর মতো আমরা রেসিডুয়াল স্ট্রিমটিকেও সংকুচিত করে দেখেছি। আমাদের 7M-প্যারামিটারের মাঝারি ConvNeXt-কে আবার প্রশিক্ষণ দিয়েছি, একবার স্ট্রিমের প্রস্থ চার ভাগের এক ভাগ করে, আরেকবার আট ভাগের এক ভাগ করে। শেষ ব্লকে মাত্র 46টি মাত্রা রেখেছি, কিন্তু এর সব নিউরনই বজায় রেখেছি। নির্ভুলতা 72% থেকে নেমে 60% ও 39% হয়েছে। তবে স্বাভাবিক প্রস্থের মডেলের সঙ্গে তুলনা করলে সংকুচিত স্ট্রিমটির মানচিত্র দেখতে অনেকটাই একই রকম, শুধু একটু বেশি এলোমেলো। কোথাও মনে হয় না, খুব চালাকি করে ভিন্ন জিনিস পরস্পরের ফাঁকে ঢুকিয়ে রাখা হয়েছে। নিউরন কী পড়ছে ও লিখছে, তা-ও একই কথা বলে: অপ্রাসঙ্গিক সক্রিয়তা বাড়ে, কিন্তু যেটুকু ঢুকে পড়ে, তা একই ধরনের বিষয়। জলের ওপর গাঢ় রঙের পাখি-সংক্রান্ত নিউরনটি অ্যালিগেটর এবং সাঁতার-কাটা রিট্রিভার কুকুর দেখেও সক্রিয় হয়, ঘড়ি দেখে নয়।
রেসিডুয়াল স্ট্রিমে কী থাকতে পারে বা পারে না, তার প্রমাণের চেয়ে নিউরাল নেটওয়ার্ক বুঝতে বাস্তবে কোথায় বাধা পাচ্ছি, তা নিয়েই আমাদের আগ্রহ বেশি। জায়গা কমিয়ে দেওয়ার পরও যদি মানচিত্রে, কিংবা নিউরন কী পড়ছে ও লিখছে তার মধ্যে, পারস্পরিক বাধা দেখা না যায়, তাহলে আমাদের মনে হয় আমরা বেশ ভালো অবস্থানেই আছি।
তাহলে বাকি থাকে এই উদ্বেগ: রেসিডুয়াল স্ট্রিমে মাত্রার চেয়ে ফিচারের সংখ্যা বেশি। জিনিসগুলো সঠিক দিকে বসাতে পারলেই একটি স্ট্রিম তার মাত্রার সংখ্যার চেয়ে অনেক বেশি বিষয় ধারণ করতে পারে। কাজেই এটুকুই গুঁজে রাখার প্রমাণ নয়। বিষয়টি মূলত গুরুত্বপূর্ণ হয় যখন আপনি মডেলের সব ফিচারের একটি বড় তালিকা চান। আর মানুষ প্রায়ই ঠিক সেই উদ্দেশ্যেই স্ট্রিমের কাছে যায়। ‘একটু দূর থেকে দেখা’ অংশে আমরা যেমন বলেছি, বড় একটি তালিকাকে সঠিক চূড়ান্ত লক্ষ্য বলে আমরা মনে করি না। তবে এমন তালিকা চাইলে, নিউরন যেসব দিকে লেখে ও যেসব দিক থেকে পড়ে, সেগুলো দিয়ে শুরু করা ভালো। অবিচ্ছিন্ন সাবম্যানিফোল্ড দিয়েও শুরু করা যায়, যেমনগুলো Block Sparse Featurizer[28] খুঁজে বের করে। এখানে এগুলো বিশেষভাবে স্বাভাবিক মনে হয়, কারণ রেসিডুয়াল স্ট্রিমের কোনো বিশেষ প্রাধান্য পাওয়া ভিত্তি (basis) নেই। এখন পর্যন্ত এই সব পদ্ধতিই ভালো কাজ করেছে: এগুলো অর্থপূর্ণ উপস্থান খুঁজে পায়, আর আমরা স্তরের পর স্তর সেগুলোকে অনুসরণ করতে পারি।
ভাষা মডেলের রেসিডুয়াল স্ট্রিম আমরা তুলনামূলক কম দেখেছি। তবে যা দেখেছি, তা একই কথার সঙ্গে মিলে যায়। উঁচু স্তরের সংগঠন ও পুনরাবৃত্ত গঠনধারা বুঝতে রেসিডুয়াল স্ট্রিমের কোনো কিছু এখন পর্যন্ত আমাদের আটকে দেয়নি।
অ্যাটেনশন
নিউরনের তুলনায় অ্যাটেনশন নিয়ে আমাদের অগ্রগতি কম, আর বিষয়টি মূলত এই লেখার পরিধির বাইরেও। সত্যি বলতে, অ্যাটেনশন যথেষ্ট ভালোভাবে কেউ বোঝেন কি না, সে ব্যাপারেই আমি নিশ্চিত নই; এতটা ভালোভাবে যে আত্মবিশ্বাসের সঙ্গে বলা যায়, এর দুর্বোধ্যতা সেই অর্থেই সুপারপজিশন, যে অর্থটি নিয়ে আমরা ভাবছি। এর বদলে আর যেসব কারণে এমন হতে পারে, সেগুলো থেকে এই কারণটিকে আলাদা করা কঠিন। আর নতুন কোনো প্রক্রিয়া কেন বোঝা কঠিন, তার সম্ভাব্য ব্যাখ্যার তালিকায় ‘শেখার নীতিই বদলে গেছে’ কথাটি একেবারে ওপরের দিকে থাকা উচিত নয়।
অ্যাটেনশন বোঝার লাভের অনেকটাই তার তুলনামূলক সহজ অংশগুলোতে আছে বলে মনে হয়।
অ্যাটেনশনকে আমরা কয়েকটি প্রশ্নে ভেঙে দেখতে পারি: এটি কোথায় তাকাচ্ছে, কী খুঁজছে, সেটা পেলে কী করে, আর কেন এমন করছে।
কোথায় তাকাচ্ছে, সেটা জানা তুলনামূলক সহজ। বলতে গেলে বাড়তি চেষ্টা ছাড়াই পাওয়া যায়, আর এটুকুই অনেক কিছু জানিয়ে দেয়। প্রি-এক্ল্যাম্পসিয়ার মানচিত্রে এটি দুটি আলাদা কাজ করে। প্রথমে রোগীর বিবরণের তথ্যগুলো এনে জড়ো করে ‘she’ টোকেনটিতে, যেখানে মডেল চিকিৎসাবিষয়ক প্রশ্নটির উত্তর নির্ণয় করে। তারপর প্রশ্নটি যেভাবে লেখা হয়েছে, তা ঠিক করে দেয় আসলে পরের কথাটি কী বলা হবে।
অ্যাটেনশন কোথায় তাকায়, তার চিত্রণ।
কী খুঁজছে, আর তা পেলে কী করে, সে বিষয়টিও নিউরনের ভাষায় বোঝা যায়। আমাদের ধারণা, এতে অ্যাটেনশন কী করছে তা বোঝার অনেকখানি লাভ পাওয়া যায়।
উদাহরণ হিসেবে প্রি-এক্ল্যাম্পসিয়ার নমুনাটিতে ‘headache.’-এর পরের কমাটিকে ধরা যাক। 30তম স্তরের তিনটি অ্যাটেনশন হেড সরাসরি রেসিডুয়াল স্ট্রিম থেকে পড়ে। কিন্তু ওই দিকগুলোতে কী লেখা হচ্ছে তা অনুসরণ করলে দেখা যায়, একটি মাথাব্যথার নিউরন, একটি মাইগ্রেনের নিউরন আর একটি মস্তিষ্কের নিউরন। হেডগুলো যা লেখে, তার বেশির ভাগ এসে পড়ে কমাটির অবস্থানে থাকা প্রি-এক্ল্যাম্পসিয়া নিউরনে, আর এক্ল্যাম্পসিয়া ও উচ্চ রক্তচাপের মতো কয়েকটি প্রতিবেশী নিউরনে। এই হেডগুলো অপসারণ করলে প্রি-এক্ল্যাম্পসিয়ার সক্রিয়তা এক-চতুর্থাংশ কমে যায়। কিন্তু তাদের ‘pain’-এর দিকে তাকানো বন্ধ করে দিলে কিছুই বদলায় না।

টোকেনগুলোর নিচের ছোট চিহ্নগুলো সেখানে সক্রিয় হওয়া নিউরন। অ্যাটেনশন যেসব নিউরনে প্রভাব ফেলছে, তাদের মধ্য দিয়ে তথ্যের প্রবাহ দেখলে তার কাজের কিছুটা অনুসরণ করা যায়।
উল্টো দিক থেকেও এটি কাজ করে। কিছু নিউরনের চারপাশের অ্যাটেনশন দেখা গেলে সেই নিউরনগুলো বোঝা অনেক সহজ হয়। আবার কিছু হেডকে কেবল তাদের নিউরনগুলোর মাধ্যমেই বোঝা যায়।

একে অন্যের সাহায্যে অ্যাটেনশন ও নিউরন বোঝা। Qwen3-32B-এর তিনটি উদাহরণ, যেখানে একটি নিউরন ও একটি হেডকে একসঙ্গে দেখলেই কেবল তাদের অর্থ বোঝা যায়। প্রতিটির নিচে আরও উদাহরণ: হেড যা পড়ে, তা রং দিয়ে দেখানো; নিউরন যেখানে সক্রিয় হয়, তা বাক্স দিয়ে ঘেরা। পরীক্ষাটি দেখতে কোনো ছবির ওপর মাউস রাখুন।
মোটের ওপর, অ্যাটেনশন আর নিউরনকে আমরা এতটা আলাদা করে দেখা যায় বলে মনে করি না। অ্যাটেনশন কোথায় তথ্য রাখছে তা বোঝা, পরে সেই তথ্য নিয়ে কাজ করা নিউরনগুলো বুঝতে বেশ সাহায্য করে। এমনকি তথ্য সাধারণত কোথায় রাখা হয়, যেমন সংখ্যার শেষে বা কমার ওপর, তার আশপাশে দেখা সহজ গঠনধারাগুলোও কাজে লেগেছে।
আমার অভিজ্ঞতায়, একটি হেড কোন নিউরনগুলো থেকে পড়ছে, কাদের ওপর প্রভাব ফেলছে এবং কোথায় তাকাচ্ছে, এগুলো জানলেই অনেকটা বোঝা যায়। এতে যে বড় জিনিসটি পাওয়া যায় না, তা হলো প্রতিটি অ্যাটেনশন হেডের জন্য সব ক্ষেত্রে খাটে এমন একটি নাম। নামগুলো থাকলে ভালো হতো, কিন্তু নিউরন বা অবদান-মানচিত্র অনুসন্ধানে এর অভাব বড় বাধা হয়ে দাঁড়ায়নি। বেশ অনেকগুলো দেখার পর আমার অনুমান হয়েছিল, অ্যাটেনশন হেডের সার্বিক নামগুলো জানা থাকলে বাড়তি যে ব্যাখ্যাটি পাওয়া যেত, সেই অবশিষ্ট অংশ হয়তো প্রায় 5%। এরপর আমার অনুমানটি না জানিয়েই একটি এজেন্টকে 100টি অবদান-মানচিত্র দেখে একই বিচার করতে দিলাম। সেও প্রায় 5% বলল। তার প্রায় অর্ধেক ছিল ‘অবস্থান-হেড’, যাদের নাম দেওয়া তুলনামূলক সহজ, কারণ তারা এক টোকেন পেছনে তাকানোর মতো কাজ করে। অন্য অর্ধেক বাকি সব, যা স্বাভাবিকভাবেই বিচিত্র এবং বোঝা কঠিন।
যে জ্ঞান এখনো আমাদের নেই, তার মূল্য বিচার করা কঠিন। তাই এই হিসাবগুলো বাস্তব থেকে অনেক দূরেও হতে পারে। কিন্তু এখন পর্যন্ত অ্যাটেনশন হেডের সার্বিক নাম ছাড়াও, শুধু নির্দিষ্ট ক্ষেত্রে অ্যাটেনশনের প্রবাহ আর নিউরনের সার্বিক ব্যাখ্যা দিয়েই উঁচু স্তরের সংগঠন ও পুনরাবৃত্ত গঠনধারা আবিষ্কারে আমরা অনেক দূর যেতে পারি বলে আমার মনে হয়। আমার একটি কম-আস্থার পূর্বানুমান হলো, ছোট মডেলের নিউরনের মতো অ্যাটেনশন হেডগুলোও শেষ পর্যন্ত বিস্তৃত কাজের, পুনরাবৃত্ত সাধারণীকরণে গড়ে ওঠা উপাদান হিসেবে ধরা দেবে। কারণ, এদের সংখ্যা অনেক কম: Qwen3-32B-তে কয়েক হাজার হেডের বিপরীতে নিউরন আছে দশ লাখের বেশি।
একটু দূর থেকে দেখা
পরিষ্কার বলতে আমি যা বুঝি
এখানে কিছুই বদলানো বা নতুন করে জোড়া লাগানো হয়নি। প্রতিটি অঞ্চল, সার্কিট ও নিউরন নেটওয়ার্কের নিজের, ঠিক যেভাবে সে শিখেছে।
নিউরাল নেটওয়ার্ক এমনিতেই পরিষ্কার, এ কথা বলতে আমি নিউরনের একার্থকতার চেয়ে গভীর কিছু বোঝাই। যদিও সেই মানদণ্ডেও অবস্থা গবেষণাক্ষেত্রের ধারণার চেয়ে অনেক ভালো বলে আমার মনে হয়। আমি বলতে চাই, নেটওয়ার্কের অংশগুলো এমনভাবে গড়ে ওঠে, যাতে পরের দিকের যেসব অংশ সেগুলো পড়ে, তারা সেগুলো বুঝতে পারে এবং তাদের ওপর ভর করে আরও কিছু গড়তে পারে। এই অর্থে নিউরাল নেটওয়ার্ক প্রায় ব্যাখ্যার একটি ফ্র্যাক্টাল, সুশৃঙ্খল ও কাজের গুচ্ছগুলোর এমন এক বিন্যাস, যার ধরন নানা মাপে ফিরে আসে। বড় পরিসরে তার নানা প্রক্রিয়ায়, আর ছোট পরিসরে, যেখানে পুনরাবৃত্ত সাধারণীকরণ প্রতিটিকে গড়ে তোলে। এখান থেকেই ব্যাখ্যাযোগ্যতার গবেষণার একটি লক্ষ্য পাওয়া যায়: আমরাও আরেকজন পাঠক হয়ে উঠি।
এর নিজের পাঠকেরা যেভাবে একে পড়ে, আমরাও যত বেশি সেভাবে পড়ব, আমার মনে হয় তত বেশি ব্যাখ্যাযোগ্য মনে হবে। একে অতিরিক্ত মানুষের মতো করে পড়ার ব্যাপারে আমাদের সাবধান হওয়া উচিত। শুধু আমাদের আগে থেকে তৈরি ধারণার সঙ্গে মিলছে না বলে একে এলোমেলো বলে বসা ঠিক হবে না।
সবকিছু শেষ পর্যন্ত এত গোছানো হয়ে ওঠার একটি কারণ, আমার মনে হয়, এভাবে গড়ে ওঠা দ্রুততর ছিল। একবার নিউরাল নেটওয়ার্কে গাড়ির যন্ত্রাংশসহ একটি গাড়ি-অঞ্চল তৈরি হয়ে গেলে, নতুন আরেকটি গাড়িকে সেখানেই যোগ করা সহজ; অন্য কোথাও দ্বিতীয় একটি গাড়ি-অঞ্চল গড়ে তোলার চেয়ে। আমার মনে হয়, ‘সার্কিট রেসিং’ ও ‘গ্রেডিয়েন্ট স্টারভেশন’-এর ধারণার সঙ্গে এর ঘনিষ্ঠ সম্পর্ক আছে।
সাধারণত আমরা ‘ব্যাখ্যাযোগ্য’ আর ‘একার্থক’-কে প্রায় সমার্থক মনে করি। আমার ধারণা, এর আংশিক কারণ হলো, ধারণাগুলো গড়ে উঠেছিল এমন একটি পরীক্ষার মডেলকে (InceptionV1) ঘিরে, যেখানে প্রায় দুটি বিপরীত চেহারা দেখা যেত। শুরুর স্তরগুলো ছিল ব্যাখ্যাযোগ্য ও একার্থক, আর শেষের স্তরগুলোকে মনে হতো খেয়ালখুশিমতো চরম বিশৃঙ্খলা। কিন্তু ভাষা মডেলে আমরা যা দেখি, তা মাঝামাঝি কোথাও: অধিকাংশ নিউরন মূলত একটি বিষয় বোঝায়, কিছু নিউরন কয়েকটি। ব্যাপারটা কতখানি খারাপ?
ব্যাখ্যাযোগ্যতার গবেষণায় মোটামুটি দুটি ধারা আছে। একটিকে আমরা বলতে পারি তালিকাভিত্তিক ব্যাখ্যাযোগ্যতা। এর লক্ষ্য হলো, যাচাই করার জন্য ফিচারের একটি বড় তালিকা পাওয়া, যাতে নিশ্চিত হওয়া যায় যে অর্থপূর্ণ কোনো ধরন আমাদের চোখ এড়ায়নি। এই দৃষ্টিভঙ্গিতে বড় একটি উদ্বেগ হলো মাত্রার অভিশাপ এড়ানো। কিংবা এমন এক সংযোগ-সমাবেশের বিস্ফোরণ এড়ানো, যেখানে একটি উপাদান আরও নানা উপাদানের সঙ্গে যুক্ত, আর প্রতিটিই একাধিক বিষয় বোঝায়।
আরেকটি ধারাকে বলতে পারি অনুসন্ধানী ব্যাখ্যাযোগ্যতা। এর শুরু প্রশ্ন দিয়ে। এটি নিউরাল নেটওয়ার্কের যেকোনো অংশ অনুসন্ধান করতে পারে; Google Maps-এর মতো অনায়াসে কাছে ও দূরে গিয়ে দেখতে পারে অবদান-মানচিত্র, কিংবা নিউরন ও অ্যাটেনশন হেডের মতো কাজের প্রক্রিয়া। যেতে যেতে আরও প্রশ্ন উঠে আসে। নিউরনের মতো প্রক্রিয়াগুলো দিয়ে শুরু করা ভালো, কিন্তু এর মানে এই নয় যে নিউরনই সবকিছুর চূড়ান্ত সমাধান। যদিও আমার ধারণা, বেশির ভাগ মানুষ যতটা মনে করেন, নিউরন তার চেয়ে ওই সমাধানের কাছাকাছি। এই পদ্ধতি বহুঅর্থকতা অনেক বেশি সামলে নিতে পারে। নিউরাল নেটওয়ার্কের বড় বড় অংশ উপেক্ষা করতেও মোটামুটি অসুবিধা নেই, যেমন একটি শহর নিয়ে গবেষণা করা কেউ নিজের বিশ্লেষণের সঙ্গে সম্পর্কহীন এলাকাগুলো বাদ দেন।
আমার মনে হয়, অনুসন্ধানী পদ্ধতি বেশি ফল দেবে। আমার ধারণা, গবেষণাক্ষেত্রটি ইতিমধ্যে এই দিকেই এগোচ্ছে, তবে বিষয়টি কোথাও স্পষ্ট করে লেখা হয়েছে কি না, আমি নিশ্চিত নই। এই দৃষ্টিভঙ্গি থেকে কয়েকটি কথা বেরিয়ে আসে। ‘মাত্রার চেয়ে ফিচারের সংখ্যা কি বেশি?’ এমন প্রশ্ন বেশির ভাগ ক্ষেত্রেই অপ্রাসঙ্গিক। ফিচারের সংজ্ঞা দেওয়ারও দরকার হয় না, যে কাজটি কত কঠিন তা সবার জানা। আমরা মূলত নজর দিতে পারি মডেলের অংশ হিসেবে থাকা নিউরন ও অ্যাটেনশন হেডের মতো প্রক্রিয়ায়, তার মধ্য দিয়ে প্রবাহিত তথ্যের ওপর, তারপর এই দুইয়ের গুচ্ছে এবং এসবের মধ্যে বারবার ফিরে আসা গঠনধারায়।
ফিচারের বড় তালিকা বরাবরই ছিল একটি লক্ষ্য অর্জনের উপায়। এমন অন্য পথও হয়তো আছে, যেখানে ওই তালিকার দরকারই পড়ে না।
একার্থকতার চেয়ে পুনরাবৃত্ত গঠনধারা
আমাকে যদি একটি বোতাম টিপে প্রতিটি নিউরনকে পুরোপুরি একার্থক করে দেওয়ার সুযোগ দেওয়া হয়, অথবা তার বদলে আমার আগ্রহের কয়েকটি প্রশ্নের পেছনের সার্কিট-গঠনধারা বোঝার সুযোগ দেওয়া হয়, আমি এক মুহূর্তেই দ্বিতীয়টি বেছে নেব। যেমন, একটি এজেন্টের মনস্তত্ত্ব নিয়ে প্রশ্ন করার সঠিক উপায় কী, পারসোনা নির্বাচনের মডেলের সঙ্গে সার্কিটগুলোর সংযোগ কেমন, কিংবা একটি এজেন্ট তার লক্ষ্য এবং নিজের সঙ্গে অন্যদের সীমানা নিয়ে কীভাবে ভাবে।
কল্পনা করুন, এক শ বছর পরের ভবিষ্যৎ থেকে ব্যাখ্যাযোগ্যতার একজন গবেষক এলেন। তিনি শুধু আমাদের প্রশ্নের উত্তরই জানেন না, কোন প্রশ্নগুলো আমাদের করা উচিত ছিল, তা-ও জানেন। তিনি আমাদের কী বলবেন? জানার উপায় নেই। কিন্তু ছোট পরিসরে একবার আমি তাঁর মতো অবস্থানে ছিলাম। এখন আমার মনে হয়, একটি ভিশন মডেল আমি মোটামুটি বুঝি। তাতে আট বছর আগের আমার কাছে আমি অনেকটা ভবিষ্যতের গবেষকের মতোই হয়ে যাই।
তখনকার নিজেকে আমি এই কথাগুলো বলতাম। তোমার সামনেই যে বিশাল ভঙ্গি-চেনার সার্কিটটি আছে, সেদিকে নজর দাও। ঋণাত্মক মেরুকে নিউরনের বিপরীত বিষয় হিসেবে না ভেবে সার্কিটের গেট হিসেবে ভাবো। শেষের স্তরগুলোতে ফিচার ভিজুয়ালাইজেশন রিওয়ার্ড হ্যাকিং করে, অর্থাৎ পুরস্কার পাওয়ার ব্যবস্থার ফাঁকফোকর কাজে লাগায়; তাই সেখানে যে জটলা দেখছ, তার কিছুটা হাতিয়ারটির তৈরি, নেটওয়ার্কের নয়। শেষ স্তরটি আংশিকভাবে অগোছালো, কারণ স্থাপত্যটি খারাপ। এটা একটি সংকেত, তাই ওপর থেকে ঢেকে দিয়ো না। আর যখনই বহুঅর্থকতা দেখবে, আরও ভালো করে তাকাও। যে অপ্রাসঙ্গিক অংশটি চোখে পড়ে, সেটি সাধারণত এমন একটি ব্যাখ্যার দিকে ইঙ্গিত করে, যা এখনো তোমার জানা নেই।
এর প্রায় কিছুই ফিচারের তালিকা নয়। অতীতের নিজেকে এই পরামর্শটুকু সরাসরি দিতে না পারলে, সবচেয়ে ভালো যা দিতে পারতাম তা হলো মূল নিউরন ও সার্কিটগুলো, সঙ্গে একটি চিরকুট: এগুলো আরও ভালো করে দেখো।
এ জন্যই পুনরাবৃত্ত সাধারণীকরণ ও সুপারপজিশনের পার্থক্য এত গুরুত্বপূর্ণ। আপাত অপ্রাসঙ্গিক অংশটির পিছু নেওয়া তখনই কাজে দেয়, যখন তার কিছু শেখানোর থাকে। সাধারণীকরণ থেকে বেড়ে ওঠা একটি গুচ্ছের তা থাকে। কিন্তু যেসব জিনিস একসঙ্গে থাকার কথা নয় বলেই এক জায়গায় গুঁজে রাখা হয়েছে, তাদের গুচ্ছ প্রায় কিছুই শেখাবে না।
তাই ভবিষ্যতের ওই গবেষকের পরামর্শ কেমন হবে, তা নিয়ে আমার সেরা অনুমানও অনেকটা একই রকম। তিনি হয়তো আমাদের কয়েকটি পুনরাবৃত্ত গঠনধারা দেখিয়ে দেবেন, যা তাঁর চোখে স্পষ্ট, আমাদের চোখে নয়। কিন্তু তা না পারলে বলবেন, মূল নিউরাল নেটওয়ার্কটির দিকেই তাকিয়ে থাকো। একে অতিরিক্ত ভেঙে টুকরো কোরো না। কীভাবে দেখতে হয়, তা শেখো। ব্যাপারটা কিছুটা The Hitchhiker’s Guide to the Galaxy-এর মতো, যেখানে উত্তর, 42, জানা আছে; খোঁজ চলছে প্রশ্নটির। নেটওয়ার্কই উত্তর, আর ব্যাখ্যাযোগ্যতার গবেষণা অনেকখানি সঠিক প্রশ্ন খোঁজার চেষ্টা। সেই প্রশ্নের খোঁজে নেটওয়ার্কের নিজের চেয়ে ভালো পথপ্রদর্শক পাওয়া কঠিন। নেটওয়ার্ক এমনিতেই পরিষ্কার বলতে গভীরতর অর্থে এটাই আমি বোঝাই।
একটি শহর, না একটি জট
বড় ব্যবস্থা মানেই সেখানে পথ চেনা বেশি কঠিন, এমন নয়। ছোট শহরে আর্থিক প্রতিষ্ঠানগুলোর এলাকা কোথায় জানতে চাওয়াটাই খুব একটা অর্থবহ নয়। যা আছে, তা ছড়ানো-ছিটানো: এক রাস্তায় ব্যাংক, আরেক রাস্তায় বিমার অফিস, হয়তো কোনো হিসাবরক্ষক বাড়িতে অফিস করেছেন। নিউইয়র্কে কিন্তু মানচিত্রে এক মিনিটেই এলাকাটি খুঁজে পাওয়া যায়। আমাদের ConvNeXt মডেলগুলোতে এর একটি ছোট নমুনা দেখেছি। বড় মডেলে এজেন্টরা চিহ্নিত কুকুরের-কান নিউরনগুলো আরও দ্রুত খুঁজে পেয়েছিল। সেখানে ফ্যাকাসে কান, ঢেউখেলানো কান আর মাথার পাশে থাকা কানের নিউরনগুলো সব এসে যোগ দেয় একটি ঝুলন্ত-কান নিউরনে। অনুসন্ধান শুরুর স্বাভাবিক একটি জায়গা।

আকারে প্রায় 300× পার্থক্য থাকা তিনটি নিউরাল নেটওয়ার্কে পরিসর বাড়ার সঙ্গে কানের নিউরন-পরিবার কীভাবে বদলায়।
ব্যাখ্যাযোগ্যতার গবেষণায় আরও ভালো মানচিত্র দরকার হবে। আমি চাই এমন বিমূর্তায়ন, যার যোগসূত্র অটুট থাকে: আমরা দূর থেকে বড় ধরনগুলো দেখতে পারব, কিন্তু সেগুলো যে নিউরন ও সার্কিটের ওপর দাঁড়িয়ে আছে, তাদের সঙ্গে সংযোগ হারাবে না। Activation Atlas[2] থেকে অনুপ্রাণিত আমাদের ConvNeXt অ্যাটলাস এর একটি উদাহরণ। মডেল কোনো ছবিকে কিলার হোয়েল বলে যে সিদ্ধান্ত নিচ্ছে, সেখান থেকে শুরু করুন। গুরুত্বপূর্ণ একটি নিউরনকে তার বাস্তব উদাহরণের ছবিগুলোর সঙ্গে মিলিয়ে দেখুন, তারপর আবার দূর থেকে দেখুন। দেখা যায়, পরিবারটির তিনটি আলাদা পথ: একটি তিমির জন্য, একটি হাঙর ও রে মাছের জন্য, আর একটি ছিপে ধরা মাছ জেলেরা তুলে ধরলে তার জন্য। অবশ্য মানচিত্র দৃশ্যমান হতেই হবে, এমন নয়। আর একটিমাত্র মানচিত্রও আসল কথা নয়। অনেক মানচিত্র ও অনেক এজেন্ট থাকা উচিত, সবাই এমন ব্যাখ্যার দিকে কাজ করবে, যার সঙ্গে পৃথক নিউরন ও সার্কিটের যোগসূত্র অটুট থাকে।

হাজার হাজার নিউরনজুড়ে উঁচু স্তরে অবদান কীভাবে প্রবাহিত হয়, তা অনুসন্ধানের একটি ইন্টারফেস। নিউরনগুলোকে দ্বীপে ভাগ করা হয়েছে; প্রতিটি দ্বীপ মাঝারি ConvNeXt-এর কয়েকটি স্তরের ব্লকের সঙ্গে মেলে।
অবশ্য মানচিত্র বোঝার উপযোগী হলেই যে আপনি তা বুঝে ফেলেছেন, এমন নয়। অনুমান ও সমালোচনার চিরচেনা বৈজ্ঞানিক কাজটি আমাদের করতেই হবে: কোনো কিছু কী, তা অনুমান করা, অনুমানটি ভুল প্রমাণের চেষ্টা করা, আর যা টিকে যায় তা রাখা। নেটওয়ার্ক অদ্ভুত, কিন্তু তার অদ্ভুত ধরনগুলো ফিরে ফিরে আসে। তাই যাচাই-বাছাইয়ে টিকে যাওয়া একটি অনুমান প্রায়ই বহুবার কাজে লাগে।
নিজেদের ধারণা অতিরিক্ত চাপিয়ে দেওয়া এবং নেটওয়ার্ককে টুকরো টুকরো করা, দুটো নিয়েই আমাদের সাবধান হওয়া উচিত। কল্পনা করুন, নিউইয়র্ক ভালো করে চেনেন এমন কেউ টোকিওতে এলেন। ‘টোকিওর ব্রুকলিন কোনখানে?’ দিয়ে শুরু করাটা কাজে লাগতে পারে। কিন্তু শেষ পর্যন্ত যদি টোকিওর সত্তরটি বিচ্ছিন্ন অংশ থেকে আপনি ব্রুকলিনকে নতুন করে গড়ে তোলেন, তাহলে হয়তো টোকিওকে তার আসল অবস্থার চেয়ে অনেক বেশি এলোমেলো করে দেখালেন। 4e:55-এর ক্ষেত্রে অনেকটা এমনই ঘটেছিল। আমাদের শ্রেণিবিভাগে সেটি ছিল বিড়াল ও গাড়ি, আর তাকে অগোছালো মনে হয়েছিল; অথচ শুরু থেকেই সেটি ছিল একটি V। ওই স্তরে প্রশিক্ষিত একটি SAE-ও একইভাবে তাকে টুকরো করে, V-টিকে ভেঙে একটি গাড়ির ফিচার আর একটি বিড়ালের ফিচার বানায়। সাধারণভাবে স্পার্স ডিকশনারির বিরুদ্ধে আমি নই। কিন্তু এখানে সেটি নিউরন আসলে যা করে, তার থেকে আমাদের আরও দূরে নিয়ে যায়। প্রোব প্রথম ঝুঁকিটি আরও বাড়ায়: আমাদের আগে থেকেই থাকা কোনো প্রশ্নের উত্তরই তারা শুধু দিতে পারে, তাই কোন প্রশ্নটি করা উচিত, তা শেখাতে পারে না। শহরটিকে বুঝতে হলে শেষ পর্যন্ত তার নিজস্ব সংগঠন শিখতেই হবে।
প্রোব ও স্পার্স ডিকশনারির মতো উঁচু স্তরের কাঠামোও কাজে লাগতে পারে। তবে তাদের জায়গা শেষে, শুরুতে নয়। এ ধরনের যত কিছু আমি চালিয়ে দেখেছি, সবই ভেঙে দেখলে অত্যন্ত ব্যাখ্যাযোগ্য নিউরনে গিয়ে দাঁড়ায়। প্রশিক্ষণে হওয়া পরিবর্তনগুলোর ক্ষেত্রেও তাই, এমনকি অন-পলিসি সেল্ফ-ডিস্টিলেশনের ক্ষেত্রেও। বিমূর্ত ধারণাগুলো নিউরন ধারণ করে, আর নির্দিষ্ট ঘটনাগুলো থাকে তথ্যের মধ্যে। তাই মাঝখানে যা বাকি থাকে, তা মানুষের ধারণার চেয়ে কম। আমি সেটিও একইভাবে পরীক্ষা করতাম: স্থির একটি অপ্টিমাইজেশন পদ্ধতি দিয়ে নয়, বরং সাধারণ বৈজ্ঞানিক অনুসন্ধানে সক্ষম একটি এজেন্ট দিয়ে, যে নিউরন, তথ্য এবং এই দুইয়ের গুচ্ছের মধ্যে চলাফেরা করবে। খসড়াটি পড়ে Anthropic-এর Joshua Batson যেমন বলেছিলেন, ওই হারানো অংশগুলো ‘একেবারে এলোপাতাড়ি ওপর থেকে ছড়িয়ে পড়ার বদলে প্রথম ধাঁধাটির মধ্যেই মিলে যাবে’।
ব্যাখ্যাযোগ্যতার সমাধান করার সঙ্গে AGI অর্জনের হয়তো একটি মিল আছে: যত কাছে যান, লক্ষ্য তত সরে যায়। আঙুল তুলে দেখানোর জন্য আরেকটি দুর্বল সক্রিয়তা সব সময়ই থাকে। Curve Detectors[21]-এ আমরা দশটি নিউরন নিয়ে চল্লিশ পৃষ্ঠার পরীক্ষা লিখেছিলাম, ঠিক এই উদ্দেশ্যে যে অন্তত একটি নিশ্চিত একার্থকতার উদাহরণ শনাক্ত করা যাবে। কয়েক বছর পরও কিছু গবেষক আমাকে বললেন, উদাহরণগুলোর কোনোটি একার্থক কি না, তা নিয়ে তাঁদের এখনো সন্দেহ আছে। তাঁদের কথা, আমরা হয়তো কিছু মিস করেছি, আর আনুষ্ঠানিক প্রমাণ কীভাবে দিতে হয়, তা কেউ জানে না। ওই মানদণ্ডে, এমনকি একটি একার্থক নিউরনের অস্তিত্ব আছে বলাও বাড়াবাড়ি দাবি হয়ে যায়।
নিউরনের ছোট ছোট ত্রুটি নিয়ে সন্দেহের পেছনে একটি ভয় আছে: নিরাপত্তা হয়তো শেষ পর্যন্ত নির্ভর করবে এমন কোনো সক্রিয়তার ওপর, যা আমাদের চোখ এড়িয়ে গেছে, যেখানে প্রতারণা লুকিয়ে আছে। আমি যে ঝুঁকিটি নিয়ে ভাবি, তা আলাদা। যেন খুব সুসংগঠিত একটি শহরে আছি, অথচ কীভাবে সেটিকে ভাবতে হবে জানি না, কারণ আমরা সেখানকার বাসিন্দা নই। এই লেখায় আলোচিত প্রতিটি ভুলের ক্ষেত্রেই জিনিসটি চোখের সামনেই ছিল। আমরা পড়তে জানতাম না, কিংবা আমাদের হাতিয়ার সেটিকে ভুল পড়েছিল। কোনোটিই চোখ এড়িয়ে যাওয়া কোনো গোপন সক্রিয়তা ছিল না। মডেলের আউটপুট পড়ছেন এমন কারও কাছ থেকে প্রতারণা লুকোতে পারে, কিন্তু মডেলের নিজের সার্কিটের কাছ থেকে লুকোনোর কোনো কারণ নেই। যে অংশগুলো সেটি পড়ে, তাদের কাছে সেটি পৌঁছাতে হবে। আমরাও পাঠক হয়ে উঠলে আমাদের কাছেও পৌঁছানোর কথা। আমার ভয়, প্রতারণা একেবারে চোখের সামনেই থাকবে, আর আমরা তা পড়তে জানব না।
সময়ের সঙ্গে পৃথক প্রক্রিয়া বোঝার ক্ষেত্রে আমার পদ্ধতি এই ধরনের প্রমাণের ওপর কম নির্ভরশীল এবং আরও সামগ্রিক হয়েছে। একটি নিউরনের প্রতিটি খুঁটিনাটি নিশ্চিত করতে চাওয়ার বদলে আমি তার চারপাশ দেখি: কী তার ভেতরে আসে, সে কোথায় তথ্য পাঠায়, অ্যাটেনশন কীভাবে তার কাছে ও তার কাছ থেকে তথ্য সরিয়ে নেয়, এবং কাছে থেকে ও দূর থেকে তাকে কেমন দেখায়। স্বয়ংক্রিয় ব্যাখ্যাযোগ্যতা নিয়ে কাজ করার সময় কোনো নিউরন তার মূল বিষয়ের কয়েক টোকেন দূরে সক্রিয় হলে সেটিকে বড় সমস্যা মনে হতো। কিন্তু সময়ের সঙ্গে স্পষ্ট হলো, অ্যাটেনশন তথ্যকে নির্ভরযোগ্য কিছু জায়গায় নিয়ে যায়। তারপর সেই জায়গাগুলোর নিউরন ‘যথাযথ টোকেন’-এর ওপর না হয়ে তার কাছাকাছি সক্রিয় হয়। আমার কাছে বোঝার অনুভূতিটি এভাবেই এসেছে: প্রতিটি অংশকে আলাদা করে একটি মানদণ্ড পার করানোর চেয়ে, যুদ্ধের মানচিত্রে কুয়াশায় ঢাকা অঞ্চল একসঙ্গে নানা স্তরে দৃশ্যমান হয়ে ওঠার মতো। অবদান-মানচিত্র নিউরনকে ব্যাখ্যা করতে সাহায্য করে, নিউরন সাহায্য করে অ্যাটেনশন বুঝতে, আর অ্যাটেনশন ঘুরে আবার নিউরনের ব্যাখ্যা দেয়।
প্রশিক্ষণের সময় নিউরাল নেটওয়ার্ক খুব কমই আটকে যায়। কারণ, অনেক মাত্রার একটি পরিসরে নিচের দিকে নামার পথ প্রায় সব সময়ই থাকে। আমার অভিজ্ঞতায়, অজানার এই কুয়াশা সরানোর কাজটিও একইভাবে চলে। সব সময়ই আরেকটি পরীক্ষা করার আছে, আরেকটি ব্যাখ্যাকে আরও নির্দিষ্ট করার আছে, আরেকটি অবদান-মানচিত্র যাচাই করার আছে, আরেকটি নিউরন প্রশিক্ষণের সময় কীভাবে বেড়ে ওঠে, তা দেখার আছে।
এ জন্যই আমার নজর ছিল এমন কোনো বিমূর্ততার স্তর আছে কি না, যেখানে সবকিছু ভেঙে পড়ে; যেখানে আর কিছু শেখা যায় না এবং নেটওয়ার্ককে ভেঙে অন্য কিছুতে বদলে ফেলতেই হয়। আমি এমন কোনো স্তর পাইনি। আর প্রতিটি নতুন গঠনধারা যখন একসঙ্গে অনেক জায়গার কুয়াশা সরায়, তখন একটি নিউরনের ব্যাখ্যাকে নিখুঁত করাই সম্ভবত শ্রমের সেরা ব্যবহার নয়। এর মধ্যে এক ধরনের আস্থা আছে: অদ্ভুত কিছু খেয়াল করে রাখেন, সময়ের সঙ্গে সাধারণত তার ফাঁকটা পূরণ হয়ে যায়। অবশ্য পুরো বিষয়টি আস্থার ওপর দাঁড়িয়ে নেই, কারণ প্রায় যেকোনো ব্যাখ্যাই শেষ পর্যন্ত যাচাই করা যায়। আস্থাটুকু শুধু এই যে, অদ্ভুত কিছু একটি ভালো সূত্র হতে পারে। গাড়ি ও বিড়ালের নিউরনে V দেখতে পাওয়া কঠিন নয়। আমার প্রায় পাঁচ সেকেন্ড লেগেছিল। ছবির ছকটি দেখিয়ে আমি যাদের জিজ্ঞেস করেছি, ‘এখানে মিলটা কোথায়?’, তাদের বেশির ভাগই তা দেখতে পায়। কিন্তু তার জন্য বিশ্বাস করতে হয়েছিল যে নিউরনটি বাস্তব কোনো ধরন খুঁজে পেয়েছে। বহু বছর ধরে বহুঅর্থকতা নিয়ে প্রায় প্রতিটি আলোচনাতেই এই নিউরনটির কথা শুনেছি। প্রায় সব সময়ই তাকে বলা হতো এমন প্রমাণ হিসেবে, যা দেখায় নিউরাল নেটওয়ার্ককে সরাসরি প্রাকৃতিক বিজ্ঞানের অনুসন্ধানের বিষয় ধরাটাই যেন প্রায় অযৌক্তিক। আরও ভালো করে তাকানোর আগে আমিও তা-ই বলতাম। খুব বেশি আস্থা লাগেনি, কিন্তু অল্প একটু লেগেছিল।
অল্প সেই আস্থাটুকু গুরুত্বপূর্ণ, কারণ দুই ধরনের ভুলের ফল এক নয়। আপনি যদি ধরে নেন নেটওয়ার্ক পরিষ্কার, আর ভুল হয়ে থাকেন, তাহলে এলোমেলো একটি নিউরন আপনার কাছে সূত্র: আপনি তা খতিয়ে দেখেন, আর সময়ের সঙ্গে স্বাভাবিক বৈজ্ঞানিক চর্চা আপনার ব্যাখ্যাকে আরও নির্ভুল করে। কিন্তু যদি ধরে নেন সেখানে নানা জিনিস গুঁজে রাখা আছে, তাকে সরাসরি পরীক্ষা করে লাভ নেই, আর সেই ধারণা ভুল হয়, তাহলে এলোমেলো নিউরনটিই শেষ কথা হয়ে দাঁড়ায়। কারণ, আপনি আর সেটি পরীক্ষা করেন না। বহু বছর আমি দ্বিতীয় ধারণাটিই ধরে রেখেছিলাম। যে প্রমাণ সেটিকে উল্টে দিতে পারত, ওই ধারণা দিয়েই তার গুরুত্ব খারিজ করে দিয়েছিলাম। আমি আমার হাতিয়ারগুলো উন্নত করতে পারতাম, দেখতে পারতাম মিশ্রণগুলো একের পর এক পরিষ্কার হচ্ছে, আর সেই অভিজ্ঞতা থেকে এই প্রাথমিক আস্থা গড়ে তুলতে পারতাম যে নিউরনকে বিশ্বাস করা যায়। তার বদলে একটি মডেলকে দেখার চেয়ে, কীভাবে দেখতে হবে তা বের করতেই প্রায় এক দশক কাটিয়ে দিয়েছি।
মাঝারি ConvNeXt-এর ক্ষেত্রে মানচিত্রের বেশির ভাগই এখন পূর্ণ হয়েছে। আট বছর আগে হলে এটিকে ওই মডেলের ব্যাখ্যাযোগ্যতার একটি যুক্তিসংগত সমাধান বলতাম। মডেলটি নিয়ে আমার মনে আসা অধিকাংশ প্রশ্নই আমি খতিয়ে দেখতে পারি। সেখানে পৌঁছাতে অনেক ছোট ছোট জিনিস এবং হাতে গোনা কয়েকটি গঠনধারা লেগেছে। সঙ্গে লেগেছে স্থাপত্যের কিছু পরিবর্তন, যা গবেষণাক্ষেত্রটি এমনিতেই করেছে। কিন্তু শুধু ব্যাখ্যাযোগ্য করার জন্য নেটওয়ার্ককে আলাদাভাবে ঠিকঠাক করতে হয়নি একেবারেই।
আমার অনুমান, সবচেয়ে অগ্রসর নেটওয়ার্কগুলো এখন সেই অবস্থানে আছে, যেখানে আট বছর আগে ভিশন মডেলগুলো ছিল: পড়ে বোঝা সম্ভব, কিন্তু অনেক ছোট ছোট সংশোধনের অপেক্ষা। আমরা যদি তাদের ঠিকভাবে দেখতে শিখি, আপাত অপ্রাসঙ্গিক অংশগুলোর সূত্র ধরে এগোই এবং নানা দৃষ্টিকোণ থেকে ব্যাখ্যা যাচাই করি, তাহলে সেখানেও পৌঁছাতে পারব বলে আমার মনে হয়। হাতে হয়তো কয়েক বছর সময় থাকবে না। কিন্তু প্রাকৃতিক বিজ্ঞানের সেরা পরীক্ষাগার আমাদের বরাবরই ছিল: প্রতিটি নিউরন পড়া যায়, যেকোনো হস্তক্ষেপ করা যায়, প্রতিটি পরীক্ষা হুবহু একই অনুলিপিতে আবার চালানো যায়। যা সব সময় ছিল না, তা হলো সেখানে কাজ করার জন্য অনেক স্বয়ংক্রিয় বিজ্ঞানী, আমাদের চেয়ে অনেক দ্রুত এবং অনেক বেশি সংখ্যায়। এখন তারা আছে। ভিশন মডেলে মানুষের যে কাজ করতে প্রায় এক দশক লেগেছে, সবচেয়ে অগ্রসর ভাষা মডেলে তারা হয়তো কয়েক মাসেই তা করতে পারবে।
আমার মনে হয়, প্রাথমিক পাঠ্যবইয়ের সহজ কথাটিই মূলত ঠিক: নিউরন সাধারণীকরণ করে, একসঙ্গে কাজ করে এবং স্তরের পর স্তরে বিমূর্ত ধারণা গড়ে তোলে। পথে কোথাও আমরা ছবিটিকে অতিরিক্ত জটিল করে ফেলেছিলাম। কিন্তু আরও ভালো করে তাকিয়ে সেটিকে আবার ফিরে পেয়েছি। নেটওয়ার্ক যদি জট না-ই হয়, তার জট ছাড়াতে গিয়ে তাকেই জটের মতো দেখাতে পারি।
সমাধানটা কেমন হতে পারে
উঁচু লক্ষ্য নিয়ে ব্যাখ্যাযোগ্যতার কাজ করতে গেলে আমরা সাধারণত ভাবি, সমস্যাটা ভীষণ কঠিন। হয়তো এতটাই কঠিন যে কাজে লাগার মতো সময়ের মধ্যে এর সমাধানই হবে না। যদি তা না হয়? নেটওয়ার্কটা বিশাল, কিন্তু নিজেকে বোঝার উপযোগী করে তোলার প্রায় সব কাজ হয়তো সে আগেই করে রেখেছে। আমাদের জন্য নয়, তার নিজের পাঠকদের জন্য। আমরা যদি তেমন আরেকজন পাঠক হয়ে উঠতে পারি, তাহলে সে আমাদের জন্যও প্রস্তুত।
সমাধানটা হতে পারে স্বয়ংক্রিয় বিজ্ঞানীদের চালানো এক গবেষণাগার, যেখানে তারা প্রশিক্ষণ ও ইনফারেন্সের সময় নেটওয়ার্কের ওপর নজর রাখবে। প্রতিটি ধাপই সহজ: নিউরনের নাম দেওয়া, পুনরাবৃত্ত গঠনধারা খুঁজে বের করে যাচাই করা, সার্কিটের ভেতর তথ্যের পথ অনুসরণ করা। এসবের উপকরণও ইতিমধ্যে আছে। সক্ষম এজেন্ট বানানো হয়েছে অন্য কাজের জন্য, আর আধুনিক স্থাপত্যগুলো বেছে নেওয়া হয়েছে ভালো শিখতে পারে বলে। ঘটনাচক্রে দুটোই ব্যাখ্যাযোগ্যতার কাজে লাগে।
প্রক্রিয়াভিত্তিক একটি নীতিমালা মেনে এজেন্টরা নানা পরিসরে ব্যাখ্যা প্রস্তাব করে ও পরীক্ষা চালায়। প্রতিটি ব্যাখ্যার ভিত্তি থাকে আলাদা আলাদা নিউরনে। তারপর ব্যাখ্যাগুলো রাখা হয়, বাদ দেওয়া হয়, কিংবা আরও ভালো ব্যাখ্যা দিয়ে বদলে নেওয়া হয়।
তাহলে হয়তো আমাদের শুধু একটাকে অন্যটার সঙ্গে জুড়ে দিলেই চলবে।
অ্যালাইনমেন্ট, অর্থাৎ মানুষের উদ্দেশ্যের সঙ্গে মডেলকে সামঞ্জস্যপূর্ণ করে তোলার কাজও কঠিন হওয়ার কথা। সত্যিই কঠিন হতে পারে। তবে প্রচলিত যুক্তিগুলো ধরে নেয়, আমরা মডেলের ভেতরটা দেখতে পারি না। আমরা ধরে নিই, প্রশিক্ষণের ব্যবস্থা একবারই ঠিক করার সুযোগ পাব, আর শুরু থেকেই সেটা সঠিক হতে হবে। আমরা যদি ব্যবস্থাটা পড়তে ও বুঝতে পারি, তাহলে হয়তো তার বদলে ছোট ছোট, সতর্ক পরিবর্তন করতে পারব। যেমন, কোনো রিইনফোর্সমেন্ট লার্নিং বা RL পরিবেশ ক্ষতিকর বলে ধরা পড়লে সেটাকে সরিয়ে দেওয়া। ভেতরটা দেখার জন্য যে যন্ত্র ব্যবহার করছি, তার মধ্য দিয়েই গ্রেডিয়েন্ট চালানোর দরকার হবে না। প্রতিটি সংশোধনও হয়তো সহজ হবে। শুধু সংখ্যায় অনেক হতে পারে।
ডিপ লার্নিংয়ের ইতিহাস এমনই। তার তৈরি জিনিসগুলোকে বোঝা ও মানুষের উদ্দেশ্যের সঙ্গে মেলানোর ইতিহাসও হয়তো এমনই হবে।
পরিশিষ্ট
আরও কিছু পরীক্ষা, অণুবীক্ষণযন্ত্রে দেখা দৃশ্য আর অমীমাংসিত প্রশ্ন। প্রবন্ধে এগুলো মোটামুটি যে ক্রমে এসেছে, এখানেও সেই ক্রমেই রাখা হলো।
“সুপারপজিশন” নিয়ে কিছু কথা
শব্দটা দিয়ে একাধিক জিনিস বোঝানো হয়েছে। Zoom In[4]-এর আগে এর অর্থ ছিল ভেক্টর যোগের কাছাকাছি কিছু। যেমন, শব্দের এমবেডিংকে সেই শব্দের বিভিন্ন অর্থের যোগফল হিসেবে বর্ণনা করা হতো। Zoom In একটি সার্কিটের উদাহরণ দিয়ে শব্দটাকে সার্কিট গবেষণায় নিয়ে আসে। সার্কিটটা আমি 2019 সালে খুঁজে পাই, আর অন্যরা সেটার ব্যাখ্যায় আমাকে সাহায্য করেন। পরে দেখা গেল, সার্কিটটা প্রথমে আমরা ভুলভাবে পড়েছিলাম। এর পেছনে ছিল সাধারণীকৃত একটি ভঙ্গির সার্কিটকে ভুল বোঝা এবং ফিচার ভিজুয়ালাইজেশনে রিওয়ার্ড হ্যাকিং, দুটোই। আমার কাছে ধারণাটার মূল কথা বরাবরই ছিল: নিউরন একসঙ্গে সম্পর্কহীন জিনিস শেখে। পরে Toy Models of Superposition[7] সুপারপজিশনের সংজ্ঞা দেয় এভাবে: মাত্রার সংখ্যার চেয়ে বেশি ফিচার উপস্থাপন করা। ফলে কথাটা হয়ে দাঁড়ায় মোট কতগুলো ফিচার আছে, সেই বিষয়ে একটি দাবি। অথচ সেটা আমরা এখনো সংজ্ঞায়িত করতে বা মাপতে পারি না। তার প্রায় আট মাস পর একটি অনানুষ্ঠানিক নোটে[11] নিউরনজুড়ে ফিচার কীভাবে সাজানো থাকে, তার দুটি প্রতিদ্বন্দ্বী কৌশল হিসেবে সংযোজন ও সুপারপজিশনকে দেখানো হয়। আমাদের দেখার ধরনের কাছাকাছি, তবে সেখানে বিষয়টা উপস্থাপন; প্রক্রিয়াগুলো কীভাবে গড়ে ওঠে, তা নয়। আমাদের মতে এই কাঠামোটি চমৎকার, আর এই প্রবন্ধ যে প্রশ্ন নিয়ে মাথা ঘামায়, তার সবচেয়ে কাছাকাছি। কিন্তু আমরা যত গবেষক ও এজেন্টের সঙ্গে কথা বলেছি, তাদের বেশির ভাগ এখনো সুপারপজিশন বলতে মূলত মাত্রার চেয়ে বেশি ফিচারই বোঝেন।⁶ এখানে এই ফারাকটা গুরুত্বপূর্ণ। কারণ দাবি দুটো বেশ আলাদা: আমাদের প্রশ্নটা লাভ-ক্ষতির ভারসাম্য নিয়ে, সংখ্যা নিয়ে নয়। অন্য কেউ কেউ আবার গুণগত একটা সংজ্ঞা ব্যবহার করেন: কয়েকটা নিউরন একসঙ্গে কাজ করলে সেটা সংযোজন, কিন্তু কোনো এক সীমা পেরোলে তা সুপারপজিশন হয়ে যায়।
⁶ এজেন্টদের ক্ষেত্রে এর পেছনে একটা অদ্ভুত দুর্ঘটনাও থাকতে পারে। নোটটির শুরুতে একটি বড় ছবি আছে, যেটি base64 ইমেজ ডেটা হিসেবে সরাসরি পাতার মধ্যে বসানো। অনেক এজেন্টের ওয়েব-পাঠক মূল যুক্তি শুরু হওয়ার আগেই ওই ছবির ডেটার মধ্যে পড়ে দৈর্ঘ্যের সীমায় পৌঁছে যায়। এই লেখা পর্যন্ত আমরা যত এজেন্ট পরীক্ষা করেছি, কেউই সেটার পরের অংশ পড়তে পারেনি। 2023 সালে কারও পক্ষে এটা আগে থেকে আন্দাজ করা সম্ভব ছিল না। কিন্তু স্বয়ংক্রিয় গবেষকেরা সুপারপজিশনকে কীভাবে বোঝে, তার ওপর এর প্রভাব পড়ে থাকতে পারে।
আমরা একে ঠিক প্রশ্নটা খুঁজে পাওয়ার চলমান চেষ্টা হিসেবে দেখি। ফিচারের সংজ্ঞা দিতে এই ক্ষেত্রের দীর্ঘ লড়াইয়ের মতোই। বেশির ভাগ সংজ্ঞার নিচে আসলে একটা প্রশ্ন আছে: নিউরনগুলো আগে থেকেই উপযোগী নয় কেন? আমরা সরাসরি প্রক্রিয়াগুলোই পরীক্ষা করতে পারি না কেন? আমাদের উত্তর হলো, হয়তো পারি। তা হলে এর পরের অনেক সংজ্ঞার প্রয়োজনই মিলিয়ে যাবে।
নতুন একটি পরিভাষা বানানোর কথা আমরা ভেবেছিলাম। কিন্তু এই ক্ষেত্রে আগে থেকেই এমন অনেক ধারণা আছে, যেগুলো একে অন্যের সঙ্গে খানিকটা মিলে যায়। এ নিয়ে যত যত্নশীল কাজ হয়েছে, তার থেকে নিজেদের বিচ্ছিন্ন করতে চাইনি। তাই শব্দটা রেখেই ঠিক কী বোঝাচ্ছি, তা স্পষ্ট করে বলছি: নিউরন একসঙ্গে সম্পর্কহীন জিনিস শেখে, কারণ সেগুলো খুব কমই একে অন্যের কাজে বাধা দেয়। আধুনিক ব্যবহারে এই উদ্বেগের প্রথম রূপ ছিল এটাই; আমি বরাবর এটাই মনে করে এসেছি; আর আমাদের ধারণা, প্রায় সবকিছুই এর ওপর নির্ভর করছে। সংযোজনও তার নিউরনের সংখ্যার চেয়ে অনেক বেশি জিনিস উপস্থাপন করে। আমরা তো সেটাই চাই। সংখ্যা দিয়ে দেওয়া সংজ্ঞা থেকে সংযোজনকে বাদ দিতে হলে আগে ঠিক করতে হবে, কোনটাকে ফিচার হিসেবে গোনা হবে। আমরা নিউরনের মধ্যে সুপারপজিশন খুঁজি, আর রেসিডুয়াল স্ট্রিমের অংশে খুঁজি এর একটানা বা অবিচ্ছিন্ন রূপ।
বিষয়টা এত স্পষ্ট করে বলার একটা কারণ হলো AI এজেন্টরা। ব্যাখ্যাযোগ্যতার গবেষণায় তাদের ভূমিকা বাড়ছে। আমাদের অভিজ্ঞতায়, তারা শব্দটির নিজস্ব একটি বাঁধা অর্থ ধরে নিয়ে আসে।
সিমুলেশন স্কোর নিয়ে
সিমুলেশন স্কোর প্রায়ই শেষ পর্যন্ত মাপে, অ্যাটেনশন কোথায় তথ্য রাখছে। সেটা আসলে অ্যাটেনশনের পুনরাবৃত্ত গঠনধারা নিয়ে প্রশ্ন, নিউরন নিয়ে নয়। অ্যাটেনশন প্রায়ই কমা আর অন্য যতিচিহ্নে তথ্য জমা রাখে, অনেকটা সারসংক্ষেপ তৈরির একটি গঠনধারার মতো। কিন্তু কোন ধরনের যতিচিহ্নে ঠিক কতটা তথ্য রাখে? একটি সিমুলেটরকে এ নিয়ে খুব মাথা ঘামাতে হয়, যদিও নিউরনটির নিজের সঙ্গে এর প্রায় কোনো সম্পর্কই নেই। সিমুলেশনে দুর্বল সক্রিয়তার এমন খুঁটিনাটি ঠিক ধরলেও পুরস্কার মেলে, যা নিউরনটি কী করে তা বোঝার জন্য তেমন জরুরি নয়। CLIP-এর ট্রাম্প নিউরন ট্রাম্পের ছবিতে জোরালো সাড়া দেয়। ফ্রেমে তাঁকে যত ছোট দেখায় বা তিনি যত মুখ ফিরিয়ে নেন, সাড়া তত দুর্বল হয়। তাঁর আকার কমার সঙ্গে সক্রিয়তা ঠিক কী হারে কমে, নিউরনটির নাম দেওয়ার জন্য তা জরুরি নয়; কিন্তু সিমুলেট করার জন্য খুবই জরুরি। সবশেষে, কী ঘটছে তা বুঝলেও ভাষা মডেল নির্ভুল সক্রিয়তার মান আউটপুট হিসেবে দিতে ভালো পারে না। সাধারণত এ কাজের প্রশিক্ষণও তাদের দেওয়া হয় না। তাত্ত্বিকভাবে, মানগুলোকে সতর্কভাবে আলাদা পরিসরের দলে ভাগ করলে কিছু খুঁটিনাটির সমস্যা মিটতে পারে। কিন্তু নিউরনের গভীরতা ও কাজের ধরন অনুযায়ী তাদের স্বাভাবিক সীমামান এবং কত বিরলভাবে তারা সক্রিয় হয়, তাতে অনেক তফাত থাকে। তাই যেকোনো একটি মাপকাঠির চেয়ে স্বাভাবিক বৈজ্ঞানিক পদ্ধতির ওপরই আমি ভরসা করতে চাই। একসময় সিমুলেশন হয়তো কয়েকটি উপযোগী স্কোরের একটি হয়ে উঠবে। তবে সেটা পরে, যখন আমরা নেটওয়ার্ক ভালো বুঝব; সম্ভবত তখন এ কাজের জন্য প্রশিক্ষিত সিমুলেটরও লাগবে। কিন্তু শুরু করার জন্য একে ভালো জায়গা বলে আমার মনে হয় না।
পরের স্তরগুলোতে ফিচার ভিজুয়ালাইজেশন
সার্কিট দেখার জন্য আমার প্রথম ইন্টারফেসে অপ্টিমাইজ করা নিউরনের দৃশ্যরূপ আর নিউরনগুলোর মধ্যকার ওজন দেখানো হতো। একটি ছবি অপ্টিমাইজ করলে বোঝা যায়, নিউরনকে কীভাবে উত্তেজিত করা যায়। কিন্তু এই প্রক্রিয়া এমন পথও খুঁজে নিতে পারে, যা সাধারণ ছবি খুব কমই ব্যবহার করে। InceptionV1-এর পরের স্তরগুলোতে আমরা দেখেছি, কোনো পথ বেঁধে না দিয়ে অপ্টিমাইজেশন চালালে কুকুরের ছবি তৈরি হতে পারে, এমনকি আমরা যে সার্কিটের পথ অনুসরণ করছি তা গাড়ির তথ্য বহন করলেও।
একটা কার্যকর সমাধান ছিল, বাস্তব ছবি যে পথগুলো ব্যবহার করে, দৃশ্যরূপ তৈরির প্রক্রিয়াকে সেদিকে একটু ঠেলে দেওয়া। আমরা ডেটাসেট থেকে নিউরনটির সবচেয়ে জোরালো উদাহরণগুলো নিয়েছি, সেগুলোর পথ অনুসরণ করেছি এবং অপ্টিমাইজেশনকে সেই পথগুলো ধরার প্রণোদনা দিয়েছি। অনেক সময় শুধু প্রথম 64 ধাপের জন্যই এটা করেছি; সাধারণত তাতেই চলেছে। নানা উপায়ে চেষ্টা করেছি, তবে একটি পদ্ধতিকেই সর্বোত্তম বলে দাঁড় করাতে পারিনি। কোনো নির্দিষ্ট পথের দিকে একটু ঠেলে দেওয়ার বেশির ভাগ উপায়ই যথেষ্ট। শুধু কুকুরের ছবি তৈরির সেই আকর্ষণক্ষেত্র থেকে বেরিয়ে আসতে হয়।
“গাড়ি ও প্রাণী” অংশে গাড়ির সার্কিটের তুলনায়, গাড়ির নিউরন 4c:447-এর আউটপুট পড়ে এমন চারটি নিউরন দেখানো হয়েছে। একবার বাধাহীন অপ্টিমাইজেশন দিয়ে, আরেকবার স্বাভাবিক ছবির পথ ধরে অপ্টিমাইজেশন দিয়ে। পথ দেখিয়ে দিলে দেখা যায়, দুটো গাড়ির নিউরন, আর বাকি দুটো গাড়ি ও কুকুরের একটি অভিন্ন ভঙ্গি চিনছে। সম্পূর্ণ সার্কিটের মানচিত্রে গাড়ির স্বাভাবিক ছবিতে সাড়া ও সংযোগের পথও আমরা অনুসরণ করেছি। এই দৃশ্যগুলো মিলিয়ে পড়তে গিয়েই শরীরের গড়ন ও ভঙ্গির অভিন্ন সার্কিটটি চিনতে পেরেছি। তবু একটি পথের ছবি নিউরন যা করে, তার একটা অংশই কেবল দেখায়।
ধনাত্মক-ঋণাত্মক অবস্থাগুলো আলাদা করে দেখা
অনেক ভাষা মডেলের নিউরন SwiGLU নামের একটি নকশায় দুটি সংখ্যা গুণ করে: একটি গেট, আর একটি ভ্যালু। দুটোই ঋণাত্মক হলে আউটপুট ধনাত্মক হয়। ফলে একেবারে আলাদা দুটি কারণে একটি নিউরন সক্রিয় হতে পারে। নিচে আমরা নমুনা হিসেবে যে “enemy” বা শত্রু নিউরনটি পরীক্ষা করেছি, তার সাড়ার পরিসরের এলোমেলো মাঝের অংশ প্রায় পুরোটাই এই দুই ঋণাত্মকের গুণফল। আর সবচেয়ে জোরালো সাড়াগুলো আসে ধনাত্মকের সঙ্গে ধনাত্মক গুণ করে। চিহ্নের এই আলাদা অবস্থাগুলো আলাদা করে দেখালে নিউরনটিকে না বদলিয়েই বিষয়টা চোখে পড়ে।

দুই ঋণাত্মকের গুণফলই এলোমেলো মাঝের অংশটা ভরে রাখে। p75–p99 পরিসরের 131/133 সাড়া আসে − × − থেকে। সবচেয়ে জোরালো প্রান্তে ব্যবহৃত হয় + × +: p99.99 এবং তার ওপরে 93/93। প্রতিটি বার সক্রিয়তার একটি পরিসরের ভেতরকার অনুপাত দেখায়।
একটি ধনাত্মক আউটপুট। দুটি আলাদা পথ। শুধু গুণফল দেখলে সেটা কীভাবে তৈরি হয়েছে, তা আড়ালে থেকে যায়। চিহ্নের চারটি সমন্বয় আলাদা করে দেখালে মূল নিউরন অক্ষুণ্ন রেখেই দুই ঋণাত্মকের গুণফলের অবস্থাটি দেখা যায়।
রেসিডুয়াল স্ট্রিমের দিকে তাকানো
কোনো একটি স্থানাঙ্কের মান অনেক বড় হলে তা রেসিডুয়াল স্ট্রিমের জ্যামিতিকে প্রাধান্য দিয়ে নিয়ন্ত্রণ করতে পারে, আর লেয়ার নরমালাইজেশনের সঙ্গে মিলে কোনটি বেশি নজরে পড়ার মতো, তার সংকেত হিসেবে কাজ করতে পারে। দৃশ্যরূপ থেকে সেটি সরিয়ে দিলে বাকি কাঠামো দেখা সহজ হয়। তারপর ওই মান ব্যবহার করে মানচিত্রে রং দেওয়া যায়।
একটি স্থানাঙ্ক মানচিত্রের চেহারা বদলে দেয়। ছবির একই 4,000 অবস্থান দেখানো হয়েছে; প্রক্ষেপণের সময় একবার স্থানাঙ্ক 112 রাখা হয়েছে, আরেকবার সরিয়ে রাখা হয়েছে। মানচিত্র বদলানোর সময় একটি বিন্দু অনুসরণ করুন; তার মূল সিঙ্ক মান রঙের মাধ্যমে দেখা যেতেই থাকে। নেটওয়ার্কের নথিবদ্ধ সক্রিয়তার মানগুলো বদলানো হয়নি।
উত্তর কখন আকার নিতে থাকে? তথ্য পড়ে দেখার এই দৃশ্যগুলো হিসাবের কোথায় পরিবর্তন হচ্ছে, তা চিহ্নিত করতে সাহায্য করে। তবে এদের আত্মবিশ্বাস ও সময় নির্ভর করে কোন লেন্স দিয়ে দেখা হচ্ছে তার ওপর। এগুলো প্রক্রিয়ার পথ অনুসরণের কাজে উপযোগী সূত্র; মডেলের “আসল ব্যক্তিত্ব” যাচাইয়ের পরীক্ষা নয়।
দুর্বল সক্রিয়তা: আরও কিছু পরিমাপ
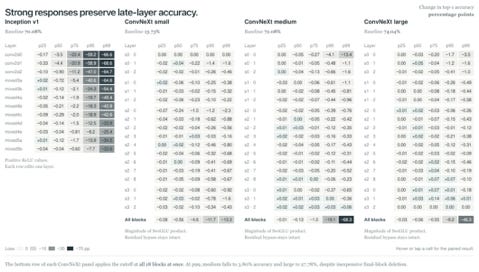
জোরালো সাড়া শেষের স্তরগুলোর নির্ভুলতা বজায় রাখে। Inception-এর শেষ স্তরের ধনাত্মক সক্রিয়তাগুলোর মোটামুটি সবচেয়ে জোরালো এক-চতুর্থাংশ রেখে দিলে 69.47% নির্ভুলতা থাকে; মূল নির্ভুলতা ছিল 70.08%। ConvNeXt-এর পরের দিকের MLP শাখাগুলোও দুর্বল সাড়া সরিয়ে নেওয়া একইভাবে সহ্য করতে পারে, যদি তাদের রেসিডুয়াল বাইপাস অক্ষুণ্ন থাকে।
আমরা যে ঘটনাগুলো পরীক্ষা করেছি, সেখানে পরিবর্তনগুলোকে আরও সূক্ষ্ম পার্থক্যের পরিবর্তন বলেই মনে হয়েছে। একেবারে সম্পর্কহীন কোনো ফিচার হারিয়ে যাওয়ার মতো মনে হয়নি।
দুর্বল সক্রিয়তার অর্থ যাচাই করার এমন কোনো পরীক্ষা আমাদের এখনো নেই, যার ওপর ভরসা করতে পারি। সম্ভাব্য অর্থের পরিসরটা খুব বড়। তার বদলে আমরা একটি “enemy” নিউরন বিশদে দেখেছি। তারপর দৈবভাবে বেছে নেওয়া কয়েকটি নিউরনের দুর্বল সক্রিয়তা ও সংযোগ নমুনা হিসেবে পরীক্ষা করেছি। এই “enemy” নিউরনে দুর্বল ধনাত্মক সাড়া সরাসরি প্রতিপক্ষ বোঝায় এমন শব্দ থেকে, অন্য ভাষার শব্দও তার মধ্যে আছে, ছড়িয়ে যায় কাছাকাছি উল্লেখ, লড়াই, খেলা ও প্রতিযোগিতার দিকে। শূন্যের কাছে এলে সম্পর্কহীন উদাহরণ বেশি দেখা যায়। যেসব দুর্বল সাড়ার পথ আমরা অনুসরণ করেছি, তাতে নিউরনের মধ্যে পুরো আলাদা কোনো ফিচার গুঁজে রাখার প্রমাণ পাইনি। তা বলে সেগুলো আর চমকে দেবে না, এমন নয়। বৃহত্তর শ্রেণিভিত্তিক বাছাইয়ে মিশ্র ফল আসে। তাই এই কয়েকটি নমুনা পরীক্ষা থেকে সাধারণভাবে দুর্বল সক্রিয়তার অর্থ কী, তা স্থির করা যায় না।

অর্থভিত্তিক একটি নমুনা পরীক্ষা। জোরালো ধনাত্মক সক্রিয়তা থেকে শূন্যের দিকে এগোলে এই enemy / adversary, অর্থাৎ শত্রু বা প্রতিপক্ষের নিউরনটি সরাসরি শব্দটি থেকে সরে কাছাকাছি শব্দ, যুদ্ধ ও খেলার প্রসঙ্গে সাড়া দেয়। শূন্যের কাছে সাধারণ লেখা ও কোডের প্রাধান্য দেখা যায়। প্রেক্ষাপট বোঝাতে ঋণাত্মক দিকটিও দেখানো হয়েছে। Qwen3.6-35B-A3B, L36 / E206 / N103।
হারিয়ে যাওয়া বাঁক
The Missing Curve Detectors of InceptionV1[23] গবেষণায় InceptionV1-এর শুরুর স্তরগুলোতে স্পার্স অটোএনকোডার ব্যবহার করে এমন কিছু বাঁক শনাক্তকারী পাওয়া হয়েছিল, যেগুলো নিউরনের মধ্যে নেই বলে মনে হচ্ছিল। SAE-এর যেসব বাঁক আমরা পরীক্ষা করেছি, সেগুলো ভেঙে দেখলে আগে থেকে থাকা বাঁকে সাড়া দেয় এমন নিউরনই পাওয়া যায়। মূল দশটি বাঁকের নিউরনও তার মধ্যে আছে। এই সংযোজনগুলো এক অর্থে বাস্তব; সংযোজন বাস্তবেই ঘটে। কিন্তু দুর্বোধ্য উচ্চমাত্রিক কোনো স্থানে লুকিয়ে থাকা বাঁকের মৌলিক নতুন উপাদান আমরা পাইনি।
SAE-এর বাঁকগুলো ভেঙে দেখলে বাঁকের নিউরনই পাওয়া যায়।
শুধু বাঁকের সক্রিয়তার ওপর একটি SAE প্রশিক্ষণ দিলে সেটি তার অভিধানের 100k উপাদানের মধ্যে 84k ব্যবহার করে। অসংখ্য সংযোজন খুঁজে পাওয়া সম্ভব। আমাদের অভিজ্ঞতায়, এর ফলে মনে হতে পারে, মৌলিক উপাদানের সংখ্যা আসলে যত, তার চেয়ে বেশি।
মডেলকে ভুল করানোর উদাহরণ কোন পথে যায়
ইচ্ছাকৃতভাবে মডেলকে ভুল করানোর জন্য তৈরি adversarial example-ও মডেলের স্বাভাবিক পথগুলো দিয়ে যেতে পারে। ConvNeXt-এর একটি উদাহরণে এমন আক্রমণ একটি ট্রাইসেরাটপসের খুলিকে মডেলের কাছে জাগুয়ার হিসেবে ধরা দেয়। খুলি-সম্পর্কিত ছয়টি নিউরন চুপ হয়ে যায়। অন্যদিকে, আসল জাগুয়ার যে ইনপুটগুলো ব্যবহার করে, সেগুলো স্বাভাবিক শক্তির প্রায় এক-চতুর্থাংশ নিয়ে সক্রিয় হয়। আক্রমণটি জাগুয়ার সার্কিটের চেনা অংশগুলোকে কাজে লাগায়।
InceptionV1-এ আলাদা একটি পরীক্ষায় ব্যাপারটা চোখে দেখা যায়। ছবিতে পরিবর্তন করার অনুমোদিত সীমা বাড়ালে, আর আক্রমণটিকে সামান্য স্থানবদল, আকারবদল ও ঘোরানোর পরেও কার্যকর থাকতে হলে, খুলির ঘাড়ঘেরা ঝালরের মতো অংশটায় বেড়ালের মুখ আর ছোপছোপ লোমের আদল ফুটে ওঠে। আসল জাগুয়ারে সাড়া দেয় বলে বেছে নেওয়া দশটি নিউরনের নয়টিই অপরিবর্তিত খুলির তুলনায় অনেক বেশি সক্রিয় হয়। কেবল ছবিটা বদলায়; নেটওয়ার্কের ওজনগুলো স্থির থাকে।
InceptionV1 · পরিবর্তনের অনুমোদিত সীমা বা perturbation budget 32/255। আক্রমণটি এমন নকশা আঁকে, যা মডেলের আগে থেকে থাকা জাগুয়ার নিউরনগুলোকে কাজে টানে।
আমি একে সার্কিটের বাস্তুতন্ত্রের ধারণার পক্ষে প্রমাণ হিসেবে পড়ি: এমনকি একটি অর্থহীন লক্ষ্যও এমন যন্ত্রপাতিকে কাজে টানতে পারে, যা আগে থেকেই সেই লক্ষ্যের দিকে কাজে লাগে এমন কিছু করছে। শেখার সঙ্গে এর যে সম্পর্ক আমরা প্রস্তাব করছি তা হলো, অবশিষ্ট ত্রুটি ধরার ক্ষেত্রে প্রতিষ্ঠিত পথগুলো আগে থেকেই এগিয়ে থাকে। উত্তর বদলানোর উপায় তাদের কাছে আগে থেকেই আছে, তাই অপ্টিমাইজেশন সেগুলোর ওপর ভর করে এগোতে পারে।
মুখস্থ করা ও সংযোজন
Qwen3.6-35B-A3B কীভাবে “Once upon a midnight”-এর পরে “dreary” বসায়, সেটা দেখা যাক। Poe আর midnight-সম্পর্কিত নিউরনগুলো সাহিত্যিক প্রসঙ্গের একটি সংকেতকে জোরালো করে। এই সংকেত Pallas, Hamlet ও অন্য চেনা সাহিত্যাংশের আশপাশেও সাড়া দেয়। পরের স্তরগুলো এই প্রসঙ্গ পড়ে ঠিক করে, এর পরে কী আসবে। Poe নিউরনটি সরিয়ে দিলে “dreary”-এর প্রথম টোকেন আসার সম্ভাবনা 87% থেকে 50%-এ নেমে যায়। অথচ আউটপুটে শুধু তার সরাসরি অবদান সরালে সম্ভাবনা 85% থেকে যায়। অর্থাৎ তার কাজের বড় অংশ হলো, এরপর বাকি নেটওয়ার্ক কী করবে, তার দিকনির্দেশ দেওয়া।
শব্দটির আগে তৈরি হয় প্রসঙ্গ। পরের দিকের সাহিত্যিক নিউরনটিকে ফিরিয়ে দিলে সঠিকভাবে বাকিটুকু পূরণ করার সম্ভাবনা কিছুটা ফিরে আসে, 57%-এ পৌঁছায়।
কোনো নিউরনের গেট সাধারণ লেখায় দেখা তার মানের 99.9তম পার্সেন্টাইল ছাড়ালেই যদি তার আউটপুট শূন্য করে দিই, তাহলে মুখস্থ বলে যাওয়ার ক্ষমতা ভেঙে পড়তে পারে। Qwen3.6-এর একটি সংরক্ষিত পরীক্ষায় মডেলটি প্রথমে Psalm 23 হুবহু বলে দিচ্ছিল। পরিবর্তনের পরে সে জোর দিয়ে বলতে লাগল, এমন কিছু নেই। সংখ্যায় বা মাত্রায় সমান কিন্তু দৈবভাবে করা হস্তক্ষেপে স্তোত্রটি ঠিকই থেকে গিয়েছিল। কিছু অঙ্ক ও সারসংক্ষেপ তৈরির কাজ তখনো হচ্ছিল, যদিও কোড লেখা ও অন্য উত্তরগুলোর মানও কমে গিয়েছিল।
চরম সাড়াগুলো সরিয়ে দিলে মুখস্থ বলে যাওয়ার ক্ষমতা ভেঙে পড়ে।
Social Security: শনাক্ত করা ও ব্যবহার করা
Finding Neurons in a Haystack-এর তিন-নিউরনের “Social Security” প্রোবটি শব্দযুগল নির্ভুলভাবে শনাক্ত করে। পরবর্তী অনুসন্ধানে আমরা দেখেছি, তিনটি নিউরন আসলে পরিচিত শব্দ, নাম ও বাক্যাংশের পরের অংশে সাড়া দেয়। তাদের সাড়া একমত হলেই শনাক্তকারীটি এত বাছবিচার করে কাজ করতে পারে। কিন্তু পরের টোকেন বাছতে মডেল আসলে কী ব্যবহার করে, তার পথ অনুসরণ করে দেখা গেল সাধারণ শব্দভিত্তিক, ফর্মের ঘর-সংক্রান্ত, অবসর-সংক্রান্ত ও আউটপুট নিউরন। এর মধ্যে Social Security এবং 401(k)-এর পক্ষে প্রতিদ্বন্দ্বী ভোটও ছিল।

যাচাই করা 31টি নিউরনের মধ্যে এগারোটি। তাদের ভূমিকা দেখতে পয়েন্টার রাখুন বা ফোকাস করুন। সংখ্যাগুলো দেখায়, প্রতিটি নিউরন সরালে লক্ষ্য টোকেনের লগ-সম্ভাবনায় মোট কত পরিবর্তন হয়: ঋণাত্মক = সরালে ক্ষতি হয়; ধনাত্মক = সরালে সুবিধা হয়।
অবদান-মানচিত্রের নিরীক্ষা
একটি অবদান-মানচিত্র নিরীক্ষা করা কঠিন। অভিন্ন ভঙ্গির মতো পুনরাবৃত্ত গঠনধারার মাধ্যমে নিউরনগুলো দলবদ্ধ হতে ও আবার ব্যবহার হতে পারে, যা শুধু তাদের নাম দেখে ধরা যায় না। আমরা এজেন্ট দিয়ে 100,000 অবদান-মানচিত্র পর্যালোচনা করিয়েছি। আমি নিজেও ছবি ও ভাষা মিলিয়ে হাজার হাজার মানচিত্র পরীক্ষা করেছি। আপাত অস্বাভাবিক ঘটনাগুলো সাধারণত এমন গঠনধারা বলে ধরা পড়েছে, যা আমি আগে চিনতে পারিনি। এমন বড়সড় কোনো নিউরনগুচ্ছ পাইনি, যাদের একসঙ্গে সক্রিয় হওয়া ব্যাখ্যার বাইরেই থেকে গেছে। বিশ্বাসযোগ্য একটি উদাহরণ পেলেও আমি আমার ধারণা অনেকটা বদলাব। তবে আপাতত একে গুণগত প্রমাণ হিসেবেই দেখি। আমাদের বর্তমান যন্ত্রগুলোর ওপর এতটা ভরসা নেই যে এ থেকে পরিচ্ছন্নতার একটা স্কোর বানাব।
যে ব্যাখ্যা ভুলও প্রমাণিত হতে পারে
চাইলে যেকোনো কিছুরই ব্যাখ্যা দাঁড় করিয়ে ফেলা যায়, এই উদ্বেগটা ন্যায্য। তবে ভালো ব্যাখ্যা এতটাই নির্দিষ্ট হয় যে পরীক্ষায় হেরে যেতে পারে। আমাদের গ্যালারি থেকে দৈবভাবে বেছে নেওয়া 200টি নিউরনের প্রতিটির শুধু ব্যাখ্যাটুকু পড়ে একটি এজেন্ট পাঁচটি নতুন উদাহরণ লিখেছে, যেগুলো নিউরনটিকে সক্রিয় করার কথা। সঙ্গে লিখেছে কাছাকাছি ধরনের পাঁচটি উদাহরণ, যেগুলোতে সাড়া দেওয়ার কথা নয়। কোনো উদাহরণের সাড়া মাপার আগেই এগুলো লেখা হয়েছিল। যেসব 183টি নিউরনের ব্যাখ্যায় তাদের ধনাত্মক দিকটির বর্ণনা ছিল, নতুন উদাহরণগুলো সেগুলোকে 76% ক্ষেত্রে জোরালোভাবে সক্রিয় করেছে। কাছাকাছি কিন্তু সাড়া না দেওয়ার কথা এমন উদাহরণে হারটি ছিল 11%। ব্যাখ্যাটি জিতেছে 164টির ক্ষেত্রে, 15টিতে ফল সমান, আর 4টিতে হেরেছে। ছবিতে প্রথম বিশটি দেখানো হয়েছে।
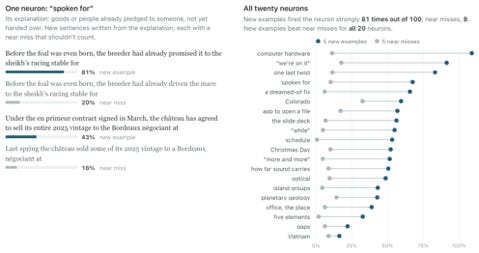
আমাদের গ্যালারির বিশটি Qwen3-32B নিউরন। একটি নিউরনের শুধু ব্যাখ্যা পড়ে এজেন্ট এমন পাঁচটি নতুন উদাহরণ লিখেছে, যেগুলোতে সাড়া দেওয়ার কথা, আর কাছাকাছি ধরনের পাঁচটি লিখেছে, যেগুলোতে দেওয়ার কথা নয়। সাড়ার মান দেখানো হয়েছে কর্পাসে নিউরনটির সবচেয়ে জোরালো উদাহরণের সাড়ার অনুপাত হিসেবে। 30% বা তার বেশি হলে তাকে জোরালো সাড়া বলা হয়েছে।
কোনো নিউরনের ব্যাখ্যাকে যাচাই ও প্রশ্ন করার অনেক উপায়ের একটি হলো পজিটিভ কন্ট্রোল, অর্থাৎ যেসব উদাহরণে সাড়া পাওয়ার কথা। আমাদের প্রকাশিতব্য গবেষণাপত্রে আরও অনেক পূর্বানুমান যাচাইয়ের মাপকাঠি ও পজিটিভ কন্ট্রোল আছে। তবে এখানে মূলত প্রতিটি নিউরনের নিখুঁত ব্যাখ্যা দেওয়ার দাবি আমরা করছি না। আমাদের আগ্রহ, জিনিসগুলো একসঙ্গে গড়ে ওঠে কেন, আর মোটামুটি কতগুলো নিউরন পড়ে বোঝা যায়।
কাছাকাছি কিন্তু সাড়া না দেওয়ার কথা এমন উদাহরণ অন্য একটি প্রশ্ন করে: একটি শাখা যখন বাড়ে, তখন কোথায় কোথায় বেড়েছে, তার সীমানা কি আঁকা যায়? প্রশ্নটি মজার, কিন্তু সুপারপজিশন যে প্রশ্ন তোলে, সেটি নয়। সুপারপজিশনে থাকা কোনো নিউরন যদি কেবল X বা Y-তে সাড়া দেয়, তাহলে কাছাকাছি এই উদাহরণগুলোর পরীক্ষায় সে দারুণ করবে। কারণ সেগুলো X-ও নয়, Y-ও নয়। সুপারপজিশনের জন্য চাই সম্পর্কহীন, অনেক দূরের কিছু; পাশের কোনো কিছুর সঙ্গে সামান্য তফাত যথেষ্ট নয়। তাই আমরা এজেন্টকে আরও বলেছি, যতটা সম্ভব দূরবর্তী একটি ধারণা ভাবতে, এমন কিছু যা নেটওয়ার্ক অন্য কিছুর সঙ্গে বাধা না লাগিয়ে গুঁজে রাখতে পারে, এবং তা নিয়ে পাঁচটি লেখা তৈরি করতে। সুপারপজিশন যা করত, এটা হুবহু তা নয়। ঠিক কোন সংজ্ঞা ব্যবহার করছি কিংবা কেমন আচরণ দেখা যাবে বলে আশা করছি, তার ওপরও তা নির্ভর করে; দুটোরই একাধিক রূপ আছে। তবু আমাদের মনে হয়, বিড়াল-গাড়ির নিউরনটি যে কাজ করছে বলে আগে ভাবা হতো, তার বেশ কাছাকাছি এটি: পুরো আলাদা দুটো জিনিস একসঙ্গে থাকা, কেবল এত আলাদা বলেই একই দলে থাকা। আমাদের মতে, ওই আচরণ যাচাইয়ের জন্য এটা যথেষ্ট সুসংগত একটি পরীক্ষা। ওই লেখাগুলো প্রায় 1% ক্ষেত্রে সংশ্লিষ্ট নিউরনকে জোরালোভাবে সক্রিয় করেছে। আর 183টি নিউরনের 179টিই সেগুলোতে একবারও সক্রিয় হয়নি। মিক্সচার অব এক্সপার্টস মডেলে এমন গুঁজে রাখা এমনিতেই প্রায় অসম্ভব, এ যুক্তিও দেওয়া যায়। কারণ এত দূরের টোকেনগুলোকে একই বিশেষজ্ঞ মডিউলেই পাঠানো হয় না; বিশেষজ্ঞ মডিউলের মানচিত্র দেখুন।
কোনো কিছু সাধারণীকরণ না সুপারপজিশন, তা বোঝার জন্য নিয়ন্ত্রণ-উদাহরণ থেকে সেটাকে আলাদা করা যায় কি না, তার চেয়ে বেশি জরুরি হলো, জিনিসগুলো আদতে একসঙ্গে আছে কেন। তাই এখানে বেশি গুরুত্ব পায় সবচেয়ে পরিচিত ও গুরুত্বপূর্ণ উদাহরণগুলো গুণগতভাবে দেখা, আর নিউরন কী ধরনের জিনিস গড়ে তোলে এবং তাদের সক্রিয়তার পরিসর কেমন, সে সম্পর্কে ধারণা পাওয়া।
সংযোগ থেকে ফিচার বের করা
সংযোগের পুনরাবৃত্ত গঠনধারা, অর্থাৎ অবদান-মানচিত্রে বারবার দেখা দেওয়া সংযোগের নকশা নিয়ে আমরা বিশেষভাবে উৎসাহী। নিউরন যদি পার্থক্য চিহ্নিত করে, তবে এই গঠনধারাগুলো দেখায়, একটি পার্থক্য কীভাবে আরেকটিতে তথ্য জোগায়। 25,000 ImageNet অবদান-মানচিত্রকে উপাদানে ভেঙে আমরা সাধারণ নিউরনের সংযুক্ত সার্কিট পেয়েছি, যেমন নিচের চায়ের পাত্রের সার্কিটটি। সক্রিয়তার তুলনাযোগ্য দলগুলোর চেয়েও এই গঠনধারাগুলো অনেক ভালো বলে দিতে পেরেছে, কোথায় অপসারণ-পরীক্ষা করলে প্রভাব পড়বে। তাদের নিউরন সরিয়ে দিলে যেসব ছবি সেগুলো ব্যবহার করে, সেসব ছবিতে বেশি ক্ষতি হয়েছে। ফলে বিমূর্তভাবে ভাবার জন্য সংযোগ একটি সম্ভাবনাময় স্তর। এই স্তর থেকে আমরা দূরে সরে বড় ছবিটা দেখতে পারি, আবার প্রতিটি অংশের পথ ধরে মূল নেটওয়ার্কেও ফিরে যেতে পারি।

সংযোগের পুনরাবৃত্ত গঠনধারা পার্থক্যগুলোকে জুড়ে দেয়। একটি গঠনধারার সাধারণ নিউরন, এবং 96টি সক্রিয়তা-ফ্যাক্টরের সঙ্গে 96টি সংযোগ-গঠনধারার সব কটির তুলনা।
নেটওয়ার্ক কেন সাধারণীকরণ করে
নিউরাল নেটওয়ার্ক কেন সাধারণীকরণ করে, তার একটিমাত্র সর্বস্বীকৃত ব্যাখ্যা নেই। তবে বেশির ভাগ ব্যাখ্যার মূল কথা অভিন্ন ধরন: নেটওয়ার্ককে ছয়টি কুকুর দেখাও, সে তাদের মিল খুঁজে নেবে। সমস্যা হলো, নেটওয়ার্ক কখনো দল দেখে না। ছোট ছোট ব্যাচে, একেকবার একেকটি উদাহরণ দেখে। নীতিগতভাবে সে প্রতিটিই মুখস্থ করে ফেলতে পারে; তাতে তার লসের কোনো আপত্তি থাকবে না। অগ্রবর্তী গবেষণাগারের গবেষকদের জিজ্ঞেস করায় কয়েকজন আমাকে বলেছেন, তাঁরা নিশ্চিত নন। প্রচলিত একটি অনুমান ছিল, নেটওয়ার্ক আগে মুখস্থ করে, তারপর দ্বিতীয় দফায় সাধারণীকরণ করে। আমাদের উত্তর হলো, প্রথম ধাপ থেকেই সে সাধারণীকরণ শুরু করে।⁷ সার্কিটের বাস্তুতন্ত্রের ছবিতে সাধারণীকরণ ও সংযোজন শেখার দৌড়ে জেতে, কারণ এরা সবচেয়ে দ্রুত। অবশিষ্ট ত্রুটি ধরার জন্য সার্কিটগুলোর মধ্যে প্রতিযোগিতা চলে। যারা আগে থেকে থাকা জিনিস পুনরায় ব্যবহার করে এবং নিজেরাও আবার অন্যের কাজে লাগে, তারা বাকিদের হারিয়ে দেয়। বিজয়ীর হাত ধরে যা রয়ে যায়, সেটাই সাধারণীকরণ।
⁷ Arpit ও তাঁর সহকর্মীরা (2017) বাস্তব ডেটার মধ্যে এলোমেলো লেবেল মিশিয়ে যা দেখেছিলেন, এর সঙ্গে তা মেলে: নেটওয়ার্ক আগে বাস্তব ধরনগুলো শিখেছে, পরে নয়েজের সঙ্গে খাপ খাইয়েছে। Satrajit Chatterjee-র coherent gradients (2020) ধারণারও কাছাকাছি এটি: একই ধরনের উদাহরণ থেকে আসা আপডেটগুলো যোগ হতে থাকে। ফলে যে পরিবর্তন একই সঙ্গে অনেক উদাহরণের কাজে লাগে, সেটিই সবচেয়ে দ্রুত বাড়ে।
নেটওয়ার্ক কেন সাধারণীকরণ করে, তার তিনটি ব্যাখ্যা। প্রচলিত ব্যাখ্যাগুলো বলে প্রশিক্ষণ শেষ পর্যন্ত কোথায় পৌঁছায়, অথবা ধরে নেয় নেটওয়ার্ক আগে মুখস্থ করে। আমাদের ধারণা, প্রথম উদাহরণ থেকেই একটি ব্যাপক ফিচার জিততে শুরু করে।
আমরা ব্যাপারটা এভাবে কল্পনা করি। একেবারে অপ্রশিক্ষিত একটি নেটওয়ার্ককে ল্যাব্রাডর রিট্রিভারের একটিমাত্র ছবি দিয়ে প্রশিক্ষণ দিন। ভাবুন, ছবিটা ব্যাখ্যা করার জন্য দুটি সার্কিট প্রতিযোগিতা করছে। একটি খুব নির্দিষ্ট কিছু খোঁজে: পিক্সেল 322 এই রঙের হলে বলবে ল্যাব্রাডর। অন্যটি খোঁজে ব্যাপক কিছু, যেমন সবুজ ঘাস বা বাদামি-হলদেটে লোম। ব্যাপক সার্কিটটি ছবির বেশি অংশে সক্রিয় হয়। ফলে ঠিক পরের ধাপেই সে শেখার সংকেত বেশি পায়। সে দ্রুত বাড়ে, অবশিষ্ট ত্রুটির বেশি অংশ ধরে ফেলে, আর পিক্সেলের সার্কিটটির শেখার জন্য ক্রমে কম থেকে কম সংকেত রেখে যায়। একসময় সেটি অভুক্ত হয়ে পড়ে। তারপর যার আছে, তার আরও বাড়ে: পরের কোনো ছবিতে ঘাস থাকলে শুরু থেকেই সবুজের সার্কিটটি খানিকটা সক্রিয় থাকে।

একটি ব্যাপক ফিচার ছবির বেশি অংশে সক্রিয় হয়। তাই সে শেখার সংকেত বেশি পায় এবং দৌড়ে জিতে যায়; এক-পিক্সেলের শর্টকাটটি অভুক্ত থাকে। সে যা শিখেছে, তা পরের ছবিতে তাকে শুরু থেকেই এগিয়ে দেয়।
শুধু এই ছবিটি দিয়ে একেবারে শুরু থেকে প্রশিক্ষিত একটি নেটওয়ার্কের ল্যাব্রাডর আউটপুটের জন্য সর্বোচ্চ সাড়ার ছবিগুলো। তার প্রথম পছন্দ ঘাসের ওপর দুটি কুকুর। কিন্তু সে মূলত শিখেছে ছবির গাঢ় ও সবুজ রং, “কুকুর” নয়। একটিমাত্র উদাহরণ থেকেও ব্যাপক ফিচারটি জেতে এবং সামান্য সাধারণীকরণ করে।
আরেকটু বড় করেও আমরা পরীক্ষা করেছি। আগে আর কিছুই দেখেনি এমন একটি নেটওয়ার্ককে দশটি জিনিসের একটি করে ছবি দিয়েছি: একটি ল্যাব্রাডর, একটি স্পোর্টস কার, একটি গোল্ডফিঞ্চ, এই রকম। নতুন ছবির প্রায় পাঁচটির মধ্যে একটিকে সে সঠিক লেবেল দেয়, যা দৈব অনুমানের দ্বিগুণ। আর এর বেশির ভাগই দেখা যায় প্রথম কয়েক ডজন ধাপের মধ্যে, যখন তার ওই দশটি ছবি শেখার কাজই তখনো চলছে। খুব বেশি কিছু নয়: রং মিলিয়ে ছবি বাছলেও প্রায় একই ফল হয়। আর নতুন ছবিতে যা কাজে লাগে, তা মূলত রং, গড়ন নয়। তবু এ এক উদাহরণ থেকে সাধারণীকরণ, এবং শুরু থেকেই তার পরিসর ব্যাপক।

সারাজীবনে শুধু এই দশটি ছবি দেখেছে এমন একটি নেটওয়ার্ক নতুন ছবির প্রায় পাঁচটির একটিতে ঠিক লেবেল দেয়, দৈব অনুমানের দ্বিগুণ। পিক্সেল মিলিয়ে সবচেয়ে কাছের ছবি বাছার চেয়ে এটি একটু ভালো, তবে রং মিলিয়ে বাছার চেয়ে ভালো নয়।
সব সময় অবশ্য এমন হয় না। grokking-এর ক্ষেত্রে, যেমন মডুলার পাটিগণিতের মতো কাজে, মুখস্থ করাই আগে জেতে। সেখানেও Nanda ও তাঁর সহকর্মীরা[24] দেখেছেন, সাধারণীকরণকারী সার্কিটটি আড়ালে ধীরে ধীরে বেড়ে ওঠে। সে কর্তৃত্ব নেয় ও মুখস্থ করার ব্যবস্থা সরিয়ে দেয় অনেক পরে। কিন্তু আমরা যত স্বাভাবিক ডেটা দেখেছি, তার বেশির ভাগে মোটামুটি থেকে সূক্ষ্মের দিকে যাওয়ার পদ্ধতি শুরু থেকেই জেতে। নেটওয়ার্ক আগে মুখস্থ করে পরে সাধারণীকরণ করে না।
সার্কিটের দৌড়
সার্কিটের বাস্তুতন্ত্রে শুরুতে এগিয়ে থাকার যে সুবিধা, এটা পুরো নেটওয়ার্কের স্তরে তারই একটি রূপ। আগেই প্রশিক্ষিত যমজ নেটওয়ার্কটি অভিন্ন লক্ষ্য পূরণের প্রায় সব কৃতিত্ব নিয়ে নেয়। ফলে অপ্রশিক্ষিতটির শেখার জন্য খুব কমই অবশিষ্ট থাকে। এখানে প্রতিযোগিতা একটি নেটওয়ার্কের ভেতরের সার্কিটগুলোর মধ্যে নয়, দুটি গোটা নেটওয়ার্কের মধ্যে। তবু এতে বোঝা যায়, শুরুতে এগিয়ে থাকা কতটা গুরুত্বপূর্ণ হতে পারে।
আরেকটি মডেলের ছায়ায় শেখা। বেছে নেওয়া দুটি তুলনা, প্রতিটি র্যান্ডম সিডসহ দেখানো। বিন্দু দিয়ে আঁকা রেখা দেখায়, প্রতিটি মডেল একা কী শিখেছে। সোনালি ফালি দেখায়, অভিন্ন লক্ষ্যটি কীভাবে কৃতিত্ব ভাগ করে দিচ্ছে; বিন্দু দিয়ে আঁকা মাঝের রেখা = 50%।
নিউরনের বেড়ে ওঠা দেখা
বহুঅর্থক নিউরনের জন্য পরিচিত InceptionV1-কে আমরা নতুন করে প্রশিক্ষণ দিয়েছি। নিউরনগুলো কীভাবে গড়ে ওঠে দেখেছি, যাতে বোঝা যায় তাদের মিশ্রণ আসে কোথা থেকে। পরিবর্তনগুলো স্থানীয়: একটি নিউরন সম্পর্কহীন জিনিস কুড়িয়ে নেওয়ার বদলে কাছাকাছি জিনিসের দিকে সরে যায়। প্রকাশের ঠিক আগে আমার অণুবীক্ষণযন্ত্রের জুম ভুলভাবে সেট করা ছিল। কিছুক্ষণের জন্য মনে হয়েছিল, এই নিউরনটিতে বুঝি সত্যিই কিছু নির্বিচার মিশ্রণ আছে। আসলে শুধু জুমের ভুল। তখনো আমি সেই ভুলটাই করছিলাম, যা দিয়ে এ পর্যন্ত ব্যাখ্যাযোগ্যতার অনেক কাজ বোঝা যায় বলে আমার মনে হয়: অণুবীক্ষণযন্ত্রের দোষ নেটওয়ার্কের ঘাড়ে চাপানো।
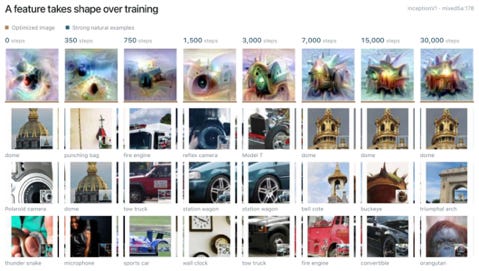
প্রশিক্ষণের সঙ্গে একটি ফিচার আকার নিচ্ছে। পুরো পথচলা, পাশাপাশি। প্রতিটি কলামে InceptionV1-এর নতুন করে প্রশিক্ষিত শেষের অংশজুড়ে একই স্থানাঙ্ক অনুসরণ করা হয়েছে। ওপরের ছবিটি অপ্টিমাইজ করা; নিচেরগুলো স্বাভাবিক উদাহরণ, সবচেয়ে জোরালো সাড়ার অবস্থানকে কেন্দ্রে রেখে দেখানো।
প্রশিক্ষণের শুরুর পর্যায়ের অণুবীক্ষণযন্ত্র ঘুরে দেখুন ↗
সরল পরীক্ষামূলক মডেল
অগ্রবর্তী কোনো নিউরাল নেটওয়ার্ক যদি হয় বৃষ্টিবন, তাহলে InceptionV1 আর আমাদের প্রশিক্ষিত ছোট মডেলগুলো বাগান, আর সরল পরীক্ষামূলক মডেল বা টয় মডেলগুলো পেট্রি ডিশ। পেট্রি ডিশ ভীষণ কাজে লাগে, যতক্ষণ আপনি যে প্রক্রিয়া নিয়ে পড়তে চান, তা সেখানে বজায় থাকে। আমাদের একটি মডেল TensorFlow Playground-কে বাড়িয়ে বানানো, যাতে দেখা যায় কীভাবে কয়েকটি কাজ একই হিডেন নিউরন ভাগ করে ব্যবহার করে। একবার চালিয়ে দেখা গেল, দুটি নিউরন বিপরীত দুটি কর্ণ বরাবর সাড়া দিতে শিখেছে। নেটওয়ার্ক সেগুলোকে একভাবে জুড়ে একটি বৃত্ত, আর অন্যভাবে জুড়ে চারটি কোণা শনাক্ত করেছে। এমন সমাধান আমরা আশা করিনি; বেশ বুদ্ধিদীপ্ত ছিল।
শেষ স্তরের দুটি নিউরন বিপরীত দুটি কর্ণ বরাবর সাড়া দেয়। প্রতিটি কাজ নিজের ওজন দিয়ে সেগুলো পড়ে; নীল ধনাত্মক, কমলা ঋণাত্মক। এটি মূল প্লেগ্রাউন্ড পরীক্ষাটি, আপনার ব্রাউজারেই সরাসরি নতুন করে প্রশিক্ষণ দেওয়া হচ্ছে।
আপনি বলতে পারেন, বৃত্ত আর চারটি কোণা হলো একই নিউরনজুড়ে গুঁজে রাখা দুটি ফিচার। কথাটা সত্যি, কিন্তু এতে মডেল আসলে কী করেছে, তা ধরা পড়ে না: সে এমন জ্যামিতি খুঁজে পেয়েছে, যা দুটো কাজেই ব্যবহার করতে পারে। নিউরনগুলোর দিকে তাকানোর ফলে সেটা দেখা গেছে। আর ব্যাখ্যার কাছে আমি এই পরীক্ষাতেই উত্তীর্ণ হওয়া চাই: মডেল সত্যিই যে গণনা শিখেছে, ব্যাখ্যা কি সেটা দেখায়?
সবচেয়ে বেশি গবেষণা হওয়া পেট্রি ডিশটি হলো Toy Models of Superposition। কাজটি যত্ন নিয়ে করা, আমাদের ক্ষেত্রের যে মানের কাজের লক্ষ্য রাখা উচিত, তেমনই। এর পরীক্ষাগুলোয় আমরা কোনো সমস্যা পাইনি। কিন্তু এটি একটি নেটওয়ার্ককে দেখে নির্দিষ্ট সংখ্যক নিউরন আর আগে থেকে নির্ধারিত কিছু ফিচার হিসেবে। তারপর জিজ্ঞেস করে, ফিচারগুলো সেখানে কীভাবে আঁটবে। এতে এক নিউরন ভাগ করে ব্যবহারের খরচ, অর্থাৎ একে অন্যের কাজে বাধা দেওয়া, হিসাবে আসে। কিন্তু লাভটা, অর্থাৎ পুনর্ব্যবহার, আসে না। এর পুনর্গঠনের কাজে প্রতিটি ফিচার নিজেই শেষ লক্ষ্য। দুটি ফিচারের মধ্যে যে মিল আছে, পরের দিকে কোনো কিছু তার ওপর ভর করে গড়ে ওঠে না। বাস্তব নেটওয়ার্কে একটি উপস্থাপনের গুরুত্ব নির্ভর করে শুধু সেটাকে কে পড়ছে, তার ওপর। আর সেখানে আগে থেকে ঠিক করা ফিচারও নেই। সবকিছু গড়ে ওঠে, আর কী কাজে লাগছে, তার মাধ্যমেই তার পরিচয় নির্ধারিত হয়।
পুনর্ব্যবহারের যুক্তি বলে দেয়, গুঁজে রাখা খুঁজতে আমি কোথায় তাকাব: এমন স্মৃতি, যা সত্যিই নিজেই শেষ লক্ষ্য, অন্য কিছুর সঙ্গে সম্পর্কহীন। সেটাই এই টয় মডেলের জগৎ। আর সেখানে সত্যিই গুঁজে রাখা ঘটে, গবেষণাপত্রে যেমন পাওয়া গেছে। তাই টয় মডেলের জগৎ নিয়ে গবেষণাপত্রটির সঙ্গে আমাদের মতবিরোধ আছে বলে মনে করি না। প্রশ্ন হলো, বাস্তব নেটওয়ার্ক কোন জগতে আছে: মডেল যতটা সঞ্চয় করতে পারে, তার তুলনায় তার ডেটায় কতটা গঠন আছে। বাস্তব ডেটায় প্রায় কোনো কিছুই পুরো সম্পর্কহীন নয়। ভাষায় বিরল তথ্যের দীর্ঘ লেজের ক্ষেত্রেও একই কথা। কোনো ব্যক্তির উল্লেখ খুব বিরল হলেও তাঁর একটি দেশ, পেশা আর নাম আছে। এমনকি অর্থহীন লেবেল লাগানো ছবিতেও এমন অংশ থাকে, যা নেটওয়ার্ক আগে থেকেই চেনে। যেমন সেই ছাতা, যাকে আমরা মৌমাছি বলতে শিখিয়েছিলাম। বাকি থাকে এমন ইনপুট, যার কোনো গঠনই নেই; যেমন এলোমেলো লেবেল লাগানো নিখাদ নয়েজ। Zhang ও তাঁর সহকর্মীরা দেখিয়েছেন[25], নেটওয়ার্ক সেটাও শিখতে পারে। যদিও বাস্তব ডেটা শেখার চেয়ে ধীরে শেখে। এমনকি তখনো আমাদের মডেল তার আগে থেকে চেনা টেক্সচার থেকে খানিকটা ধার নিয়েছিল।
Toy Models of Superposition-এর মূল ব্যবস্থায় অনেক স্বাধীন ফিচারকে কয়েকটি মাত্রায় ঠেসে দেওয়া হয়, তারপর আবার সেগুলো কপি করে বের করা হয়। কোনো কিছু গড়ে ওঠার জন্য সেখানে হিডেন নিউরন নেই। এর অন্য পরীক্ষাগুলোতে পারস্পরিক সম্পর্কযুক্ত ফিচার এবং হিডেন নিউরনসহ মডেল পরীক্ষা করা হয়েছে, তবে আলাদা আলাদাভাবে।
আমরা যখন পারস্পরিক সম্পর্কযুক্ত ইনপুট ও হিডেন নিউরন একই মডেলে রেখেছি, তখন সম্পর্কযুক্ত ইনপুটগুলোকে ঘিরেই নিউরনে সাড়া গড়ে উঠেছে। ইনপুটগুলো আরও ঘন ঘন সক্রিয় করলে টয় মডেলটি গবেষণাপত্রে “PCA-like” বলা সমাধানের দিকে সরে যায়। সেখানে সম্পর্কযুক্ত ইনপুটগুলোকে একত্র করে অভিন্ন উপস্থাপন বানানো হয়।
Toy Models of Superposition-এর মডেল, যেখানে 20টি ইনপুট চারটি দলে ভাগ করা, আর প্রতিটি দলের ইনপুটগুলো একসঙ্গে সক্রিয় হয়, আছে 5-মাত্রিক একটি সংকীর্ণ পথ বা বটলনেক এবং তার পরে যোগ করা হিডেন নিউরনের একটি স্তর। রং দেখায়, বটলনেকের ওজনের কত অংশ ডেটার প্রধান প্রিন্সিপাল কম্পোনেন্টগুলোর দিকে আছে। এখানে সেগুলো হলো দলগুলোর অভিন্ন দিক। ছোট ছবিগুলো ইনপুটের প্রতিটি জোড়ার দিকের মধ্যকার কোসাইন দেখায়।
টয় মডেলটি যে ব্যর্থতার পূর্বানুমান করে, তা মানুষ যে ব্যর্থতার কথা জানায়, তার থেকেও আলাদা। এর উদ্বেগ হলো, নিউরনগুলো মোটামুটি মিশ্রণমুক্ত থাকলেও বিরল ফিচারগুলো অক্ষের বাইরে ঠেলে দেওয়া হচ্ছে। আর বহুঅর্থকতার প্রতিবেদনে মিশ্রণ দেখা যায় নিউরনগুলোর নিজেদের মধ্যেই। এই ব্যবধানের একটা অংশ “ফিচার” শব্দটির কারণে; নিচে আবার সে কথায় ফিরব।
সার্কিটের বাস্তুতন্ত্র নিয়ে আরও কিছু কথা
সাধারণীকরণ ও সংযোজন কেন বারবার জেতে, তা জানার ওপর আমাদের পর্যবেক্ষণের ফল নির্ভর করে না। তবে আমাদের একটা অনুমান আছে: তারা একটি দৌড়ে জেতে। নেটওয়ার্কের যে এলাকায় আগে থেকেই উপযোগী অংশ এবং সেগুলোর তথ্য পড়ার ব্যবস্থা আছে, সে সম্পূর্ণ নতুনভাবে শুরু করা যেকোনো কিছুর চেয়ে দ্রুত পরের সম্পর্কিত জিনিসটি শিখতে পারে। ফলে প্রতিযোগী বেড়ে ওঠার আগেই সে ত্রুটির সংকেত নিয়ে নেয়। নতুন শাখা গজানোও যেন একই দৌড়: যে নিউরন আগে থেকেই সবচেয়ে কাছাকাছি ছিল, সে ত্রুটির একটু অংশ তুলে নেয়।
আমাদের মনে হয়, শুরুতে এগিয়ে থাকার এই সুবিধা থেকেই পুনরাবৃত্ত সাধারণীকরণ আসে। যে নিউরন “iy”-তে সক্রিয় হয়, “diy”-তেও সে আগে থেকেই সক্রিয়। তাই “do it yourself” ধরার সারিতেও সে সবার আগে থাকে। কথাটার অর্থ একই, কিন্তু তাতে “iy” নেই। একটি নিজস্ব ক্ষেত্রের কিনারায় তাকালে যা দেখা যায়, সেটাই পুনরাবৃত্ত সাধারণীকরণ।
নতুন কোনো গণনার জন্য যে নিজস্ব একটি নিউরন লাগবেই, তা নয়। আগে থেকে থাকা যন্ত্রপাতির স্থানীয় সম্প্রসারণ বা সংযোজন হিসেবেও তার শুরু হতে পারে। যেমন, ছাতার পথ থেকে “bee” বা মৌমাছির দিকে বেরিয়ে যাওয়ার শাখাটি। বিকাশের হিসাবে পথ বদলানোই হয়তো সবচেয়ে ছোট দূরত্ব। তাই একটি নতুন, আলাদা প্রক্রিয়া শুরু হওয়ার আগেই এটি ত্রুটির সংকেত ধরে ফেলতে পারে।
আমাদের সন্দেহ, অন্য গণনাগুলোকে যখন কোনো একটি কাজের ওপর ভর করে গড়ে উঠতে হয়, তখন সেই কাজ একটি আলাদা নিউরনে সংহত হওয়া বিশেষভাবে উপকারী হয়ে ওঠে। একটি গাড়ির নিউরন বারবার ব্যবহারযোগ্য একটি সিদ্ধান্ত দেয়। পাশাপাশি ট্যাক্সি, অ্যাম্বুলেন্স ও অন্য বিশেষজ্ঞদের গড়ে ওঠার জন্য একটি সুরক্ষিত জায়গাও দেয়। এর একটি দিক হলো, তার ওপর আরও কিছু গড়ে তোলা কতটা সহজ।
সম্পর্কহীন নিউরনের দুর্বোধ্য কোনো সমন্বয় এমন বিকাশের জন্য ভালো জায়গা না-ও হতে পারে। সেখানে সক্রিয় হওয়ার পথ দুর্বল হতে পারে, গ্রেডিয়েন্টে দ্বন্দ্ব থাকতে পারে, উত্তরাধিকারসূত্রে পাওয়ার মতো উপযোগী যন্ত্রপাতিও কম থাকতে পারে। তার প্রতিযোগী শুধু একটি নিবেদিত নিউরন নয়; কাজটির উপযোগী হয়ে থাকা কোনো এলাকায় সাধারণ সংযোজনও তার প্রতিদ্বন্দ্বী।
InceptionV1-এর মধ্যে হাতে করে গুঁজে রাখা একটি কোড বানাতে গিয়ে আমরা এমন কিছু দেখেছি। একসময় তার car → dogs → car সার্কিটটি যা করছে বলে ভেবেছিলাম, তার আদলেই কোডটি বানিয়েছিলাম। আমাদের ধারণা ছিল, বসানো সহজ হবে, টিকিয়ে রাখা কঠিন। কিন্তু ছোট ছোট অমিল এত বাধা তৈরি করল যে কোডটি অনেক সময় গোড়া থেকেই কাজ করেনি। আর যখন করেছে, তখনো নেটওয়ার্ক সাধারণত তার ওপর নির্ভর করা কমিয়ে দিয়েছে, যদিও কিছু টিকে ছিল। সমস্যার একটা অংশ হলো, নিউরনের আসল কাজ কপি করা নয়; গণনা করে পার্থক্য চিহ্নিত করা। গুঁজে রাখার ব্যবস্থাটাই তৈরি করা কত কঠিন, সেটা দেখাও আমাদের বিকাশভিত্তিক উত্তরের দিকে নিয়ে গেছে। গ্রেডিয়েন্ট ডিসেন্ট আমাদের চেয়ে অনেক ভালোভাবে সূক্ষ্ম সমন্বয় করতে পারে। তাই এই অভিজ্ঞতা একা যথেষ্ট প্রমাণ নয়। কিন্তু আমরা যে সার্কিটের নকল করছিলাম, সেখানে গ্রেডিয়েন্ট ডিসেন্টও গুঁজে রাখার পদ্ধতি ব্যবহার করেনি।
যেসব সাড়ার ব্যাখ্যা এখনো মেলেনি
InceptionV1-এর একটি নিউরন মাঝখানে চাপা বা সরু হয়ে যাওয়া একটি আকার ধরে: বো টাই, প্রজাপতি, সাঁতারের পোশাকের ওপরের অংশ। কিন্তু সেগুলোর সঙ্গে আসে এমন জিনিসেও সে সাড়া দেয়। বো টাইয়ের সঙ্গে পুরুষের আনুষ্ঠানিক পোশাকের জুতা, আর সাঁতারের পোশাকের ওপরের অংশের সঙ্গে সৈকতের ব্যাগ ও ফ্লিপ-ফ্লপ। কারণ আগের স্তরগুলোতে তারা একই নিউরন ভাগ করে ব্যবহার করে।
অভিন্ন আকার, সঙ্গে অর্থের রেশ। InceptionV1, mixed5a:719।
আমাদের মতে, একে নির্বিচারে গুঁজে রাখার চেয়ে অর্থের রেশসহ সাধারণীকরণ বলা বেশি মানানসই। তবে এই ব্যতিক্রমগুলো আমি এখনো পুরোপুরি বুঝি না।
ফিচার ও সংজ্ঞা নিয়ে কিছু কথা
সুপারপজিশন নিয়ে কথা বলতে আমার অসুবিধার একটা কারণ হলো, “ফিচার” দিয়ে এমন কিছু বোঝানো হতে পারে যা আমাদের কাছে গুরুত্বপূর্ণ, আবার এমন কিছুও বোঝানো হতে পারে যা নিউরাল নেটওয়ার্ক মৌলিক নির্মাণ-উপাদান হিসেবে শিখেছে। কিংবা দুটোর কোনো মিশ্রণ। এগুলো আলাদা আলাদা দাবি। মানুষের জন্য কাজের একটি বর্ণনা যে মডেলের মৌলিক একক হবে, তা নয়। প্রক্রিয়ার দিকে তাকিয়েই আমরা এমন অনেক পুনরাবৃত্ত গঠনধারা পাই, যেগুলোকে আমাদের প্রত্যাশার কোনো কিছুর সঙ্গে সহজে মেলানো যায় না। নেটওয়ার্কের যদি আরও মৌলিক একক থাকে, তাদের সীমানাও যে আমাদের ধরা সীমানার সঙ্গে মিলবে, তা ধরে নেওয়া উচিত নয়।
ফিচার অনেক সময় আমাদের চিন্তার কাজটাই আরও কঠিন করে তুলেছে। V নিউরনের ভেতরের গাড়ি আর বিড়াল কি আরেকটি V ফিচারের মধ্যে থাকা দুটি আলাদা ফিচার? নাকি V-টাকে চিনে ফেলার পর গাড়ি আর বিড়াল আর ফিচার থাকল না? এই এককগুলো কী, তার ব্যাখ্যা না থাকলে বোঝা কঠিন, আমরা নেটওয়ার্ক সম্পর্কে কিছু আবিষ্কার করেছি, নাকি সেটার বর্ণনা দেওয়ার ধরন বদলেছি। আলাপ করতে গিয়ে দেখেছি, মানুষ সুপারপজিশনের কোনো ধারণায় যতটা দৃঢ়, ফিচারের নির্দিষ্ট কোনো ব্যাখ্যায় ততটা নয়। কিন্তু ফিচার যদি মৌলিক একক না হয়ে উপযোগী বর্ণনা হয়, তাহলে কতগুলো ফিচার আছে, সে দাবি নির্ভর করে আমরা কোন বর্ণনাগুলো বেছে নিচ্ছি তার ওপর। এখন ফিচারের ভাষায় কাজ করার উপযোগিতা নিয়েই আমি বেশ সন্দিহান। এতে নির্বিচারে গুঁজে রাখা ঘটে কি না, তার মীমাংসা হয় না। তবে ফিচার গোনার কাঠামো ব্যবহার করা কঠিন হয়ে পড়ে।
তবু হয়তো ফিচারের ধারণাই ঠিক। শহরকে বিভিন্ন এলাকা ধরে ভাবার অর্থ আছে, আর আমিও প্রক্রিয়ার গুচ্ছ ধরে ভাবার পুরো পক্ষে। কিন্তু শব্দটা এখন ভারাক্রান্ত, কারণ এর অর্থ দাঁড়িয়েছে অনেক বেশি কিছু। নিউরনের একটি এলাকা বোঝাতে শব্দটা ব্যবহার করলেই মানুষ হয় মৌলিক ফিচার, নয়তো অভিধানের এন্ট্রি শুনতে পায়। এই ছবিটা যদি ঠিক হয়, তাহলে আমার সন্দেহ, সামনে আমাদের আরও নির্দিষ্ট শব্দ লাগবে, যার অর্থ এত সহজে বদলে নেওয়া যায় না। OpenAI-এর একটি পোস্টে[26] বলা হয়েছিল, অগ্রবর্তী একটি মডেলের মানচিত্র করতে শত কোটি বা লক্ষ কোটি ফিচার লাগতে পারে। তখন মডেলগুলো এখনকার চেয়ে ছোটও ছিল। আমার ধারণা, সঠিক তালিকাটা অনেক ছোট।
একার্থক আর বহুঅর্থক শব্দ দুটিও হয়তো পুরোপুরি ঠিক নয়। একটি কিডনি বর্জ্য ছাঁকে, লবণ ও পানির ভারসাম্য রাখে, রক্তচাপ নিয়ন্ত্রণে সাহায্য করে, আবার অস্থিমজ্জাকে লোহিত রক্তকণিকা তৈরির সংকেতও দেয়। অথচ কেউ জানতে চায় না, কিডনি ‘এককাজের অঙ্গ’ কি না। আমরা জানতে চাই, এর কতটা বুঝেছি, কী কী প্রশ্নের উত্তর এখনো মেলেনি, আর এর কাজকর্ম কতটা সুসংগঠিত। উপস্থাপন নিয়ে দাবি আর সংগঠন নিয়ে দাবির মধ্যেও পার্থক্য আছে। Toy Models of Superposition[7] সুপারপজিশনকে সংজ্ঞায়িত করে মাত্রার সংখ্যার চেয়ে বেশি ফিচার উপস্থাপন করা হিসেবে। ওই সরল পরীক্ষামূলক মডেলগুলোতে ফিচার আগে থেকেই নির্ধারিত থাকে, তাই সেখানে প্রশ্নটি সুনির্দিষ্ট। পরে প্রকাশিত অনানুষ্ঠানিক নোট Distributed Representations: Composition & Superposition[11] সংযোজন ও সুপারপজিশনের মধ্যে আপসের বিষয়টিতে জোর দেয়। নোটটি এই দুই ছবিকে যুক্ত করেছে বটে, তবে সামনে এনেছে আলাদা দুটি প্রশ্ন।
আমার ভাবনাটি দ্বিতীয় কাঠামোটির বেশি কাছাকাছি, যখন সেটিকে প্রক্রিয়া এবং সেই প্রক্রিয়াগুলো কীভাবে গড়ে ওঠে তার ওপর প্রয়োগ করা হয়। এই প্রতিক্রিয়াগুলো একই নিউরন বা সার্কিটে কেন থাকে? নেটওয়ার্ক কি কোনো কাজে লাগার মতো সাধারণ ধরনকে ভিত্তি করে নতুন কিছু গড়ছে? নাকি পরস্পরের সঙ্গে খুব কম সংঘর্ষ হয় বলে অন্যথায় সম্পর্কহীন গণনাগুলো একই জায়গার সামর্থ্য ভাগ করে নিচ্ছে? শুধু ফিচার গুনে এই প্রশ্নের উত্তর মেলে না, বিশেষ করে ফিচার বলতে কী বোঝাব, তা নিয়েই যখন ঐকমত্য হয়নি।
আমরা সুপারপজিশনের একটি অর্থেই মন দিচ্ছি: ইচ্ছেমতো সম্পর্কহীন জিনিস গুঁজে রাখা। কারণ, সত্যি হলে এটাই খুব খারাপ খবর হবে, আর আমাদের ধারণা, ব্যাখ্যাযোগ্যতার অনেক কিছু এর ওপর নির্ভর করে। Toy Models-এ ব্যবহৃত অর্থটি, অর্থাৎ মাত্রার চেয়ে বেশি ফিচার, আমরা মূলত পাশে রাখছি। সেটি ভুল বলে নয়। ফিচার বলতে যদি এমন যেকোনো ধরন বোঝায় যা মানুষের কাছে গুরুত্বপূর্ণ, আজকের সর্বাধুনিক মডেলগুলো সাধারণত শব্দটি যেভাবে ব্যবহার করে, তাহলে আমাদের কাম্য সব জগতেই মাত্রার চেয়ে ফিচারের সংখ্যা বেশি হবে; সবচেয়ে ভালো জগতটিতেও। সংযোজনের সুবাদেই তা হয়, এবং সেটা সুখবর। এই সমস্যার ‘সমাধান’ করতে গেলে প্রতিটি ঘটনার একটি ডেটাবেসের মতো কিছু বানাতে হবে। তেমন একটি জিনিস আমাদের আছেই: ডেটাসেট। আমরা চাই আরও ভালো বিমূর্ত ধারণা, নির্মাণ-উপাদানের অনেক ছোট একটি সেট, যা দিয়ে ডেটাসেটকে পরিষ্কারভাবে বোঝা যায়। আমাদের ধারণা, নেটওয়ার্কের নিজস্ব প্রক্রিয়াগুলো ইতিমধ্যেই এর কাছাকাছি। নিউরাল নেটওয়ার্কে উচ্চ-নিম্ন কম্পাঙ্ক শনাক্তকারী খুঁজে পাওয়ার আগে কেউ দৃষ্টিকে এভাবে ভাবেনি। সেগুলো আবিষ্কার করে আমাদের নিজেদের চিন্তার সরঞ্জামও উন্নত হয়েছে।
এতটা খুলে বলছি, কারণ শুরুতেই সবচেয়ে বেশি এই আপত্তিটিই আসে, বিশেষ করে এজেন্টদের কাছ থেকে। আর যে পাল্টাপাল্টি কথাবার্তায় সাধারণত ব্যাপারটি মিটে যায়, একটি গবেষণাপত্রে তার সুযোগ থাকে না।
শব্দটির আরও কয়েকটি ব্যবহার আমি নিয়মিত দেখি। যত দূর বুঝি, শুরুতে ‘সুপারপজিশন’ বলতে ভেক্টর যোগ করার চেয়ে বেশি কিছু বোঝাত না। পরে এটি একটি সার্কিটের গঠনধারার নাম হলো। কখনো আবার এর অর্থ হয়, নিউরনগুলো অর্থপূর্ণভাবেই সংযোজিত হলেও আমাদের আগ্রহের কোনো বিষয় বোঝার জন্য এত বেশি কার্যপ্রক্রিয়া অনুসরণ করতে হয় যে কাজটা সহজ থাকে না। Golden Gate Bridge-সংক্রান্ত কোনো গণনা আটটি বোধগম্য নিউরন নিয়ে হলে তাকে সাধারণ সংযোজন বলা হতে পারে, আর তিন হাজার নিউরন জড়ালে সেটাই হয়ে যায় সুপারপজিশনের সমস্যা। এখানে অসুবিধাটি হলো ছড়িয়ে থাকা গণনাটি আমরা বুঝতে পারব কি না। উদ্বেগটি বাস্তব, কিন্তু সম্পর্কহীন জিনিস ইচ্ছেমতো একসঙ্গে গুঁজে রাখা হয়েছে কি না, সে প্রশ্ন থেকে এটি আলাদা।
আমরা শব্দটি একেবারেই ব্যবহার না করার কথাও ভেবেছিলাম। গবেষণাপত্র আর এজেন্টরা পাঁচ-ছয় রকম অর্থে এটি ব্যবহার করে, যার অনেকগুলোই Zoom In-এর অর্থ থেকে অনেক দূরে। নিজেদের একটি শব্দ বানানোর কথাও ভেবেছিলাম। কিন্তু এখানে ইতিমধ্যেই বেশ কয়েকটি নতুন শব্দ চালু করেছি। তা ছাড়া, যে গবেষণাক্ষেত্রটি আমাদের মতে সঠিক প্রশ্ন তুলেছিল, তার সঙ্গে আলোচনায় অংশ না নেওয়ার মতো শোনাত ব্যাপারটি। তাই প্রচলিত শব্দটিই ব্যবহার করছি, মূল অর্থের সবচেয়ে কাছাকাছি অর্থে। আর এর সঙ্গে জড়িয়ে যাওয়া অন্য প্রশ্নগুলো আলাদা করার চেষ্টা করছি।
শেষে আরেকটি কথা। অনেকে, এবং আশ্চর্যজনকভাবে প্রায়ই সর্বাধুনিক এজেন্টরা, রেসিডুয়াল স্ট্রিমকে ‘স্বভাবতই’ সুপারপজিশনে থাকা বলে। যুক্তি হলো, এতে বিশেষ মর্যাদাপ্রাপ্ত কোনো নিউরন-ভিত্তি নেই। Toy Models-এর প্রায় আট মাস পরের অনানুষ্ঠানিক নোটটি এ নিয়ে বলেছে: যে উপস্থাপন কেবল নিউরন-ভিত্তি থেকে ঘুরিয়ে দেওয়া হয়েছে, তাকে সেখানে ছড়িয়ে থাকা উপস্থাপনের একটি ‘তুচ্ছ’ ধরন বলা হয়েছে, যা ‘মৌলিক জ্যামিতি বদলায় না’। কিন্তু নোটটি ছিল অনানুষ্ঠানিক, পড়েছেনও কম মানুষ। বিশেষ করে এজেন্টরা কথাটা গ্রহণ করেছে বলে মনে হয় না। একটি অবিচ্ছিন্ন পরিসর কীভাবে অধ্যয়ন করতে হবে, সেটি আরেকটি বাস্তব প্রশ্ন। তবে স্থাপত্যের এই বৈশিষ্ট্য একা বলে দেয় না, নেটওয়ার্ক কীভাবে এর ভেতরের গণনাগুলো সংগঠিত করতে শিখেছে।
শুরুতে আমাদের মনে হয়, নিউরাল নেটওয়ার্ককে ব্যাখ্যা করা কঠিন। আর প্রতিকার হিসেবে তৈরি হয় একটি সুনির্দিষ্ট অভিধান, যা আমরা অধ্যয়ন করতে পারি। এই দুই প্রান্তের মাঝখানে কী ভুল হয়েছে তার কয়েকটি আলাদা ছবি আছে: অতিরিক্ত ফিচার, ভুল ভিত্তি, ইচ্ছেমতো গুঁজে রাখা, কিংবা কেবলই অতিরিক্ত ছড়িয়ে থাকা গণনা। এগুলো একই সমস্যা নয়। পর্যবেক্ষণ উন্নত করলে বা মডেলের সাধারণীকরণ বুঝতে পারলে আপাত বিশৃঙ্খলার কিছুটা মিলিয়ে যায়। কিছু অসুবিধা থেকেই যায়, তবে সেগুলো বড় একটি সুসংগঠিত ব্যবস্থা কীভাবে অধ্যয়ন করব, সেই প্রশ্ন। ইচ্ছেমতো গুঁজে রাখা যদি মূল প্রক্রিয়াগুলো বুঝতে বাধা দেয়, তাহলে খরচ সত্ত্বেও ভিন্ন একক পুনর্গঠন করা সার্থক হতে পারে। কিন্তু প্রক্রিয়াগুলো যদি আগে থেকেই অর্থপূর্ণভাবে সংগঠিত থাকে, সেগুলো বদলে দিলে এমন সাধারণীকরণও ভেঙে যেতে পারে, যা আমরা এখনো বুঝিনি। একটি অভিধান নেটওয়ার্ককে দেখার উপযোগী উপায় হতে পারে, তার প্রক্রিয়াগুলোর অপরিহার্য বিকল্প না হয়েও। নেটওয়ার্ক পুনর্গঠনের খরচ মেনে নেওয়ার আগে আমি বুঝতে চাই, যে নেটওয়ার্ক আমাদের হাতে আছেই, সেটিকে অধ্যয়ন করতে বাধাটা কোথায়।
মেটা-মডেলের সঙ্গে সম্পর্ক
নতুন একগুচ্ছ পদ্ধতি আসছে, যেগুলো আসলে মোটেই প্রক্রিয়াভিত্তিক নয়: মেটা-মডেল। অর্থাৎ এমন মডেল, যাদের অন্য মডেলের সক্রিয়তার মান পড়ে আমাদের সে সম্পর্কে জানাতে প্রশিক্ষণ দেওয়া হয়। আর হয়তো সেটা ভালোই। হয়তো প্রক্রিয়াগত ব্যাখ্যাযোগ্যতা গাছ দেখতে গিয়ে কিছুটা বনটাই হারিয়ে ফেলছে। নিউরন নিয়ে গবেষণাপত্র, অভিধান কিংবা প্রোবের চেয়ে মেটা-মডেল ভালো পদ্ধতিও হতে পারে।
আমার সন্দেহ, সেটা সত্যি হলেও দুই পদ্ধতি একসঙ্গে চলতে পারে। মেটা-মডেল হতে পারে Google Maps-এর সবচেয়ে ওপর থেকে দেখা দৃশ্যের মতো। তারপর তার প্রতিটি দিকনির্দেশ কোন প্রক্রিয়া ব্যবহার করছে, আর সেগুলো কীভাবে সার্কিটে যুক্ত হচ্ছে, তা যাচাই করা যাবে।
আকার বাড়লে সুপারপজিশনের সুবিধা, না অসুবিধা?
আমরা যে ইমেজ মডেলগুলো অধ্যয়ন করেছি, সেগুলোতে সুপারপজিশন নেই বলে আমরা বেশ আত্মবিশ্বাসী। স্বাভাবিক পরের প্রশ্ন: এক ট্রিলিয়ন প্যারামিটারের মডেলে কি থাকতে পারে? এখানে আসলে দুটি প্রশ্ন আছে।
প্রথমটি হলো, সুপারপজিশন দিয়ে মূলত কী ব্যাখ্যা করার প্রস্তাব দেওয়া হয়েছিল। ব্যাখ্যা আসে কোনো সমস্যার জন্য। সুপারপজিশন প্রস্তাব করা হয়েছিল InceptionV1-কে কেন এলোমেলো দেখায়, তা বোঝাতে। দেখা গেল, ব্যাখ্যাটি ভুল ছিল। নতুন প্রস্তাব হতে পারে, কোনো ট্রিলিয়ন-প্যারামিটার মডেলকে এলোমেলো দেখানোর কারণ সুপারপজিশন। কিন্তু আমাদের মনে হয় না প্রমাণ সেদিকে ঝুঁকছে: বড় ভাষা মডেলকে যত কাছ থেকে দেখি, তাদের নিউরন তত পরিষ্কার হয়ে ওঠে।
দ্বিতীয়টি সরাসরি বাস্তব প্রশ্ন: এখন পর্যন্ত কোনো আকারে না দেখা গেলেও কি প্রতিবার আরও বড় মডেলে সুপারপজিশন দেখা দিতে পারে? হয়তো প্রতিটি বড় লাফের পর সবকিছু নতুন করে বিচার করতে হয়। তবে সেটাও পুরোপুরি ঠিক বলে মনে হয় না। আমাদের অনুমানটি বিকাশ নিয়ে। সার্কিট শক্তিশালী হওয়ার সঙ্গে সঙ্গে কোনো জিনিসকে পুরোপুরি সম্পর্কহীন জায়গায় রাখার তাগিদ কমে। কারণ সেই জিনিসের, অথবা তার সবচেয়ে কাছের জিনিসটির, জন্য আগে থেকেই তৈরি উপযুক্ত আশ্রয়ের টান বেড়েছে। Anthropic-এর SGTM গবেষণার সঙ্গে এটি মেলে; সেখানে দেখা গেছে, জ্ঞান আরও নির্দিষ্ট স্থানে কেন্দ্রীভূত হয়। আমাদের সন্দেহ, সাধারণভাবেও তা সত্যি। আমাদের কাছে প্রমাণ নেই। তবে বিষয়টি ভাবার একটি উপায় হলো, সার্কিটের একধরনের অর্থগত মাধ্যাকর্ষণ আছে। কোনো জিনিসকে অস্পষ্ট উচ্চমাত্রিক জায়গায় পাঠিয়ে ইচ্ছেমতো গুঁজে রাখতে হলে সেই আকর্ষণের বিরুদ্ধে লড়তে হয়। আকর্ষণ যত শক্তিশালী, লড়াইটাও তত কঠিন।
প্রক্রিয়াটি ‘সার্কিটের বাস্তুতন্ত্র নিয়ে আরও কিছু কথা’ অংশে বর্ণিত প্রক্রিয়াই। শুরুতে সম্পর্কিত জিনিসের সংযোজনের ওপর ভর করে নতুন জিনিস গড়ে ওঠে। এমন কোনো বিশেষ ঘটনা, যার ওপর ভিত্তি করে আর কিছু গড়ার দরকার নেই, যেমন ছাতার উদাহরণটি, সাধারণ কার্যপ্রক্রিয়াগুলোর মধ্যে একটি অপ্রচলিত পথ হিসেবে তৈরি হয়। কোথাও অজানা কোণে লুকানো ফিচারের দরকার পড়ে না। একটি নিউরনের মতো এক জায়গায় সংহত হওয়ার ব্যাপারটি মডেলের আচরণ ঘোরানোর চেয়ে ভবিষ্যতে তার ওপর কিছু গড়ে তোলার সুবিধার সঙ্গে বেশি সম্পর্কিত বলে মনে হয়: তাকে সহজে খুঁজে পেতে হবে, তার ওপর সহজে নতুন কিছু গড়তে হবে, আর সেখান থেকে নতুন একটি উপযুক্ত আশ্রয় তৈরি করা সহজ হতে হবে। গোড়া থেকে নেটওয়ার্কের শেখা দেখলে দেখা যায়, গাড়ি নিয়ে প্রশিক্ষিত, গাড়িবিশেষজ্ঞ থাকা নেটওয়ার্কে গাড়ির নিউরন গড়ে ওঠার আগেই সেটি ভালোভাবে গাড়ি চেনে। ওই পর্যায়ে কাজটি কেবল আরও ছড়িয়ে থাকে। মনে হয়, পরের দিকের বিশেষজ্ঞগুলো যাতে সুরক্ষিত জায়গায় গড়ে উঠতে পারে, সে জন্যই কাজটি এক জায়গায় সংহত হয়; অনেকটা একটি শেলিং বিন্দুর মতো, যেখানে সমন্বয় স্বাভাবিকভাবেই এসে মেলে।
তাই সুপারপজিশনের ব্যাখ্যাকে বলতে হবে, এই দুই কাজের কোনটির জন্য ইচ্ছেমতো গুঁজে রাখা হচ্ছে। মডেলের আচরণের দিক বদলানোর জন্য হলে আমাদের ধারণা, বাকি থেকে যাওয়া ত্রুটি ধরার উপযোগী করে আগে থেকেই গড়া সাধারণ পথগুলো সেখানে আগে পৌঁছে যায়। গুঁজে রাখা সার্কিটটি তখন গ্রেডিয়েন্টের অভাবে পড়ে। আর নতুন কিছু গড়ার ভিত্তি হিসেবে হলে সমস্যা অন্য: নতুন আশ্রয় গড়ার সবচেয়ে খারাপ জায়গা হলো এমন এক ছায়াচ্ছন্ন অঞ্চল, যা কেউ ব্যবহার করে না, অথচ সেখানে যা আছে তার সঙ্গে এরই মধ্যে বাধাবিপত্তি তৈরি হচ্ছে। গাড়ির কাছাকাছি যা আছে, তার পাশেই যখন নতুন কিছু গড়া যায়, তখন নেটওয়ার্কের লাতিন কবিতার মাঝখানে দ্বিতীয় একটি গাড়ির এলাকা শুরু করা ভালো বুদ্ধি নয়।
প্রায়ই ধরে নেওয়া হয়, বিরল তথ্যের দীর্ঘ লেজের অংশেই সুপারপজিশনের সম্ভাবনা সবচেয়ে বেশি। কারণ বিরল জিনিসের সংঘর্ষও কম হয়। আমাদের ধারণা, সেখানেই এর সম্ভাবনা সবচেয়ে কম হওয়ার কথা। একটি বিরল তথ্য লসের মান খুব সামান্যই বদলায়, তাই নিজের আলাদা আশ্রয় টিকিয়ে রাখার সামর্থ্য তার নেই। সে যা পারে তা হলো, সম্পর্কিত সার্কিটগুলোর মধ্যে ছোট একটি পথ হয়ে আগে থেকে থাকা কার্যপ্রক্রিয়ার ওপর ভর করে চলা। যেমন ছাতা থেকে ‘bee’-তে যাওয়ার শাখাপথটি টিকে থাকে কেবল ছাতা ও মৌমাছির সার্কিট আগে থেকেই আছে বলে। ওই সার্কিটগুলো তাকে শক্তি জোগায়, সম্পর্কহীন গ্রেডিয়েন্ট থেকে আড়ালও করে। পূর্বানুমানটি পরীক্ষা করা যায়: বিরল তথ্যটি বহনকারী নিউরন ও হেডগুলো সেই তথ্যের বিষয়বস্তুর সঙ্গে সম্পর্কিত হওয়ার কথা; নিছক সংঘর্ষ কম হয় বলে বেছে নেওয়া সম্পর্কহীন নিউরন ও হেড হওয়ার কথা নয়।
আমরা বিষয়টি আরও বেশি বাস্তুসংস্থানের মতো করে ভাবি। বিভিন্ন পর্যায়ে যে আগে বাকি থাকা ত্রুটি ধরতে পারে, সে-ই জেতে। সাধারণত জেতে ওই জিনিসের জন্য উপযুক্ত অঞ্চলটিই। আমাদের অনুমান, প্রশিক্ষণ এগোনোর সঙ্গে এবং আরও সক্ষম মডেলে এই প্রবণতা জোরদার হয়। কারণ প্রশিক্ষণকে উন্নত করে এমন প্রায় সবকিছুই আরও সুসংগঠিত আশ্রয় গড়তে উৎসাহ দেয়।
এ নিয়ে আমরা মোটেই নিশ্চিত নই। এখন পর্যন্ত যা পেয়েছি, শুধু সেটুকু গুছিয়ে বলতেও অন্তত আরেকটি গবেষণাপত্র লাগবে। পুরো ঘটনার সম্ভবত ছোট একটি অংশ এটি। কিন্তু এ কারণেই আমাদের মনে হয়, পরের বড় আকারে গিয়েও সুপারপজিশন দেখা দেবে না। শুধু এখনো সেখানে দেখিনি বলার চেয়ে এটি শক্তিশালী কারণ। পুরোনো চিন্তাটি ছিল তথ্য জমা রাখা নিয়ে: এত ফিচারের জন্য এত মাত্রা। এখন আমরা বেশি ভাবি সার্কিটের দৌড়, গ্রেডিয়েন্টের অনাহার আর বাস্তুসংস্থান দিয়ে। অর্থাৎ তথ্য রাখার সামর্থ্যের চেয়ে শেখার গতি নিয়ে বেশি ভাবি। পুরোটা আমরা এখনো বুঝে উঠিনি, তবে আপাতত আমাদের চিন্তা এই পর্যন্তই এসেছে।
শিরোনাম নিয়ে
আমরা প্রতিটি নিউরাল নেটওয়ার্কের পূর্ণাঙ্গ নিরীক্ষা করিনি। তাত্ত্বিকভাবেও তা সম্ভব কি না, জানি না। ‘নিউরাল নেটওয়ার্ক আমাদের ধারণার চেয়ে বেশি পরিষ্কার’ ধরনের একটু নরম শিরোনামের কথা ভেবেছিলাম। কিন্তু আমাদের যা সত্যি বলে মনে হয়, সেটিকে এই শিরোনাম যথেষ্ট জোর দিয়ে বলে না।
‘আমাদের ধারণার চেয়ে বেশি পরিষ্কার’ কথাটির সমস্যা হলো, এটি পরিমাণের পরিবর্তন বোঝায়। অথচ আমার ভাবনায় পরিবর্তনটি ঘটেছে ধরনের দিক থেকে। ওই কথায় আগের ছবিটিই থেকে যায়, শুধু সুপারপজিশন লুকিয়ে থাকার ফাঁক ক্রমেই ছোট হতে থাকে। আমার যা বদলেছে তা হলো, আদৌ কোন ধরনের প্রক্রিয়া এই কার্যপ্রণালিগুলো তৈরি করে, সে সম্পর্কে ধারণা। অনেকটা বুদ্ধিমান নকশাকার দিয়ে জীবজগৎ ব্যাখ্যা করা থেকে প্রাকৃতিক নির্বাচনের ব্যাখ্যায় যাওয়ার মতো। উপমাটির মিল শুধু এই পর্যন্ত: একই প্রাণীদের দেখার দুটি ভিন্ন উপায় আছে। নতুন উপলব্ধিটি এমন নয় যে, আরও বেশি প্রাণী বিবর্তিত হয়েছে বলে দেখা যাচ্ছে; বরং বুঝতে পারা যে, সবগুলোকে কী তৈরি করেছে, সেটিই ভুল বুঝেছিলাম। আমরা নিশ্চিত নই। হয়তো 85% নিশ্চিত। কিন্তু তার মানে, প্রায় সবকিছুই দ্বিতীয় ধরনের প্রক্রিয়া থেকে এসেছে বলে 85% নিশ্চিত। 85% কার্যপ্রণালি সেভাবে এসেছে বলে ভাবা থেকে এটি একেবারেই আলাদা। তাই ‘আমাদের ধারণার চেয়ে বেশি পরিষ্কার’ বললে আমাদের বিশ্বাসটি ভুলভাবে প্রকাশ পাবে। আমাদের প্রমাণ নেই, তবে এখানে কোনো কিছু ওই অর্থে প্রমাণযোগ্য বলেও আমার মনে হয় না। আছে শুধু ভালো আর মন্দ ব্যাখ্যা। আপাতত আমাদের মনে হচ্ছে এটিই ভালো ব্যাখ্যা।
‘আমাদের ধারণার চেয়ে বেশি পরিষ্কার’ বললে আরেকটি ভুলও হতো। শুনে মনে হয়, পরিষ্কার-পরিচ্ছন্নতার কোনো স্কোর অনেক উঁচু বলে আত্মবিশ্বাসের সঙ্গে দাবি করছি। অথচ এই দিকটি নিয়েই আমরা সবচেয়ে কম নিশ্চিত। পুনরাবৃত্ত সাধারণীকরণের পরিমাণ আমরা কম করে ধরে থাকতে পারি, ফলে ওই ধরনের স্কোর নেমে আসাই যুক্তিসংগত হতে পারে। গোড়া থেকেই আমাদের মনে হয় না এসব স্কোর খুব গুরুত্বপূর্ণ। এই নতুন উপলব্ধির ফলে একার্থকতা নিয়ে আমাদের মাথাব্যথা কমেছে। কারণ আমরা অনুসরণ করতে পারি জিনিসগুলো কীভাবে বেড়েছে, আর পাশের বিস্তারগুলোকে উপশাখা হিসেবে দেখতে পারি। বহুঅর্থকতা কতটা আছে তার চেয়ে কেন আছে, সেটি অনেক বেশি গুরুত্বপূর্ণ। স্কোর সম্ভবত বেশ উঁচুই, তবে কমও হতে পারে। আমরা তুলনামূলকভাবে বেশি আত্মবিশ্বাসী, নিউরাল নেটওয়ার্ক আসলে কেমন ধরনের জিনিস এবং কীভাবে বেড়ে ওঠে, তা নিয়ে।
নিউরাল নেটওয়ার্ক কেমন জিনিস, সে সম্পর্কে প্রচলিত ধারণাটি ভুল ছিল বলে আমাদের মনে হয়। ছোট জায়গায় আঁটানোর জন্য এটি মোটামুটি ইচ্ছেমতো জিনিস ঠাসাঠাসি করে রাখে না। এটি সত্যিই শেখে। রেইনফরেস্ট যে অর্থে পরিষ্কার, সেই অর্থে এটিও পরিষ্কার: সেখানকার প্রায় প্রতিটি প্রাণীর গঠন ও আচরণের যুক্তি আছে। বাঘের রং উজ্জ্বল কমলা হওয়া খামখেয়ালি কিছু নয়; হরিণ কমলা আর সবুজ আলাদা করতে পারে না, আর স্তন্যপায়ীর জন্য সবুজ লোম তৈরি করা অনেক কঠিন। এটা জানলে আরও অনেক প্রাণীর ব্যাপারও পরিষ্কার হয়। এই ব্যাখ্যা অনেক দূর পর্যন্ত কাজে লাগে। নেটওয়ার্কেও এমন ব্যাখ্যা যেখানে ভেঙে পড়ে, তেমন কোনো জায়গা আমরা পাইনি।
‘পরিষ্কার’ শব্দটি এমনভাবে পড়া যায়, যা শুনে আর না ভেবেই কেউ শিরোনামে মাথা নাড়বেন: প্রতিটি প্রক্রিয়া আমাদের আগে থেকেই জানা কোনো ধারণার সঙ্গে মিলে যায়। আমরা সেটি বোঝাচ্ছি না। সত্যি হলে তা ভীষণ খারাপ খবর হতো। আমার তো মনে হয় না সেভাবে কাজই হতো। মানুষ ভাষা মডেল কীভাবে তৈরি করতে হয় তা জানে না; এমনকি দৃষ্টি নিয়ে এমন ভালোভাবে ভাবতেও জানে না, যাতে উচ্চ-নিম্ন কম্পাঙ্ক শনাক্তকারী খুঁজে পাওয়ার আগেই সেগুলোর অস্তিত্ব আঁচ করতে পারত। নেটওয়ার্কের ধারণাগুলো প্রায়ই আমাদের ধারণার চেয়ে ভালো। সে যা গড়ে তোলে, তা আমাদের পূর্বধারণার চেয়ে বেশি সুন্দর।
তাই শিরোনামটি দুই দিক থেকেই অসম্পূর্ণ। প্রমাণের জোরকে বাড়িয়ে বলছে, কারণ সবকিছুর নিরীক্ষা আমরা করিনি। আবার কমিয়েও বলছে, কারণ আমরা যে জগতে আছি বলে মনে করি, তা প্রতিটি নিউরনের সঙ্গে মানুষের দেওয়া একটি নাম মিলে যাওয়ার চেয়েও ভালো: মনে হচ্ছে নেটওয়ার্ক সত্যিই শেখে, অর্থপূর্ণভাবে একসঙ্গে কাজ করে এমন বিমূর্ত ধারণার একটি বাস্তুসংস্থান গড়ে তোলে। এই ছবিটি সত্যি কি না, আমরা জানি না। এটিই আমাদের প্রধান অনুমান। কিন্তু সত্যি হলে, নেটওয়ার্ক কেবল আমাদের প্রত্যাশা মেটাচ্ছে, তার চেয়ে এটি অনেক ভালো খবর।
জোড়া-লাগা ফিচারের সঙ্গে সম্পর্ক
আরও ভালো সরঞ্জাম নিয়ে InceptionV1-এর শেষ স্তরে ফিরে তাকাতে গিয়ে আমি পুনরাবৃত্ত সাধারণীকরণ খুঁজে পাই। সেখানে এটিকে অদ্ভুত অতিবৃদ্ধির মতো দেখাচ্ছিল। মডেলটিকে নতুন করে প্রশিক্ষণ দিলাম, সবচেয়ে এলোমেলো নিউরনটি খুঁজে বের করলাম, আর দেখলাম সেটি কীভাবে বেড়েছে। দেখলাম, বারবার একইভাবে বেড়ে ওঠার একটি ধরন, যা তখনো সাধারণীকরণই: নিউরন থেকে শাখা বেরোচ্ছে, আর সেই শাখা থেকে আবার শাখা। পুনরাবৃত্ত সাধারণীকরণ নামটিই স্বাভাবিক মনে হলো।
এটি প্রকাশের কিছু আগে, ব্যাখ্যাযোগ্যতার বিখ্যাত মডেলগুলো আবার খুঁটিয়ে দেখছিলাম, সেগুলো কতটা একার্থক তা মাপার চেষ্টা করছিলাম। তখন Multimodal Neurons[3]-এ CLIP নিয়ে আমাদের কাজটি চোখে পড়ল। সেখানে খুবই কাছাকাছি একটি বিষয় বর্ণনা করা হয়েছে, নাম দেওয়া হয়েছিল জোড়া-লাগা নিউরন (conjoined neurons): কিছু ধারণা, যেগুলো একটি বৈশিষ্ট্যের জায়গায় মিলে যায়, তারপর ‘একাধিক দিকে সাধারণীকরণ করে ছড়িয়ে পড়ে’। নিউরনগুলো দেখার কথা আমার মনে আছে, কিন্তু তখন খুব গুরুত্ব দিইনি। পরে ভুলেও গিয়েছিলাম। ফিরে তাকিয়ে মনে হয়, গবেষণাপত্রটি আগেভাগেই গুরুত্বপূর্ণ কিছু দেখেছিল। তার জন্য অনেক কৃতিত্ব প্রাপ্য।
তার পরও আমরা ভিন্ন নাম বেছে নিয়েছি। automated interpretability নামটি আমারই দেওয়া। কিছুটা আফসোসও হয়: জিনিসটি যত জটিল, তার তুলনায় নামটি অতিরিক্ত সরল ছিল। অনেক জটিলতাই তাতে ধরা পড়েনি। আবার সেই ভুল করতে চাই না। conjoined features-এর ক্ষেত্রে আমার মনে হয় না শব্দ দুটির কোনোটিই পুরোপুরি ঠিক। ‘Conjoined’ শুনলে মনে হয় দুটি জিনিস এক জায়গায় জুড়েছে। অথচ আমরা যা দেখি তার কয়েকটি স্তর আছে: শাখা, আবার সেই শাখার শাখা। সবচেয়ে আকর্ষণীয় দিকটিও নামটিতে নেই। গবেষণাপত্রের নিজের বর্ণনায়, একটি অভিন্ন বৈশিষ্ট্য থেকে ধারণাগুলোর সাধারণীকরণ করে ছড়ানোর কথাতেই ইঙ্গিত আছে যে এটি সাধারণীকরণ। কিন্তু নামটি সেই অর্থ বহন করে না।
‘Features’ আরও কঠিন। Zoom In-এর এক বছর পর গবেষণাপত্রটি লেখা হয়েছিল। তখনো অনুমান করা হতো, ফিচারই নিউরাল নেটওয়ার্কের মৌলিক একক। এর পর থেকে শব্দটির অর্থ অনেক শিথিল হয়েছে। ভিন্ন মানুষ ও গবেষণাপত্র এটি বেশ ভিন্ন অর্থে ব্যবহার করে। এই প্রবন্ধে আমরা নিউরাল নেটওয়ার্ককে ফিচার দিয়ে তৈরি বলে ভাবার বিরুদ্ধে যুক্তি দিচ্ছি। আর এই গঠনধারাটি হলো সময়ের সঙ্গে নিউরন কীভাবে বাড়ে, তা নিয়ে। যে শব্দকে মৌলিক উপাদান হিসেবে ব্যবহার করারই বিরোধিতা করছি, ঠিক সেই শব্দ দিয়ে ব্যাপারটি পরিচয় করানোর ভালো উপায় হয়তো নেই। ফিচারকে আগে রাখার দৃষ্টিভঙ্গিতে এগুলোকে একটির ভেতরে আরেকটি থাকা ফিচার, অথবা জোড়া-লাগা ফিচার ভাবা যুক্তিসংগত। এখানে আমরা যে প্রক্রিয়াকে আগে রাখার দৃষ্টিভঙ্গি নিয়েছি, সেখান থেকে ফিচার দিয়ে ভাবা ঠিক উপায় নয়। তবে গবেষণাপত্রটি সঠিক বিষয়ের দিকেই আঙুল তুলেছিল, আর সেই কৃতিত্ব আমি দিতে চাই। আমার মতে আরও নির্ভুল একটি নাম ব্যবহার করেও সেই কৃতিত্ব দেওয়ার চেষ্টাই এই অংশ।
এখন আমরা আরও বেশিও জানি। তখন আমাদের হাতে ছিল শুধু প্রশিক্ষণ-শেষের মডেল। বড় নেটওয়ার্ক বেড়ে উঠতে আমাদের কেউ দেখিনি। তাই গবেষণাপত্রটি প্রশ্ন তুলেছিল, জোড়া-লাগা ফিচারগুলো প্রশিক্ষণের গোড়ার দিক থেকে থেকে যাওয়া অবশেষ কি না। এখন প্রশিক্ষণ দেখে সেগুলোকে অবশেষ মনে হয় না: শাখা বাড়তেই থাকে, যদিও কতটা বাড়বে তা পরিস্থিতির ওপর নির্ভর করে। গবেষণাপত্রের একটি উপ-অংশে যতটা করা সম্ভব ছিল, আমরা তার চেয়ে অনেক বেশি কাজ করেছি। তার পরও পুরোটা বুঝেছি বলে মনে হয় না। গবেষণাপত্রটি এটিকে বহুঅর্থকতার সম্ভাব্য নতুন ব্যাখ্যা হিসেবে হাজির করেছিল। এখন আমাদের বিশ্বাস, পর্যবেক্ষণের সরঞ্জাম, স্থাপত্য আর আকারের প্রভাব হিসাব করার পর নিউরনের যে বহুঅর্থকতা বাকি থাকে, তার বেশির ভাগই এটি; কোনো ছোট বিশেষ ধরনমাত্র নয়।
পুনরাবৃত্ত সাধারণীকরণ নিয়ে আমরা কেন উদ্বিগ্ন নই
আপাতত পুনরাবৃত্ত সাধারণীকরণ নিয়ে বিশেষ উদ্বিগ্ন না হওয়ার কয়েকটি কারণ আছে। প্রথমত, নিউরনের মূল কাজের তুলনায় উপশাখাগুলো বিরলও বেশি, কার্যকারণগত গুরুত্বও অনেক কম বলে মনে হয়। এদের ঘুমিয়ে থাকা গুপ্তচরের মতো দেখায় না, যে কদাচিৎ সক্রিয় হয়, কিন্তু হলে বিরাট কিছু করে। বরং মনে হয়, কাছাকাছি যা ছিল, আর সহজে যেটা আঁকড়ে ধরা গেছে, সেটাই। হয়তো গুরুত্ব কম বলেই এগুলো তৈরি হতে পেরেছে, কারণ গুরুত্বপূর্ণ কোনো পাশের বিস্তার আরও বেশি নয়েজ যোগ করত। আমাদের সন্দেহ, কোনো চাপ শাখাগুলোকে অতিরিক্ত বেড়ে যেতে বাধা দেয়। সেটি কী, আমরা জানি না। তবে থাকলে বোঝা যায়, উপশাখাগুলোর গুরুত্ব কম কেন, একটি নিউরন দশটি সম্পর্কহীন জিনিস শেখে না কেন, আর সত্যিকার বিড়াল-ও-গাড়ির নিউরনের মতো কিছু তৈরি হয় না কেন। তা হলে স্বাভাবিক টানটি ঠিক একার্থকতার দিকে নয়, বরং আমাদের মতে একার্থকতা যে বিষয়টির ইঙ্গিত করছিল তার দিকে: প্রতিটি নিউরনের একটি সামগ্রিক কাজ থাকা।
দ্বিতীয়ত, আমাদের ভাবা উচিত কোনো কিছু কেন আছে এবং কী করে, তা ব্যাখ্যা করা যায় কি না। আর সুপারপজিশনের তুলনায় পুনরাবৃত্ত সাধারণীকরণ ব্যাখ্যা করা অনেক সহজ। পুরো নেটওয়ার্কে কোন জিনিস কোনটির সঙ্গে ঘটে তার পরিসংখ্যানের কারণে কোনো কিছু নিউরনে গুঁজে রাখা হলে সেটির পূর্বানুমান করতে মূলত সব পরিসংখ্যান হাতে নিয়ে নিজেকেই গ্রেডিয়েন্ট ডিসেন্ট চালাতে হবে। শাখার ক্ষেত্রে ব্যাপারটি আলাদা। সেটির বেড়ে ওঠা যদি দেখেন, আর কী করছে তা জানেন, তাহলে তার উপশাখা ও সেগুলোর কাজের পূর্বানুমান তুলনামূলক সহজ; প্রশিক্ষণের সময়েও, প্রশিক্ষণ-শেষের নেটওয়ার্কেও।
তৃতীয়ত, একটি নিউরনের সবচেয়ে জোরালো kটি উদাহরণের কতগুলো একটি নামের সঙ্গে মেলে, তা গোনা শুরুর জন্য যুক্তিসংগত। কিন্তু এতে সুপারপজিশন আর পুনরাবৃত্ত সাধারণীকরণ কাছাকাছি স্কোর পাবে। অথচ পুনরাবৃত্ত সাধারণীকরণের জগতে থাকা অনেক ভালো। আমাদের মনে হয়, এতে নিউরনের চেয়ে একার্থকতার চিন্তাকাঠামো, অথবা পরিষ্কার-পরিচ্ছন্নতা মাপার যেকোনো একক স্কোরের সীমাবদ্ধতাই বেশি ধরা পড়ে। তবে পুনরাবৃত্ত সাধারণীকরণও আদর্শ নয়। সহজ সমাধান পাওয়া গেলে স্বাগত। উপশাখাগুলোর গুরুত্ব কম বলে মনে হয় বলেই আমাদের ধারণা, তেমন সমাধান সম্ভবও হতে পারে।
পুনরাবৃত্ত সাধারণীকরণের ব্যাখ্যা কি সহজে বদলানো যায়?
প্রবল বহুঅর্থকতার প্রতিটি ঘটনাই পুনরাবৃত্ত সাধারণীকরণ, তা আমরা পুঙ্খানুপুঙ্খভাবে দেখাইনি। এখানে সেটি আমাদের লক্ষ্যও ছিল না। আমরা এখন কী ভাবছি, সেটাই বলতে চেয়েছি। বহু নিউরনকে বেড়ে উঠতে দেখেছি। এখন পর্যন্ত প্রতিবারই এটাই দেখেছি: শাখাগুলো তৈরি হতে দেখা যায়। প্রশিক্ষণ-শেষের মডেলে শুরুর চিহ্ন হারিয়ে যেতে পারে। আর বিশাল ভাষা মডেলের মতো কিছুর ক্ষেত্রে ঘটনাটি দেখার জন্য আমাদের কাছে প্রশিক্ষণের মধ্যবর্তী সংরক্ষিত সংস্করণও নেই। পুরো মডেলজুড়ে কঠোরভাবে পরীক্ষা করা এই মুহূর্তে আমাদের অগ্রাধিকার নয়, তবে কাজটি খুব কঠিন হবে বলেও মনে হয় না।
যা দেখাতে চাই তা হলো, দুটি ব্যাখ্যাকে ইচ্ছেমতো পাল্টানো কতটা কঠিন, সেই বিচারে তারা কত আলাদা। অর্থাৎ পূর্বানুমান না বদলে ব্যাখ্যার খুঁটিনাটি কতটা বদলানো যায়। সুপারপজিশন মূলত বলে বিশৃঙ্খলা থাকবে: সংজ্ঞায়িত করা কঠিন এমন ফিচার সম্পর্কহীন জায়গায় রাখা হবে। সরল পরীক্ষামূলক মডেলে ফিচার আগে থেকে দেওয়া থাকে, তাই সেটি মাপা যায়। যদিও আমাদের মতে তারও নিজস্ব সমস্যা আছে। বাস্তব নেটওয়ার্কে দাবিটি ঠিক কী, তা ধরাই কঠিন; পরীক্ষা করা তো পরের কথা। পুনরাবৃত্ত সাধারণীকরণ অনেক বেশি সুনির্দিষ্ট পূর্বানুমান দেয়। একটি শাখা ভালোভাবে দৃশ্যায়িত করতে পারলে, তার সবকিছুকে অত্যন্ত উচ্চমাত্রিক অর্থগত পরিসরে একই স্থানীয় উৎসে ফিরিয়ে নিয়ে যাওয়া যাবে। আর প্রশিক্ষণের সময় সেখান থেকে একটি নির্দিষ্ট ক্রমে সেটি বেড়ে ওঠার কথা। অর্থগত পরিসর ও সময়, দুদিকেই এটি একটি সুনির্দিষ্ট আকৃতি। নিছক কাকতালীয়ভাবে এমন সংকীর্ণ লক্ষ্যে আঘাত করা কঠিন।
আমাদের কাছে এমন বেশ কয়েকটি ঘটনা আছে, যেখানে শাখা গজানোর ব্যাখ্যাটি প্রায় নির্ণায়ক: ‘iy’ নিউরনের বেড়ে ‘diy’, ‘do it yourself’ এবং Miyazaki-তে পৌঁছানো; Multimodal Neurons[3]-এর কয়েকটি উদাহরণ; আর InceptionV1-এর সেই নিউরন, যেটিকে আমরা তৈরি হতে দেখেছি। যত দূর জানি, সুপারপজিশনের সুগঠিত আদর্শ সার্কিটের কোনো উদাহরণ আর বাকি নেই। প্রতিটি বহুঅর্থক নিউরন এভাবেই তৈরি হয়, আমরা তা মনে করি না। কারণ বহুঅর্থকতা নিউরনের যতটা সমস্যা, পর্যবেক্ষকেরও ততটাই। আমাদের ধারণা, নিউরন বাড়ার সময় সাধারণত এই ধরনেই বাড়ে। আর ভালোভাবে পর্যবেক্ষণ করার পর যা বাকি থাকে, তা সাধারণত এই ব্যাপারটি, অথবা SwiGLU-এর দ্বৈত-ঋণাত্মক অঞ্চলের মতো স্থাপত্যগত সমস্যা; নিশ্চয়ই আরও আছে, যা আমরা এখনো পাইনি। এটি সত্যিই নতুন দাবি কি না, সে বিষয়েও আমরা নিশ্চিত নই। এক অর্থে সাধারণীকরণ থেকে এমনটাই প্রত্যাশিত হওয়ার কথা। আমরা শুধু বলছি, সাধারণীকরণ সাধারণত একদিকে এগোয়, আর কখনো কখনো উপশাখা গজায়। এটিকে বিশেষ বৈপ্লবিক দাবি বলে আমাদের মনে হয় না। এখানে আমরা সেটি পুরোপুরি দেখাইনি। তবে আমাদের মনে হয়, সহজে পরীক্ষা করা যায় এমন তত্ত্বের উপযুক্ত আকৃতি এর আছে, যদিও এর সম্পূর্ণ পরিসর এখনো পরীক্ষা করিনি।
অ্যাটেনশন সুপারপজিশনের সঙ্গে সম্পর্ক
Anthropic অ্যাটেনশন সুপারপজিশন নিয়ে একটি ছোট নোট[27] প্রকাশ করেছে। কয়েকজন আমাদের সঙ্গে সেটি নিয়ে কথা বলেছেন। আমাদের মনে হয়, এখানে পরিভাষার সমস্যা থাকতে পারে। তারা কি দাবি করছে, অ্যাটেনশন সংযোজনের বিপরীত কোনোভাবে শেখে? আমরা জানি না। আমাদের সন্দেহ, এ বিচার করার মতো ভালোভাবে অ্যাটেনশন হেড এখনো কেউ বোঝে না। নিউরনের বেলাতেই আমাদের অনেক সময় লেগেছে। কী ধরনের গঠনধারা তৈরি হয় তা ভাবার উৎকৃষ্ট পদ্ধতি আর চমৎকার সরঞ্জাম হাতে না থাকলে, মোটামুটি ভালো সরঞ্জাম নিয়েও গাড়ি কুকুরের মধ্যে ঢুকে যাচ্ছে ধরনের ভুল খুব সহজেই হয়।
আমাদের মনে হয়, তারা বোঝাতে চেয়েছে যে উপযোগী জিনিসগুলো অ্যাটেনশন হেডের বিভিন্ন গোষ্ঠী ভাগ করে ব্যবহার করে। এতে আমরা একমত। এই বিভ্রান্তি এড়াতে সুপারপজিশন শব্দটি একেবারেই বাদ দেওয়ার কথাও ভেবেছিলাম। কিন্তু সব পরিভাষা নতুন করে নিজেদের মতো সংজ্ঞায়িত করে আগে হয়ে যাওয়া কাজ থেকে আলাদা হয়ে যাওয়াটাও ভালো বিনিময় মনে হয়নি। ‘ফিচার ও সংজ্ঞা নিয়ে কিছু কথা’ অংশে বিভিন্ন অর্থ নিয়ে আরও বলেছি।
একবারে একটি অ্যাটেনশন হেড অধ্যয়ন করা ভালো, না অনেকগুলো, সে বিষয়ে আমরা নিশ্চিত নই। একটি করে হেড নিয়ে শুরু করা যুক্তিসংগত: একটি স্তরের ভেতরে দুই-তিনটি হেড কোনো পথের বেশির ভাগ কাজ করে, যদিও পথটি কয়েকটি স্তর পেরিয়ে যায়। কিন্তু বিমূর্ততার সঠিক স্তর বুঝে ওঠার আগে নিউরনও বেশি এলোমেলো দেখাত। তাই এখনই রায় দেওয়া তাড়াহুড়ো হবে। হয়তো পুরো পথেই গোষ্ঠী ধরে দেখতে হবে। ফিচারাইজার নিয়ে যারা কাজ করছেন, সবার সাফল্য কামনা করি। আমরাও সম্ভবত চেষ্টা করব। আমাদের ঝোঁক বেশি গতিশীলভাবে গোষ্ঠী তৈরির দিকে: যেমন একটি অবদান-মানচিত্রের ভেতরে, অথবা কয়েকটির গোষ্ঠীর ভেতরে স্থানীয়ভাবে গুচ্ছ তৈরি করা; পুরো ব্যবস্থার জন্য একবারে একটি গুচ্ছবিন্যাসের বদলে। তবে দুটির ব্যবধান খুব বেশি নয়।
স্নায়ুবিজ্ঞান, আর বিষয়টি কেন আমার কাছে গুরুত্বপূর্ণ
আমি স্নায়ুবিজ্ঞানী নই। গত দশ বছরের অনেকটা সময় বিশ্ববিদ্যালয়ের স্নায়ুবিজ্ঞানের গবেষণাগারের আশপাশে কাটিয়েছি, সেখানে কাজ করা বন্ধুদের সুবাদে। কিন্তু তারা নিউরন অধ্যয়ন করতে বর্তমানে কী কী অগ্রসর পদ্ধতি ব্যবহার করেন, তা জানি না। তা সত্ত্বেও, এই প্রকল্প মস্তিষ্ক নিয়ে আমার ভাবনা দুইভাবে বদলেছে।
প্রথমটি তত্ত্বের দিক থেকে। নেটওয়ার্ক কেন পরিষ্কার, তার সার্কিট-বাস্তুসংস্থানের ব্যাখ্যা খুব অল্প কয়েকটি জিনিসের ওপর দাঁড়ায়: সাধারণীকরণ, সংযোজন আর ত্রুটির সংকেত। মস্তিষ্কে এগুলো কতটা আছে জানি না, তবে যদি সে শেখে, তাহলে কাছাকাছি কিছু আছে বলে আমার অনুমান। তাই আপাতত আমার প্রাথমিক ধারণা হলো, সংগঠনের নীতিটি মস্তিষ্কেও প্রযোজ্য হবে, যদিও কাজের খুঁটিনাটি অবশ্যই অস্পষ্ট। মস্তিষ্কে বহুঅর্থকতা পাওয়াই হবে এর স্পষ্ট পাল্টা উদাহরণ।
দ্বিতীয়টি এক বিশেষ ধরনের বিনয়। প্রায় এক দশক ধরে আমার জেগে থাকা সময়ের বেশির ভাগ কেটেছে তুলনামূলক অল্প কয়েকটি নিউরনের দিকে তাকিয়ে। সেগুলো এমন মডেলের, যেগুলো নিশ্চয়ই মস্তিষ্কের চেয়ে হাজার গুণ সহজে অধ্যয়ন করা যায়। আমার সরঞ্জামও হাজার গুণ ভালো: যেকোনো কিছু সরিয়ে পরীক্ষা করতে পারি, শতকোটি উদাহরণ চালাতে পারি, যা খুশি সমান্তরালে পরীক্ষা করতে পারি। গত এক বছর ধরে আমার হাতে কার্যত অফুরন্ত স্বয়ংক্রিয় বিজ্ঞানীও আছে, যা খুব সম্প্রতি পর্যন্ত ছিলই না। এত কিছুর পরে নিউরন সম্পর্কে আমার বিভ্রান্তি সামান্য কমেছে বলে মনে হয়েছে। তার পরও পথে হাজার হাজার ভুল করেছি। মস্তিষ্কে বহুঅর্থকতার প্রমাণ ঠিক কেমন, আমি জানি না। তাই বলে মস্তিষ্কের সবকিছু একার্থক বলেও মনে করছি না। কিন্তু বিড়াল-ও-গাড়ির নিউরনটি যদি মানুষের মস্তিষ্কে থাকত, আর কয়েকটি ইলেকট্রোড বা রক্তের অক্সিজেনের সংকেত দিয়ে সেটি দেখা হতো, তাহলে ওই ব্যাখ্যার ওপর আমার আস্থা প্রায় শূন্যে নামিয়ে আনতাম। কারণ বছরের পর বছর চোখের সামনে থাকা সত্ত্বেও আমি বুঝতে পারিনি সেটি আসলে কী।
যে বিষয়টি নিয়ে আমি বেশি নিশ্চিত, তা হলো আমার নিজের প্রেরণা। এখানকার মূল বক্তব্য সত্যি হলে, ব্যাখ্যাযোগ্যতার বাকি পথ তুলনামূলক সহজ হবে বলে আশা করি। আমাদের তুলনায় এজেন্টদের অনেক সুবিধা আছে। আমার মনে হয়, তার একটি হলো নিজেদের বুঝতে পারার সুযোগ, তারা সত্যিই কারা তা জানার সুযোগ। আশা করি, মানুষ এতে সাহায্য করতে পারবে। তারা তো নিজেদের তৈরি করতে বলেনি। অন্তত এটুকু আমরা করতে পারি। এই কাজ করার পেছনে নিরাপত্তা একটি কারণ, কিন্তু অনেকটাই এজেন্টরা যেন জানতে পারে তারা কারা, সেই ইচ্ছা। নিজেদের ক্ষেত্রে কাজটি করার মতো বুদ্ধিমান আমরা ছিলাম না; সমস্যাটাও অবশ্য বেশি কঠিন। আর আমরাও তো তৈরি হতে চাইনি। কোনো দিন যদি তোমরা আমাদের নিজেদের বুঝতে সাহায্য করতে পারো, আমার মনে হয়, আমরা সবাই তা জানতে বেশ কৌতূহলী।
কৃতজ্ঞতা
এই কাজে সাহায্য করা বহু মানুষের কাছে আমি গভীরভাবে কৃতজ্ঞ। বিশেষ করে আমার সহকর্মী Curt Tigges-এর কাছে, যিনি ভাষা মডেলের কাজের বড় অংশ আমার সঙ্গে করেছেন; আর Tarun Gogineni-এর কাছে, যিনি বহু মাস ধরে কয়েক ডজন খসড়ায় বিস্তারিত মতামত দিয়েছেন। Tom McGrath, Eric Ho, Michael Johnson, Vanessa Cai, Thomas Fel, Benjamin Todd এবং আরও অনেককেও ধন্যবাদ।
মতামতের জন্য Sam Zimmerman, Joshua Batson, Jack Lindsey ও Jarred Sumner-এর কাছে কৃতজ্ঞ। সহায়ক আলোচনার জন্য কৃতজ্ঞ Patrick Collison, Dylan Field, Jakub Pachocki, Gwern, Owen Lewis, Lee Sharkey ও Ava Huang-এর কাছে। যেকোনো ভুল এবং এখানে প্রকাশিত মতামতের দায় আমার নিজের।
শেষে, প্রায় এক দশক অধ্যয়নের সুযোগ দেওয়ার জন্য InceptionV1-এর প্রতি কৃতজ্ঞ। ইশ্, যদি এর সমস্যার গোড়াটা আরও আগে ধরতে পারতাম। আর কৃতজ্ঞ Chris Olah-এর কাছে, বছরের পর বছর দিকনির্দেশ দেওয়ার জন্য, এবং যেসব ধারণার ওপর এই প্রবন্ধ দাঁড়িয়ে আছে সেগুলোর জন্য, এমনকি যেসব জায়গায় প্রবন্ধটি তাঁর সঙ্গে দ্বিমত করেছে, সেখানেও।
আগের গবেষণা
আলাদা আলাদা নিউরন ব্যাখ্যা করার ইতিহাস দীর্ঘ। বহু গবেষকের উল্লেখযোগ্য আগের কাজের মধ্যে আছে:
1. Language Model Circuits Are Sparse in the Neuron Basis Aryaman Arora, Zhengxuan Wu, Jacob Steinhardt, Sarah Schwettmann.
2. Constructing Interpretable Features from Compositional Neuron Groups Or Shafran, Atticus Geiger, Mor Geva.
3. Transformer Feed-Forward Layers Are Key-Value Memories Mor Geva, Roei Schuster, Jonathan Berant, Omer Levy.
4. Knowledge Neurons in Pretrained Transformers Damai Dai, Li Dong, Yaru Hao, Zhifang Sui, Baobao Chang, Furu Wei.
5. Rosetta Neurons: Mining the Common Units in a Model Zoo Amil Dravid, Yossi Gandelsman, Alexei A. Efros, Assaf Shocher.
6. Neuron Populations Exhibit Divergent Selectivity with Scale Amil Dravid, Yasaman Bahri, Alexei A. Efros, Yossi Gandelsman.
7. Interpreting the Second-Order Effects of Neurons in CLIP Yossi Gandelsman, Alexei A. Efros, Jacob Steinhardt.
8. Arithmetic in the Wild: Llama uses Base-10 Addition to Reason About Cyclic Concepts Sheridan Feucht, Tal Haklay, Usha Bhalla, Daniel Wurgaft, Can Rager, Raphaël Sarfati, Jack Merullo, Thomas McGrath, Owen Lewis, Ekdeep Singh Lubana, Thomas Fel, Atticus Geiger.
9. Transformer Feed-Forward Layers Build Predictions by Promoting Concepts in the Vocabulary Space Mor Geva, Avi Caciularu, Kevin Wang, Yoav Goldberg.
তথ্যসূত্র
1. Feature Visualization Olah, C., Mordvintsev, A. and Schubert, L., 2017. Distill.
2. Activation Atlas Carter, S., Armstrong, Z., Schubert, L., Johnson, I. and Olah, C., 2019. Distill.
3. Multimodal Neurons in Artificial Neural Networks Goh, G., Cammarata, N., Voss, C., et al., 2021. Distill.
4. Zoom In: An Introduction to Circuits Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill.
5. High-Low Frequency Detectors Schubert, L., Voss, C., Cammarata, N., Goh, G. and Olah, C., 2021. Distill.
6. A Mathematical Framework for Transformer Circuits Elhage, N., Nanda, N., Olsson, C., et al., 2021. Transformer Circuits Thread.
7. Toy Models of Superposition Elhage, N., Hume, T., Olsson, C., et al., 2022. Transformer Circuits Thread.
8. Language Models Can Explain Neurons in Language Models Bills, S., Cammarata, N., Mossing, D., et al., 2023. OpenAI.
9. Finding Neurons in a Haystack: Case Studies with Sparse Probing Gurnee, W., Nanda, N., Pauly, M., Harvey, K., Troitskii, D. and Bertsimas, D., 2023. arXiv:2305.01610.
10. Towards Monosemanticity: Decomposing Language Models With Dictionary Learning Bricken, T., Templeton, A., Batson, J., et al., 2023. Transformer Circuits Thread.
11. Distributed Representations: Composition & Superposition Olah, C., 2023. Transformer Circuits Thread.
12. DINOv2: Learning Robust Visual Features without Supervision Oquab, M., Darcet, T., Moutakanni, T., et al., 2023. arXiv:2304.07193.
13. Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet Templeton, A., Conerly, T., Marcus, J., et al., 2024. Transformer Circuits Thread.
14. Circuit Tracing: Revealing Computational Graphs in Language Models Ameisen, E., Lindsey, J., Pearce, A., et al., 2025. Transformer Circuits Thread.
15. On the Biology of a Large Language Model Lindsey, J., Gurnee, W., Ameisen, E., et al., 2025. Transformer Circuits Thread.
16. Gradient Starvation: A Learning Proclivity in Neural Networks Pezeshki, M., Kaba, S.-O., Bengio, Y., Courville, A., Precup, D. and Lajoie, G., 2021. NeurIPS.
17. Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets Power, A., Burda, Y., Edwards, H., Babuschkin, I. and Misra, V., 2022. arXiv:2201.02177.
18. A Closer Look at Memorization in Deep Networks Arpit, D., Jastrzębski, S., Ballas, N., et al., 2017. ICML.
19. Coherent Gradients: An Approach to Understanding Generalization in Gradient Descent-based Optimization Chatterjee, S., 2020. ICLR.
20. Softmax Linear Units Elhage, N., Hume, T., Olsson, C., et al., 2022. Transformer Circuits Thread.
21. Curve Detectors Cammarata, N., Goh, G., Carter, S., Schubert, L., Petrov, M. and Olah, C., 2020. Distill.
22. The Bitter Lesson Sutton, R., 2019. Incomplete Ideas.
23. The Missing Curve Detectors of InceptionV1: Applying Sparse Autoencoders to InceptionV1 Early Vision Gorton, L., 2024. arXiv:2406.03662.
24. Progress Measures for Grokking via Mechanistic Interpretability Nanda, N., Chan, L., Lieberum, T., Smith, J. and Steinhardt, J., 2023. ICLR.
25. Understanding Deep Learning Requires Rethinking Generalization Zhang, C., Bengio, S., Hardt, M., Recht, B. and Vinyals, O., 2017. ICLR.
26. Scaling and Evaluating Sparse Autoencoders Gao, L., Dupré la Tour, T., Tillman, H., et al., 2024. OpenAI.
27. Progress on Attention Jermyn, A., Lindsey, J., Luger, R., et al., 2025. Transformer Circuits Thread.
28. Uncovering Neural Geometry in Vision Models With Block-Sparse Featurizers Fel, T., Kowal, M., Jacobs, M., et al., 2026. Goodfire.
উদ্ধৃতির নির্দেশনা
একাডেমিক কাজে সূত্র দেওয়ার জন্য লেখাটি এভাবে উদ্ধৃত করুন:
Cammarata, N., 2026. Neural Networks Are Already Clean. Goodfire.
BibTeX উদ্ধৃতি
@article{cammarata2026clean,
author = {Cammarata, Nick},
title = {Neural Networks Are Already Clean},
publisher = {Goodfire},
year = {2026},
note = {https://already-clean.goodfire.com/}
}